
Auf dieser Seite
Wählen Sie eine Kafka-Partitionsstrategie, indem Sie die Partitionierungslogik an Ihre Anforderungen an Reihenfolge und Durchsatz anpassen: Key-basierte Partitionierung, wenn zusammengehörige Nachrichten in der richtigen Reihenfolge ankommen müssen, den standardmäßigen Sticky Partitioner, wenn gleichmäßige Last wichtiger ist als die Nachrichtenreihenfolge, und einen eigenen Partitioner nur dann, wenn Sie Routing-Regeln haben, die keines von beidem abbilden kann. Dimensionieren Sie die Partitionsanzahl anschließend anhand des gemessenen Durchsatzes – Zieldurchsatz des Topics geteilt durch den Durchsatz pro Partition, aufgerundet und mit 2- bis 3-facher Reserve –, denn die Consumer-Parallelität ist durch die Anzahl der Partitionen gedeckelt, und eine spätere Reduzierung ist praktisch unmöglich.
Hinter dieser Antwort in zwei Sätzen steckt viel betrieblicher Schmerz. Die falsche Partitionsstrategie gehört zu den teuersten Fehlern, die Teams mit Apache Kafka machen, denn das Partitionslayout eines Topics ist praktisch unveränderlich, sobald echter Traffic darüber läuft. Dieser Leitfaden zeigt, wie Kafka die Partition für jede Nachricht wählt, wie Sie die Partitionsanzahl berechnen, wie die Partitionszuweisung an Consumer funktioniert und wie Sie Hot Partitions beheben, bevor sie einen Cluster lahmlegen.
Was ist eine Kafka-Partitionsstrategie?
Eine Kafka-Partitionsstrategie ist die Gesamtheit der Entscheidungen darüber, wie Daten innerhalb eines Topics auf Partitionen verteilt werden: wie viele Partitionen das Kafka-Topic bekommt, welchen Partition Key (falls überhaupt) die Producer verwenden und welcher Partitioner-Algorithmus jeden Record einer bestimmten Partition zuordnet. Jede Partition in Apache Kafka ist ein geordnetes Append-only-Log, und Kafka garantiert die Reihenfolge nur innerhalb einer Partition – niemals partitionsübergreifend. Diese eine Einschränkung bestimmt fast jede der folgenden Entscheidungen.
Partitionen gibt es, damit Kafka Data Streaming horizontal skalieren kann. Verteilt auf mehrere Broker, kann ein Kafka-Cluster Datenmengen aufnehmen, die keine einzelne Maschine bewältigen könnte, und eine Consumer Group kann die Verarbeitung aufteilen, wobei jeder Consumer eine Teilmenge der Partitionen übernimmt. Kurz gesagt: Partitionen sind die Einheit für Parallelität, Reihenfolge und Lastverteilung im Kafka-Cluster – und deshalb verdient die Wahl der Partitionierungsstrategie echte Designzeit, bevor das erste Byte produziert wird.
Wie Kafka bestimmt, welche Partition eine Nachricht erhält
Die Partition bestimmen die Producer, nicht die Broker. Wenn Sie einen Record senden, läuft der Partitioner des Producers clientseitig und entscheidet, wo er landet. Drei Partitionierungsstrategien in Kafka sollten Sie kennen.
Key-basierte Partitionierung (Standard bei vorhandenem Key)
Hat ein Record einen Key ungleich null, bestimmt Kafka die Partition mit murmur2(key) % numPartitions. Nachrichten mit demselben Key landen immer in derselben Partition, wodurch die Reihenfolge für diesen Key erhalten bleibt: Alle Events für customer-42 landen im selben Log, in der richtigen Reihenfolge. Das ist die richtige Strategie, wann immer zusammengehörige Nachrichten sequenziell verarbeitet werden müssen – Bestell-Lebenszyklen, Kontostände, Session-Events und alles, was in Kafka Streams in Joins und Aggregationen einfließt, denn diese erfordern co-partitionierte Input-Topics.
Der Haken: Ihre Partitionsverteilung ist nur so gut wie die Kardinalität Ihrer Keys. Wählen Sie Partition Keys mit wenigen unterschiedlichen Werten (Ländercode, Bestellstatus), bündelt sich der Traffic auf einer Handvoll Partitionen, während der Rest leer läuft.
Round-Robin- und Sticky-Partitionierung (Null-Key)
Bei einem Null-Key verteilen ältere Clients die Records per Round Robin, einen Record nach dem anderen, reihum auf die Partitionen. Seit Kafka 2.4 (KIP-480) ist für Records ohne Key der Sticky Partitioner die Standardstrategie: Er füllt einen Batch für eine Partition und wechselt dann. So bleiben die Records gleichmäßig auf die Partitionen verteilt, es entstehen aber deutlich weniger und größere Batches – mit geringerer Latenz und besserer Kompression als bei reinem Round Robin. Verwenden Sie Null-Keys, wenn Sie keine Reihenfolge pro Key brauchen und einfach maximalen, gleichmäßig verteilten Durchsatz wollen.
Eigene Partitioner
Wenn Sie das Interface Partitioner implementieren, steuern Sie die Partitionsstrategie direkt. Teams nutzen eigene Partitioner, um Nachrichten mit hoher Priorität an Partition 0 zu leiten, während Massen-Traffic sich auf Partition 1 und höher verteilt, um einen Mandanten an einen Partitionsbereich zu binden oder um auf ein Feld im Payload zu hashen. Die Partition pro Record explizit im ProducerRecord anzugeben, erreicht dasselbe ad hoc. Beides sind scharfe Werkzeuge: Ein eigener Partitioner, der Änderungen der Partitionsanzahl ignoriert oder die Last ungleich verteilt, sabotiert das Topic unbemerkt. Testen Sie ihn gegen die Semantik der offiziellen Kafka-Dokumentation, bevor er in Produktion geht.
Wie viele Partitionen? Die Berechnung
Die meistzitierte Formel für die Partitionsanzahl stammt von Confluent: Bei einem Zieldurchsatz T, einem gemessenen Producer-Durchsatz pro Partition P und einem Durchsatz pro Consumer C brauchen Sie mindestens:
partitions = max(T / P, T / C)
Angenommen, Sie brauchen 100 MB/s durch das Topic, eine einzelne Partition schafft auf Ihrer Hardware dauerhaft 25 MB/s, und ein Consumer verarbeitet 10 MB/s, nachdem er echte Arbeit erledigt hat (Deserialisierung, Anreicherung, Datenbank-Writes). Dann ergibt max(100/25, 100/10) = 10 als Mindestanzahl an Partitionen. In der Praxis dominiert die Consumer-Seite, weil Consumer aufwendigere Verarbeitung leisten als der Append-only-Pfad im Broker. Benchmarken Sie beide Werte auf Ihrer eigenen Kafka-Infrastruktur – Nachrichtengröße, Kompression, Replikationsfaktor und acks verändern den Durchsatz pro Partition erheblich.
Dann kommt die Reserve hinzu. Die Partitionsanzahl dimensionieren Sie nach der prognostizierten Spitzenlast, nicht nach dem heutigen Durchschnitt, denn eine spätere Erhöhung bricht die Reihenfolge pro Key (mehr dazu unten). Eine verbreitete Best Practice ist das 2- bis 3-Fache des berechneten Minimums, gerundet auf eine Zahl, die durch die wahrscheinlichen Consumer-Anzahlen teilbar ist (12, 24, 30), damit sich die Partitionen gleichmäßig auf die Kafka-Consumer verteilen.
Kurzreferenz zur Partitionsdimensionierung
| Zieldurchsatz | Producer-Limit pro Partition | Limit pro Consumer | Minimum | Empfohlen (mit Reserve) |
|---|---|---|---|---|
| 10 MB/s | 25 MB/s | 10 MB/s | 1 | 6–12 |
| 50 MB/s | 25 MB/s | 10 MB/s | 5 | 12–15 |
| 100 MB/s | 25 MB/s | 10 MB/s | 10 | 24–30 |
| 500 MB/s | 25 MB/s | 10 MB/s | 50 | 100–120 |
| 1 GB/s | 25 MB/s | 10 MB/s | 100 | 200–240 |
Zu wenige Partitionen deckeln Durchsatz und Consumer-Parallelität. Zu viele Partitionen kosten aber ebenfalls: mehr offene File Handles und Speicher auf jedem Broker, längere Leader Elections, mehr Replikations-Traffic und langsamere Rebalances. Ein Topic mit 10-mal mehr Partitionen, als es je brauchen wird, ist technische Schuld, die Sie bei jedem Failover abbezahlen.
Consumer Groups, Parallelität und Partitionszuweisung
Die Partitionsanzahl ist eine harte Obergrenze für die Leseparallelität. Innerhalb einer Consumer Group wird jede Partition genau einem Consumer zugewiesen; ein Topic mit 12 Partitionen unterstützt also höchstens 12 aktive Consumer – der 13. bleibt untätig. Wenn die Zahl der Consumer, die Sie jemals brauchen werden, Ihre Partitionsanzahl übersteigt, hilft auch keine horizontale Skalierung. Deshalb planen Sie die Partitionsanzahl anhand der nachgelagerten Parallelität, nicht nur anhand der Broker-Kapazität.
Die Partitionszuweisung an Consumer erfolgt über austauschbare Assignment-Strategien: Range (der historische Standard, anfällig für Ungleichgewichte über mehrere Topics), Round Robin, Sticky und der moderne CooperativeStickyAssignor. Die kooperative Variante ist betrieblich entscheidend: Das klassische Eager Rebalancing ist Stop-the-World – jeder Consumer hält an, gibt seine Partitionen ab und tritt neu bei –, und bei großen Gruppen erzeugt diese Pause Spitzen beim Consumer Lag und Timeouts in nachgelagerten Systemen. Cooperative Rebalancing verschiebt nur die Partitionen, die sich wirklich bewegen müssen. Wenn Sie Kafka 2.4+ betreiben und noch nicht umgestellt haben, ist diese eine Konfigurationsänderung oft der günstigste Latenzgewinn, den es gibt.
In Rebalance-Stürmen zeigen sich Probleme mit der Partitionsstrategie gern um 3 Uhr nachts: Ein langsamer Consumer verpasst seine Poll-Deadline, löst einen Rebalance aus, der Lag wächst, weitere Consumer laufen in Timeouts, und die Gruppe kommt nicht mehr zur Ruhe. Wenn Ihr Team gerade gegen Rebalance-Schleifen oder unerklärlichen Consumer Lag ankämpft, setzt der 24/7-Kafka-Support von AceMQ einen erfahrenen Kafka-Engineer mit Reaktionszeitzielen ab 15 Minuten, je nach Plan, auf Ihren Incident an – der Unterschied zwischen einem kurzen Aussetzer und einem stundenlangen Ausfall.
Hot Partitions: Ursachen und Lösungen
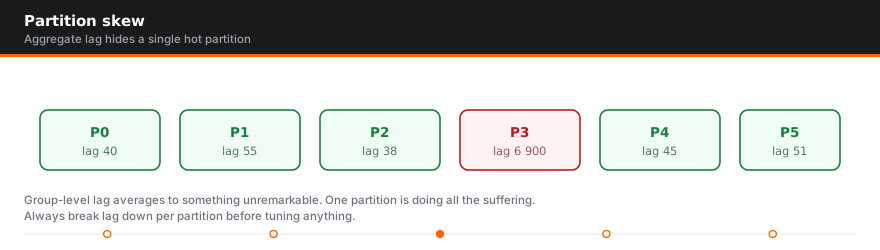
Eine Hot Partition erhält einen überproportionalen Anteil des Traffics – das klassische Fehlerbild der Key-basierten Partitionierung. Häufige Ursachen:
- Keys mit geringer Kardinalität – wer auf
countryhasht, obwohl 60 % des Traffics aus einem Land kommen, schickt die meisten Records in eine einzige Partition. - Prominenten-Keys – ein Mandant, ein Gerät oder ein Nutzer erzeugt um Größenordnungen mehr Events als der Rest, und alle landen in derselben Partition.
- Ungleich verteilende eigene Partitioner – selbst gebautes Routing, das die Last auf Partition 0 oder einen kleinen Bereich konzentriert.
Die Symptome: Ein Broker läuft heiß, während andere sich langweilen, ein Consumer hängt hinterher, während seine Kollegen aufgeholt haben, und die Produce-Latenz steigt für einen Teil der Keys. So beheben Sie eine Hot Partition:
- Auf höhere Kardinalität umschlüsseln. Verwenden Sie
userIdstattregionoder einen zusammengesetzten Key wietenantId:deviceId, damit das Hashing die Last für jede Entität auf eine passende Partition verteilt. - Die heißen Keys salzen. Hängen Sie ein kleines zufälliges Suffix an (
bigTenant-0…bigTenant-7), um einen heißen Key auf mehrere Partitionen aufzufächern – mit der Folge, dass Sie nun wieder aggregieren müssen, weil die Reihenfolge nur noch pro gesalzenem Key gilt. - Den Wal abspalten. Leiten Sie Ihren größten Mandanten in ein eigenes Topic mit eigener Partitionsstrategie, das allein auf seinen Traffic dimensioniert ist.
- Den Key ganz weglassen, wo die Reihenfolge eigentlich gar nicht nötig ist – viele Pipelines verwenden Keys aus Gewohnheit und zahlen einen Ungleichgewichts-Aufschlag für eine Garantie, die niemand nutzt. Der Sticky Partitioner verteilt Traffic ohne Keys nahezu perfekt.
Überwachen Sie den Zustand der Partitionen, bevor Ihre Nutzer etwas merken: Produce-Rate und Log-Größe pro Partition (Bytes-in-Ungleichgewicht), Consumer Lag pro Partition und Ungleichgewichte bei Disk und Netzwerk der Broker. Ein Alert auf ungleich verteilten Partitionsdurchsatz – etwa jede Partition, die dauerhaft das 3-Fache des Topic-Medians erreicht – fängt die meisten Hot-Partition-Incidents ab, solange sie noch günstig zu beheben sind.
Warum Repartitionierung wehtut (planen Sie voraus)
Mit kafka-topics.sh --alter können Sie die Anzahl der Partitionen eines laufenden Kafka-Topics erhöhen, aber niemals verringern. Und eine Erhöhung ist nicht die harmlose Lösung, nach der sie aussieht: hash(key) % numPartitions ändert sich in dem Moment, in dem sich die Anzahl ändert, sodass bestehende Keys auf eine andere Partition abgebildet werden. Alte Events für customer-42 liegen in Partition 3, während neue in Partition 7 landen. Die Nachrichtenreihenfolge für diese Keys bricht an der Nahtstelle, und jeder Kafka-Streams-State, der aus diesem Topic aufgebaut wurde, muss neu aufgebaut oder migriert werden.
Die ehrliche Lösung für ein schlecht partitioniertes Topic mit Keys ist eine vollständige Migration: ein neues Topic mit der richtigen Anzahl anlegen, die Daten spiegeln, die Consumer umstellen und das Original stilllegen. Auf einem stark ausgelasteten Produktions-Cluster sind das Tage sorgfältiger Arbeit – und genau deshalb ist eine durchdachte Kafka-Partitionsplanung im Voraus, mit Reserve, das 10-Fache des Aufwands für die Aufräumarbeiten wert.
KRaft und Partitionsgrenzen: was KIP-500 geändert hat
Die alte, ZooKeeper-basierte Control Plane von Kafka setzte der clusterweiten Partitionsanzahl eine praktische Obergrenze – häufig mit rund 200.000 Partitionen beziffert –, weil Controller-Failover und Metadatenverteilung darüber hinaus fast zum Stillstand kamen. KIP-500 hat ZooKeeper durch KRaft ersetzt, ein integriertes, Raft-basiertes Metadaten-Quorum, und seit Kafka 4.0 ist das der einzige unterstützte Modus. KRaft speichert Metadaten in einem internen Event-Log, sodass ein neuer Controller in nahezu konstanter Zeit übernimmt und Cluster auf Millionen von Partitionen skalieren.
Was KRaft nicht ändert: die Berechnung pro Topic, Hot Partitions, die Semantik der Reihenfolge oder den Schmerz der Repartitionierung. KRaft hebt die Obergrenze für das Partitionsmanagement in Kafka auf Cluster-Ebene an; die Strategie für jedes einzelne Topic wird dadurch kein bisschen weniger folgenreich. Im Gegenteil: Die Migration eines alten ZooKeeper-Clusters auf KRaft ist selbst ein Projekt, bei dem es teuer wird, Fehler im Partitionslayout mitzuschleppen.
Best Practices für die Kafka-Partitionsstrategie
- Benchmarken Sie den realen Durchsatz pro Partition auf Ihren eigenen Kafka-Brokern; übernehmen Sie nicht die Zahlen anderer.
- Dimensionieren Sie die Partitionsanzahl mit
max(T/P, T/C)plus 2- bis 3-facher Reserve, teilbar durch die erwartete Anzahl an Consumern. - Setzen Sie Keys nur ein, wenn Sie eine Reihenfolge pro Key brauchen; andernfalls überlassen Sie Records ohne Key dem Sticky Partitioner für maximale Ausgewogenheit.
- Halten Sie die Kardinalität der Keys mindestens beim 10- bis 100-Fachen der Partitionsanzahl, damit die Verteilung gleichmäßig bleibt.
- Verwenden Sie
CooperativeStickyAssignor, um Rebalance-Pausen zu verkürzen. - Überwachen Sie Lag auf Partitionsebene, Bytes-in-Ungleichgewicht und Broker-Ungleichgewicht – und alarmieren Sie auf Ungleichgewichte, nicht nur auf Summen.
- Dokumentieren Sie Ihre Partitionsstrategie pro Topic, damit der nächste Engineer eine bewusste Entscheidung nicht „repariert“.
Das richtig hinzubekommen, ist ein Designproblem; es um 2 Uhr nachts richtig zu halten, ist ein Betriebsproblem. Die Senior Engineers von AceMQ betreiben und retten jeden Tag produktive Kafka-Umgebungen für Unternehmen – von Reviews der Partitionsstrategie und Kapazitätsplanung bis zur Notfallreaktion mit Reaktionszeitzielen ab 15 Minuten, je nach Plan, rund um die Uhr. Entdecken Sie die Enterprise-Kafka-Services von AceMQ oder sprechen Sie mit uns über eine 24/7-Abdeckung für Ihren Cluster. Für eine zweite Meinung zur Partitionsanzahl prüft ein Kafka Health Check sie.
Dies ist Schritt zwei von zehn im Leitfaden für den Kafka-Betrieb, der die betrieblichen Entscheidungen in der Reihenfolge behandelt, in der sie in einer Produktionsumgebung anstehen.
Häufig gestellte Fragen
Kann ich die Anzahl der Partitionen nach dem Anlegen eines Topics ändern?
Sie können sie nur erhöhen, niemals verringern. Eine Erhöhung ändert die Zuordnung hash(key) % numPartitions, sodass Records mit demselben Key plötzlich auf einer anderen Partition landen als ihre Historie – die Reihenfolge pro Key bricht an dieser Übergangsstelle. Bei Topics mit Keys ist die sichere Lösung die Migration auf ein neues, richtig dimensioniertes Topic.
Wie entscheidet Kafka, in welche Partition eine Nachricht geht?
Das entscheidet der Producer, und zwar clientseitig. Hat ein Record einen Key, verwendet Kafka einen murmur2-Hash des Keys modulo der Partitionsanzahl. Ohne Key füllt der Sticky Partitioner Batches jeweils für eine Partition und sorgt insgesamt für eine ausgeglichene Verteilung. Producer können das auch übersteuern, indem sie einen eigenen Partitioner implementieren oder die Partition explizit am Record setzen.
Was verursacht eine Hot Partition, und wie behebe ich sie schnell?
Die übliche Ursache sind Keys mit geringer Kardinalität oder stark ungleich verteilte Keys: Zu viel Traffic wird auf eine einzige Partition gehasht und überlastet deren Broker und Consumer. Sofortmaßnahmen sind, den heißen Key per Salting auf mehrere Partitionen zu verteilen, auf ein Feld mit höherer Kardinalität umzuschlüsseln oder den Mandanten mit der größten Last in ein eigenes Topic auszulagern.
Ab wann sind es zu viele Partitionen?
Eine allgemeingültige Zahl gibt es nicht, aber jede Partition kostet Broker-Speicher, File Handles, Replikationsaufwand und Rebalance-Zeit. Pro Broker im niedrigen vierstelligen Bereich zu bleiben, ist eine weit verbreitete Faustregel. Der KRaft-Modus hebt die clusterweiten Grenzen drastisch an, doch eine Überdimensionierung pro Topic über das ca. 3-Fache des prognostizierten Spitzendurchsatzes hinaus kostet meist mehr, als sie schützt.
Begrenzt die Partitionsanzahl, wie viele Consumer ich betreiben kann?
Ja. Innerhalb einer Consumer Group geht jede Partition an genau einen Consumer (ein Consumer kann aber mehrere Partitionen lesen); Consumer über die Partitionsanzahl hinaus bleiben untätig. Ihre maximale Leseparallelität entspricht Ihrer Partitionsanzahl – deshalb sollte in der Regel der Consumer-Durchsatz und nicht die Broker-Kapazität die Dimensionierung bestimmen.

Autor
Leitfäden, Vergleiche und Studien
Mehr zum Thema Kafka
Leitfäden
4Vergleiche
9- NATS vs Kafka 2026: Core NATS, JetStream und Kafka im Vergleich
- Mosquitto vs. Kafka: MQTT-Broker oder Event Log?
- Kafka vs. Kinesis im Vergleich
- Die besten Managed-Kafka-Anbieter 2026 jenseits der Hyperscaler
- Kafka-BYOC-Optionen (Bring Your Own Cloud) im Vergleich
- Alternativen zu Confluent und Wettbewerber nach der IBM-Übernahme


