Auf dieser Seite
RabbitMQ Streams ist ein Queue-Typ, der Nachrichten in einem replizierten Append-only-Log speichert. So können viele Consumer dieselbe Historie unabhängig voneinander lesen und ab jedem beliebigen Offset per Replay erneut abrufen. Streams laufen innerhalb eines RabbitMQ-Brokers, der Routing und Replay an einem Ort vereint; Apache Kafka ist die eigenständige Plattform für sehr hohe Dauervolumen und lange Retention. Dieser Leitfaden zeigt, wie RabbitMQ Streams funktionieren, wie schnell sie sind, wie Sie sie tunen und wo Kafka die bessere Wahl ist.
Kurz gesagt: Wenn Sie RabbitMQ bereits betreiben und Replay benötigen, sind RabbitMQ Streams sehr wahrscheinlich die Antwort. Wenn Sie Hunderttausende Nachrichten pro Sekunde aufnehmen und wochenlang vorhalten, ist es Kafka. Für die übergreifende Entscheidung zwischen Queues, Streams und Kafka lesen Sie RabbitMQ vs. Kafka.
Was ein Stream eigentlich ist
Eine Classic Queue in RabbitMQ ist destruktiv: Eine Nachricht wird zugestellt, bestätigt und ist weg. Dieses Modell eignet sich für die Verteilung von Arbeit – ein Consumer nimmt einen Job, erledigt ihn, und er verschwindet.
Ein Stream ist das Gegenteil: ein Append-only-Log auf der Platte. Consumer lesen ab ihrem eigenen Offset, und das Lesen verändert nichts. Zehn unabhängige Anwendungen können also jeweils jede Nachricht lesen und bei Bedarf jederzeit von Anfang an wiederholen.
Dieses nicht-destruktive Modell haben beide Systeme gemeinsam, und nur deshalb werden sie überhaupt verglichen. In allem anderen unterscheiden sie sich.
Wenn Sie sich bereits für Streams entschieden haben und sie betreiben müssen, behandelt der Leitfaden zu RabbitMQ Streams Retention, Offsets, Super Streams, die Verwaltung von Replikaten und was ein Publisher Confirm garantiert – und was nicht.
RabbitMQ Streams vs. Kafka: der architektonische Unterschied
Kafka ist eine verteilte Event-Streaming-Plattform – und diese Bezeichnung ist wörtlich zu nehmen. Ein Kafka-Topic ist in Partitionen aufgeteilt, die über den Cluster verteilt sind; ein Producer schreibt in eine Partition, und jeder Consumer einer Gruppe ist für einige Partitionen zuständig. Parallelität, Reihenfolge und Durchsatz ergeben sich allesamt aus diesem Partitionsmodell.
RabbitMQ ist ein Message Broker, der einen Stream-Queue-Typ hinzugewonnen hat. Derselbe Cluster, der Arbeit über Exchanges und Bindings routet, kann auch Streams halten, erreichbar über AMQP oder ein eigenes binäres Stream-Protokoll. RabbitMQ unterstützt beide Modelle an einem Ort – Sie erweitern einen Broker um eine Fähigkeit, statt eine zweite Plattform einzuführen.
Diese eine strukturelle Tatsache erklärt die meisten der praktischen Unterschiede unten.
RabbitMQ Streams vs. Apache Kafka: die wichtigsten Unterschiede
| RabbitMQ Streams | Apache Kafka | |
|---|---|---|
| Größte Stärke | Routing plus Replay in einem Broker | Volumen und Retention im großen Maßstab |
| Protokoll | AMQP 0-9-1 und 1.0, MQTT sowie ein Stream-Protokoll | Eigenes Binärprotokoll von Kafka |
| Partitionierung | Super Streams | Native Topic-Partitionen |
| Retention | Größen- und Zeitlimits pro Stream | Größe, Zeit oder Compaction pro Topic |
| Reihenfolge | Pro Stream bzw. pro Partition in einem Super Stream | Pro Partition |
| Typisches Volumen | Hoch – Zehntausende pro Sekunde | Sehr hoch – Hunderttausende und mehr |
| Ökosystem | RabbitMQ-Tools und -Clients | Connect, Streams-API, ksqlDB, großes Ökosystem |
| Betriebsaufwand | Ein Broker, vertrautes Modell | Eine eigenständig zu betreibende Plattform |
Nachrichtenverarbeitung, Retention und Reihenfolge
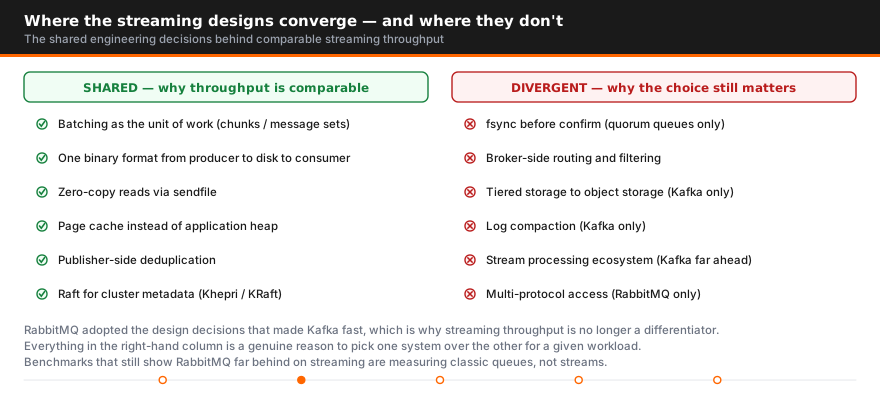
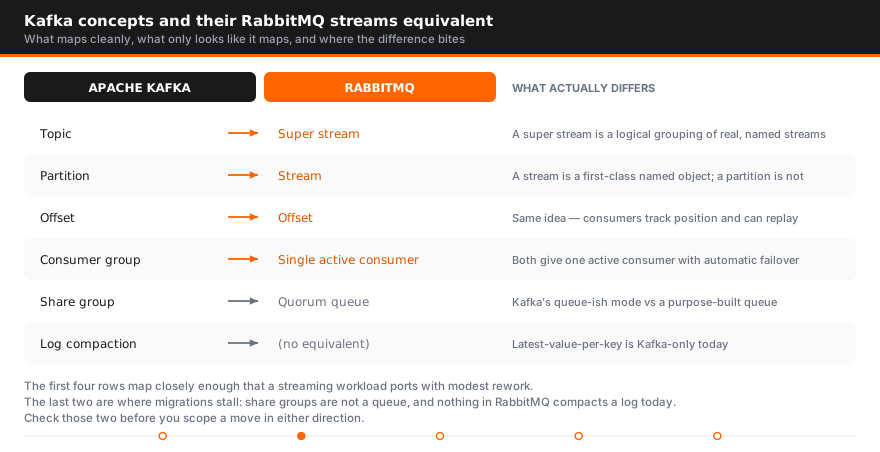
Beide halten Daten auf der Platte vor und lassen Consumer sie erneut abspielen. Ein Kafka-Topic speichert Nachrichten nach zeit- oder größenbasierten Policies oder mit Compaction. Compaction – also nur den jeweils neuesten Wert pro Key zu behalten – ist ein echtes Alleinstellungsmerkmal; RabbitMQ Streams bieten sie nicht.
Die Reihenfolge funktioniert in beiden Systemen gleich: garantiert innerhalb einer Partition, nicht partitionsübergreifend. Wenn eine strikte globale Reihenfolge zählt, brauchen Sie in beiden Systemen eine einzige Partition und geben dafür die Parallelität auf.
Der Unterschied zeigt sich beim Routing. RabbitMQ kann Exchange-Bindings, Topic-Muster und Header anwenden, bevor eine Nachricht überhaupt einen Stream erreicht. Ein Kafka-Producer wählt ein Topic und einen Partition Key; die Routing-Logik liegt in Ihrer Anwendung oder in nachgelagerter Stream-Verarbeitung.
Performance und Skalierbarkeit
Beim Durchsatz gewinnt Kafka klar, und am oberen Ende ist der Abstand real. Ein Kafka-Broker ist auf sequenzielle Schreibvorgänge auf der Platte ausgelegt, und das Partitionsmodell skaliert Schreibvorgänge horizontal auf eine Weise, die ein einzelner Stream nicht leisten kann.
RabbitMQ Streams sind weit schneller als Classic Queues und bewältigen Workloads mit hohem Volumen problemlos – doch ein Super Stream ist Partitionierung, die einem Broker aufgesetzt wurde, dessen Schwerpunkt das Routing ist. Er ist keine Plattform, die von Grund auf für sequenziellen Plattendurchsatz entwickelt wurde.
Bei der Latenz liegen beide näher beieinander als beim Durchsatz. Bei der Latenz pro Nachricht und moderatem Volumen schneidet RabbitMQ häufig besser ab, weil Kafka durch Batching auf Masse statt auf die Geschwindigkeit einzelner Nachrichten optimiert. Lautet Ihre Anforderung „Diese Nachricht muss im einstelligen Millisekundenbereich ankommen“ statt „Wir müssen eine Million Events pro Sekunde aufnehmen“, sollten Sie nicht davon ausgehen, dass Kafka die schnellere Wahl ist.
Benchmarks in beide Richtungen sind mit Vorsicht zu genießen. Herstellerzahlen entstehen unter Bedingungen, die das jeweils verkaufte System gut aussehen lassen. Ihre Nachrichtengröße, Ihre Durability-Einstellungen und Ihr Netzwerk beeinflussen das Ergebnis stärker als die Wahl der Software.
RabbitMQ Streams oder Kafka: Was ist einfacher zu betreiben?
In der Regel RabbitMQ – und das ist ein legitimes Entscheidungskriterium, kein Eingeständnis von Schwäche.
Das Deployment-Modell von RabbitMQ entspricht weitgehend dem, wie die meisten Entwickler ohnehin denken: Producer, Exchanges, Queues, Consumer. RabbitMQ-Broker verhalten sich vorhersehbar. Client-Bibliotheken gibt es für jede Sprache, die Management-UI ist wirklich brauchbar, und ein funktionierender Cluster lässt sich an einem Nachmittag aufsetzen.
Kafka verlangt mehr. Partitionsanzahl, Rebalancing von Consumer Groups, Offset-Management, Retention-Tuning und Replikationseinstellungen wollen vor dem Produktivbetrieb verstanden sein. Der Lohn ist ein System, das weiter skaliert als RabbitMQ – aber die Lernkurve ist real, und
Ehrlich betrachtet: Wählen Sie das System, das Ihr Team um 3 Uhr nachts betreiben kann, nicht das, das einen Benchmark gewinnt.
Können RabbitMQ Streams Kafka ersetzen – oder umgekehrt?
Teilweise, in beide Richtungen – und in beide Richtungen schlecht, wenn man es erzwingt.
Kafka als Ersatz für RabbitMQ stößt überall dort an Grenzen, wo Sie Routing brauchen. Kafka hat kein Pendant zu Exchange-Bindings, TTL pro Nachricht, Priority Queues oder Dead-Letter-Verhalten. Diese nachzubilden heißt, sie im Anwendungscode zu bauen – viel Aufwand, nur um keinen Broker betreiben zu müssen, den Sie bereits verstehen.
RabbitMQ als Ersatz für Kafka stößt bei dauerhaftem Volumen und langer Retention an Grenzen. Wenn Sie einen Monat an Events für die erneute Verarbeitung vorhalten und dabei Hunderttausende Nachrichten pro Sekunde verarbeiten, sind Streams nicht das richtige Werkzeug. Auch die Lücke im Ökosystem zählt: Kafka Streams, Connect und ksqlDB haben kein direktes Gegenstück.
Beide können eine Zeit lang die Aufgabe des anderen übernehmen. Das Scheitern kommt mit der Skalierung oder der Komplexität – also genau dann, wenn eine Migration am schwierigsten ist.
Wann Sie beide einsetzen sollten
Viele ausgereifte Architekturen setzen beide ein, und das ist kein Designfehler.
Ein gängiges Muster: RabbitMQ übernimmt Command and Control – Request/Reply, Aufgabenverteilung, ereignisgesteuerte Microservices, die präzises Routing brauchen –, während Kafka den Event-Strom mit hohem Volumen transportiert, den Analytics und Stream-Verarbeitung konsumieren. Jedes System tut, was es gut kann, verbunden über eine Bridge oder eine Anwendung, die aus dem einen liest und in das andere schreibt.
Der Preis sind zwei Systeme, die betrieben, überwacht und personell besetzt werden müssen. Das lohnt sich, wenn sich die Workloads wirklich unterscheiden – nicht aber, um eine schwierige Diskussion darüber zu vermeiden, auf welches System man standardisiert.
Was sich für Ihren konkreten Use Case eignet
Setzen Sie RabbitMQ ein, wenn:
- Sie RabbitMQ bereits betreiben und Replay oder mehrere unabhängige Leser brauchen
- Routing wichtig ist – Topic-Muster, Header-basiertes Routing, komplexe Topologien
- Sie Queues und Streams brauchen und lieber keine zwei Plattformen betreiben möchten
- die Latenz pro Nachricht wichtiger ist als das Gesamtvolumen
- Ihr Team klein ist und betriebliche Einfachheit echten Wert hat
Setzen Sie Kafka ein, wenn:
- das Aufnahmevolumen wirklich sehr hoch und dauerhaft ist
- Sie lange Retention, Replay über Wochen oder Log Compaction benötigen
- Ihre Streaming-Use-Cases das breitere Ökosystem brauchen – Connect, Streams-API, ksqlDB
- viele unabhängige Teams dieselben Datenströme konsumieren
- Sie die nötige Betriebsexpertise haben oder einstellen werden
Setzen Sie beide ein, wenn Sie unterschiedliche Workloads haben, die jeweils wirklich zu einem System passen, und die betriebliche Kapazität, beide ordentlich zu betreiben.
Auch innerhalb von RabbitMQ sind Streams nicht immer die Antwort
Das sollte klar gesagt werden: Wenn Ihr Workload Aufgabenverteilung statt Event-Replay ist, bleibt eine Quorum Queue die richtige Wahl. Streams bringen Retention und Replay mit, die Sie womöglich nicht brauchen, und sie speichern alles auf der Platte – ein Stream mit Daten, die niemand erneut abspielt, kostet also ohne Nutzen.
Die Entscheidung zwischen Queue und Stream innerhalb von RabbitMQ kommt zuerst und erledigt die Kafka-Frage oft vollständig. Diese Seite der Frage behandelt unser Beitrag zu
Performance von RabbitMQ Streams: was Sie erwarten können
Ein RabbitMQ Stream ist ein Append-only-Log auf der Platte mit genau einem Schreiber, dem Leader-Mitglied. Dieser einzelne Schreiber macht einen Stream schnell: kein Routing pro Nachricht, keine Umwälzungen im Queue-Index, kein Löschen beim Ack. Er ist aber auch die Obergrenze. Der Durchsatz skaliert pro Stream bis zu dem, was ein Leader anhängen und replizieren kann, und darüber hinaus mit der Anzahl der Streams, die über den Cluster verteilt sind. Sie brauchen mehr? Fügen Sie Streams hinzu, keine größere Maschine.
Wie Sie mit dem Stream kommunizieren, ist wichtiger als fast alles andere. Das native Stream-Protokoll auf Port 5552 (das Plug-in rabbitmq_stream) ist ein Binärprotokoll für Logs: Publisher senden Batches in einem Frame, der Broker schreibt Chunks direkt in die Datei, und Consumer lesen diese Chunks per sendfile aus dem Page Cache zurück – fast ohne Aufwand pro Nachricht in Erlang. Der Zugriff über AMQP 0-9-1 auf denselben Stream (x-queue-type: stream) läuft über die reguläre Channel-Mechanik: eine Zustellung pro Nachricht, verpflichtender Prefetch, Acks pro Nachricht. Das ist bequem für bestehenden Code, beim Lesen aber um eine Größenordnung oder mehr langsamer. Mit dem Stream-Protokoll und Batching erreicht ein einzelner Stream auf gewöhnlicher Hardware Hunderttausende Nachrichten pro Sekunde, ein Cluster mit mehreren Streams sogar Millionen. Über AMQP sind Zehntausende pro Sekunde und Stream der realistische Bereich.
Sub-Entry-Batching treibt das native Protokoll noch weiter: Ein Publisher packt viele Nachrichten in einen Eintrag und komprimiert ihn (gzip, snappy, lz4, zstd), und der Broker speichert den Batch als Einheit. Platten- und Replikationskosten fallen so nur einmal pro Batch an. AMQP-Consumer können Sub-Entry-Batches nicht lesen.
Die Replikation erfolgt über einen Leader plus Replikate mit der Log-Replikationsbibliothek Osiris statt über Raft. Ein Publish wird bestätigt, sobald eine Mehrheit der Mitglieder ihn auf die Platte geschrieben hat. Zusätzliche Replikate kosten den Leader ausgehende Bandbreite und addieren die Plattenlatenz des langsamsten Replikats zur Confirm-Zeit; den Lesedurchsatz kosten sie nicht, da Consumer von Replikaten lesen können.
Das Plattenverhalten wird häufig unterschätzt. Schreibvorgänge sind sequenziell und günstig. Lesezugriffe auf aktuelle Daten kommen aus dem Page Cache des Betriebssystems und kosten fast nichts; ein Consumer, der ab letzter Woche erneut liest, geht auf die Platte und konkurriert mit dem Schreiber. Lange Retention plus zurückspulende Consumer brauchen Reserven im Page Cache: RAM für den Kernel, nicht für die Erlang-VM.
Die Retention wird pro Segment durchgesetzt. max-age und max-length-bytes legen das Fenster fest, stream-max-segment-size-bytes (Standard 500 MB) die Granularität, denn der Broker löscht nur ganze Segmente. Beides beeinflusst die Publish-Geschwindigkeit kaum; es bestimmt Plattenverbrauch und Replay-Kosten.
Auch das Offset-Tracking ist nicht kostenlos. Die serverseitige Offset-Speicherung schreibt Tracking-Einträge in den Stream selbst; wer nach jeder Nachricht committet, verdoppelt also ungefähr die Schreiblast eines Consumers. Committen Sie in Intervallen und nehmen Sie beim Neustart einige erneute Zustellungen in Kauf.
So tunen Sie die Performance von RabbitMQ Streams
In der Reihenfolge, in der wir die Hebel ansetzen:
- Nutzen Sie das Stream-Protokoll und einen Stream-Client. Liegt Ihr Hot Path auf AMQP, bringt diese Änderung mehr als alles Folgende zusammen.
- Bündeln Sie auf Publisher-Seite und bestätigen Sie asynchron. Stream-Clients bündeln standardmäßig; erhöhen Sie die Batch-Größe und warten Sie nie auf ein Confirm pro Nachricht.
- Geben Sie Consumern Credit. Das Protokoll ist Credit-basiert: Der Consumer fordert Chunks an, und der Broker sendet, bis der Credit aufgebraucht ist. Halten Sie mehrere Chunks vorrätig.
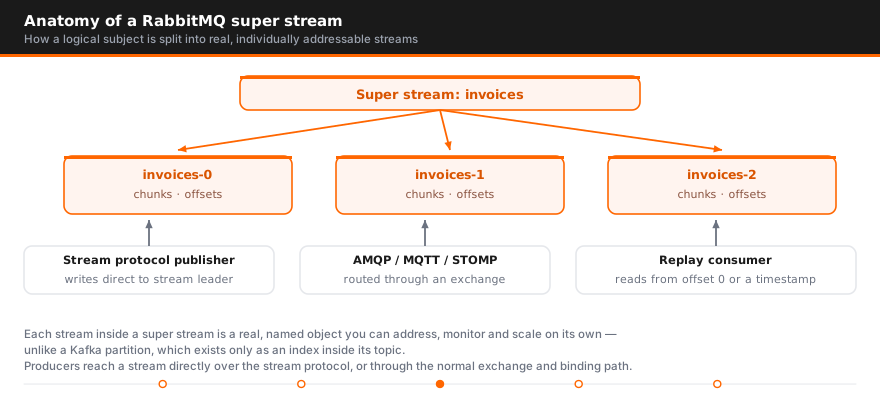
- Teilen Sie mit Super Streams auf. Ein Super Stream ist eine Gruppe von Partitions-Streams unter einem Namen; Publisher wählen die Partition per Routing Key, standardmäßig per Hash. Die Reihenfolge gilt innerhalb einer Partition und nirgendwo sonst. Wählen Sie daher einen Key, der zusammenfasst, was geordnet bleiben muss (Konto, Gerät, Session), und den Rest verteilt. Partitionen erhalten unterschiedliche Leader – so nutzen Sie jeden Node.
- Legen Sie die Replikation bewusst fest.
x-initial-cluster-sizebei der Deklaration steuert die Anzahl der Mitglieder. Drei für alles, was zählt, eins für Ingest-Zwischendaten, die sich erneut abspielen lassen. - Legen Sie Mitglieder auf schnelle lokale Platten. NVMe statt netzwerkgebundener Volumes, und nicht gemeinsam mit den Daten von Quorum Queues.
- Dimensionieren Sie die Retention nach Ihrem Replay-Muster. Kurze Retention, wenn Consumer nahe am Kopf bleiben; moderate Retention und großzügig RAM, wenn sie Stunden zurückspulen. Das Cluster-Sizing selbst behandeln wir in unserer FAQ zu HA- und Disaster-Recovery-Sizing.
- Committen Sie Offsets in Intervallen. Alle paar Sekunden oder alle paar tausend Nachrichten.
- Halten Sie AMQP-Consumer von Streams mit hohem Durchsatz fern. Für ein Dashboard in Ordnung, für den Haupt-Consumer falsch.
- Beobachten Sie die richtigen Metriken. Die Management-UI zeigt pro Stream Publisher, Consumer und den Leader-Node; der Prometheus-Endpunkt exportiert die Zahl der Stream-Verbindungen, Publisher und Consumer sowie Nachrichten- und Byte-Raten auf Queue-Ebene. Der Consumer-Lag ist ein clientseitiger Wert – exportieren Sie ihn also aus der Anwendung.
Eine Retention-Policy sieht so aus:
rabbitmqctl set_policy stream-events "^events\." \
  '{"max-age":"7D","max-length-bytes":50000000000}' --apply-to queues
Die beiden Fehler, die wir am häufigsten sehen: Erstens ein Stream für alles – ein einzelner Leader, gedeckelt auf einem Node, jeder Consumer filtert clientseitig, und ein Replay liest Terabytes, um einen Mandanten zu finden. Partitionieren Sie mit einem Super Stream oder nutzen Sie mehrere Streams. Zweitens einen Stream wie eine Queue zu behandeln: Acks pro Nachricht zu erwarten, konkurrierende Consumer, die sich Arbeit teilen, oder dass Nachrichten nach der Verarbeitung verschwinden. Ein Stream behält alles bis zum Ende der Retention, jeder Consumer liest alles, und Acks gibt es nicht. Verlangt der Workload Queue-Semantik, braucht er eine Quorum oder Classic Queue, keinen Stream.
Wenn Ihre Streams langsamer sind, als sie sein sollten, geht der RabbitMQ-Support Konfiguration und Metriken gemeinsam mit Ihnen durch; die RabbitMQ-Beratung übernimmt das Redesign, wenn die Topologie das Problem ist.
Sprechen Sie mit einem AceMQ-Engineer
Wenn hinter diesem Artikel eher eine Architekturfrage als ein akuter Incident steht – Partitionsstrategie, Sizing, Security-Design, eine Migration –, setzt die Kafka-Beratung von AceMQ einen namentlich zugeordneten Senior Engineer darauf an.
FAQ
Was ist der Unterschied zwischen Kafka und RabbitMQ Streams?
Beide bieten ein Append-only-Log mit Replay. RabbitMQ Streams ist ein Queue-Typ innerhalb eines Message Brokers, der zusätzlich ausgefeiltes Routing beherrscht; Kafka ist eine eigenständige, verteilte Event-Streaming-Plattform für sehr hohen Durchsatz und lange Retention.
Ist RabbitMQ einfacher zu bedienen als Kafka?
In der Regel ja. Das Modell entspricht vertrauten Producer/Consumer-Konzepten, die Management-UI ist übersichtlich, und ein Cluster ist schnell aufgesetzt. Bei Kafka müssen Sie vor dem Produktivbetrieb Partitionen, Consumer Groups, Offsets und Rebalancing verstehen.
Kafka oder RabbitMQ – kann das eine das andere ersetzen?
Für einfaches Pub/Sub oft ja. Für alles, was Routing, TTL pro Nachricht, Prioritäten oder Dead-Lettering braucht, bauen Sie am Ende Broker-Funktionen im Anwendungscode nach.
Können RabbitMQ Streams Kafka ersetzen?
Bei moderaten Volumen mit Replay-Anforderungen ja. Bei sehr hohem Dauerdurchsatz mit langer Retention oder wenn Sie Connect und die Streams-API benötigen, bleibt Kafka die bessere Wahl.
Welches Messaging-System ist leistungsfähiger?
Kafka beim Dauerdurchsatz; RabbitMQ ist bei der Latenz pro Nachricht oft besser, weil Kafka zugunsten des Durchsatzes bündelt. Was zählt, hängt davon ab, ob Ihr Engpass das Volumen oder die Antwortzeit ist.
Unterstützen Streams Partitionierung?
Ja, über Super Streams, die einen logischen Stream für die parallele Verarbeitung auf mehrere Streams verteilen. Das funktioniert gut, auch wenn das Partitionsmodell von Kafka ausgereifter ist.
Sollte ich RabbitMQ und Kafka gemeinsam einsetzen?
Das ist eine gängige und legitime Architektur – RabbitMQ für Routing und Command-Traffic, Kafka für die Event-Pipeline mit hohem Volumen. Der Preis ist der Betrieb zweier Systeme, also tun Sie es nur, wenn sich die Workloads wirklich unterscheiden.
Wann sollte ich eine Quorum Queue statt eines Streams verwenden?
Wenn Arbeit einmal konsumiert und dann verworfen wird. Quorum Queues eignen sich für die Verteilung von Aufgaben, Streams für Replay und mehrere unabhängige Leser. Wer einen Stream für einfache Job-Verarbeitung nutzt, erhöht Plattenkosten und Komplexität ohne jeden Nutzen.
Wie schnell sind RabbitMQ Streams?
So schnell, dass das verwendete Protokoll die Grenze setzt, nicht der Stream. Mit dem nativen Stream-Protokoll auf Port 5552, Batching auf Publisher-Seite und einem Stream-Client erreicht ein einzelner Stream auf gewöhnlicher Hardware Hunderttausende Nachrichten pro Sekunde, ein Cluster mit mehreren Streams oder einem Super Stream sogar Millionen. Derselbe Stream, über AMQP 0-9-1 gelesen, ist um eine Größenordnung langsamer, weil jede Nachricht Channel-Zustellung, Prefetch und Ack durchläuft. Die Latenz der Confirms wird durch den Schreibvorgang auf der Platte des langsamsten Replikats begrenzt – auf lokalen NVMe-Laufwerken typischerweise wenige Millisekunden.
Wie verbessere ich die Performance von RabbitMQ Streams?
Verlagern Sie zuerst den Hot Path auf das Stream-Protokoll und einen Stream-Client; diese Änderung stellt alles andere in den Schatten. Bündeln Sie dann Publishes mit asynchronen Confirms, halten Sie mehrere Chunks an Consumer-Credit vorrätig und committen Sie Offsets in Intervallen statt pro Nachricht. Lastet ein einzelner Stream seinen Leader aus, teilen Sie ihn in einen Super Stream mit einem Partition Key auf, der die nötige Reihenfolge erhält. Betreiben Sie drei Mitglieder auf lokalem NVMe, legen Sie die Retention mit max-age oder max-length-bytes fest und halten Sie AMQP-Consumer von den meistgenutzten Streams fern. In der Management-UI sehen Sie, welcher Node den jeweiligen Leader hält.

Autor
Leitfäden, Vergleiche und Studien
Mehr zum Thema Kafka
Leitfäden
4Vergleiche
9- NATS vs Kafka 2026: Core NATS, JetStream und Kafka im Vergleich
- Mosquitto vs. Kafka: MQTT-Broker oder Event Log?
- Kafka vs. Kinesis im Vergleich
- Die besten Managed-Kafka-Anbieter 2026 jenseits der Hyperscaler
- Kafka-BYOC-Optionen (Bring Your Own Cloud) im Vergleich
- Alternativen zu Confluent und Wettbewerber nach der IBM-Übernahme