
Auf dieser Seite
Ein Assessment zur Migrationsreife für RabbitMQ ist ein Kontrollpunkt zu einem festen Zeitpunkt vor einem Major-Upgrade, einem Plattformwechsel oder einer Architekturänderung – kein laufender Health Check. Es stellt sicher, dass Topologie und Abhängigkeiten vollständig erfasst sind, Sie wissen, was bricht, wenn ein Schritt scheitert, ein getesteter Rollback existiert und die Zielumgebung echte Produktionslast aufnehmen kann.
Die meisten Teams, die sich bei einer RabbitMQ-Migration die Finger verbrennen, hatten vorher keinen kaputten Cluster. Sie hatten eine stabile Umgebung, einen vernünftigen Plan und einen Go-live-Termin – und stellten mitten in der Umstellung fest, dass die Topologie einer Queue nur im Kopf eines einzelnen Engineers existierte, dass ein nachgelagerter Consumer noch mit einer Client-Library von vor drei Major-Versionen lief oder dass ihr Rollback-Plan „Restore aus dem Backup“ lautete, ohne dass jemand wusste, wie lange das unter Last tatsächlich dauert.
Genau das soll ein strukturiertes Assessment zur Migrationsreife aufdecken – bevor das Wartungsfenster beginnt, nicht währenddessen.
Was ist ein Assessment zur Migrationsreife für RabbitMQ?
Es ist ein Review mit festem Umfang, das an genau eine geplante Änderung gebunden ist: ein Versions-Upgrade, einen Umzug auf neue Infrastruktur (Kubernetes, ein neues Rechenzentrum, eine neue Cloud-Region) oder eine Architekturänderung wie zusätzliche föderierte Replikation für Disaster Recovery. Es ist weder ein Abonnement noch ein Monitoring-Tool.
Das Ergebnis ist eine Migrations-Roadmap samt Reifebericht mit einer klaren Empfehlung: Go, Go nach bestimmten vorherigen Korrekturen oder noch nicht – und zwar für jeden Workload, den die Migration berührt, nicht nur für den Broker selbst. Das ist ein anderes Ergebnis als bei einem allgemeinen Health Check, und es lohnt sich, den Unterschied genau zu kennen, bevor Sie den Umfang festlegen.
Worin unterscheidet sich ein Assessment zur Migrationsreife von einem allgemeinen RabbitMQ Health Check?
Methodisch überschneiden sie sich – beide untersuchen Cluster-Konfiguration, Queue-Topologie und Versionsstand –, aber sie beantworten unterschiedliche Fragen. Ein RabbitMQ Health Check fragt: „Ist dieses Deployment gerade gesund, und was sollten wir grundsätzlich beheben?“ Er läuft regelmäßig, unabhängig von geplanten Änderungen, und seine Ergebnisse – Classic Mirrored Queues, Benutzer mit zu weitreichenden Rechten, falsch konfigurierte Heartbeats – gelten unabhängig davon, ob Sie gerade etwas migrieren.
Ein Assessment zur Migrationsreife stellt eine engere Frage mit höherem Einsatz: „Können wir genau diese Umstellung zu genau diesem Termin ohne Ausfall oder Datenverlust durchführen – und falls nicht, was muss sich vorher ändern?“ Diese Fragestellung verändert die Ergebnisse. Ein Reife-Assessment liefert einen Rollback-Plan, der exakt auf die Migrationsschritte zugeschnitten ist, ein Risikoregister, das festhält, was unter welcher Bedingung bricht, und Lasttests gegen die Ziel-Konfiguration – nicht nur eine Momentaufnahme des aktuellen Zustands. Wenn Sie keine konkrete Umstellung planen, brauchen Sie den Health Check. Steht ein Upgrade oder Plattformwechsel im Kalender, brauchen Sie stattdessen dieses Assessment.
Was sollte eine Bestandsaufnahme vor der Migration tatsächlich erfassen?
Die Bestandsaufnahme ist der Teil, den Teams am häufigsten zu knapp bemessen – weil das meiste davon außerhalb der Broker-Konfiguration liegt. Vier Dinge müssen erfasst sein, bevor Sie eine Migration mit einiger Sicherheit planen können:
- Topologie aus Queues, Exchanges und Bindings – und ob sie per Automatisierung definiert ist. Kürzlich haben wir mit einem Zahlungsdienstleister gearbeitet, dessen Cluster-Installation vollständig automatisiert war, dessen Queues, Exchanges und Federation-Links aber manuell angelegt worden waren und nirgends im Code existierten. Das ist eine häufige Lücke, und sie bedeutet, dass sich die Topologie auf einem neuen Cluster nicht zuverlässig aufbauen lässt, ohne dass jemand sie mühsam aus dem laufenden System rekonstruiert.
- Plugin-Abhängigkeiten. Federation, Shovel und alle eigenen oder Hersteller-Plugins müssen einzeln gegen die RabbitMQ-Zielversion geprüft werden – ein Plugin, das mit Ihrer aktuellen Version kompatibel ist, ist nicht automatisch mit der Version kompatibel, auf die Sie migrieren.
- Versionen von Client-Library und Runtime in jeder konsumierenden Anwendung. Nicht die Broker-Version – der Client. Anwendungen mit alten Client-Libraries oder veralteten Runtimes bringen oft schlecht abgestimmte Einstellungen für Verbindungen, Threads oder Speicher mit, die erst dann zum Problem werden, wenn sich während einer Migration Traffic-Muster oder das Verhalten des Brokers ändern.
- Queue-Typen und Versionskompatibilität. Classic Mirrored Queues sind auf dem Weg zu neueren RabbitMQ-Major-Versionen abgekündigtes Terrain, und die unterstützten Erlang/OTP-Versionen hängen an Ihrer RabbitMQ-Version – die Community Edition von 3.13.x unterstützt beispielsweise die Erlang-27-Runtime nicht. Damit wird für jedes Team, das ohne vollständiges Upgrade aktuell bleiben will, die Lizenzfrage unausweichlich.
Nichts davon ist exotisch. Es ist nur mühsam genug, dass Teams unter Termindruck es überspringen – und es dann live während der Migration wiederentdecken.
Wie bewerten Sie Risiken vor einer RabbitMQ-Migration – was bricht tatsächlich?
Risikobewertung für eine Migration heißt, konkrete Fehlerbedingungen durchzuarbeiten, statt eine generische, nach Schweregrad sortierte Liste zu erstellen. Die nützliche Variante dieser Übung beantwortet für jeden Migrationsschritt: Was bricht, wenn er scheitert, und wie sieht dieser Fehler nachgelagert aus?
Ein konkretes Beispiel aus einem Projekt zur Disaster-Recovery-Replikation, das wir mit einem Kunden aus dem Zahlungsverkehr aufgesetzt haben: Der vorgeschlagene Ansatz nutzte föderierte Exchanges, um Nachrichten an einen Zweitstandort zu replizieren. Föderierte Exchanges replizieren Nachrichten, nicht den Broker-Zustand – fällt die DR-Seite aus, stauen sich replizierte Nachrichten also lokal auf, statt verloren zu gehen. Eine echte DR-Übung kann aber bedeuten, dass nach dem Wiederaufbau der Verbindung ein Rückstand von mehreren hunderttausend Nachrichten abgebaut werden muss. Dieser Recovery-Traffic landet direkt auf dem Produktions-Cluster und muss eingeplant werden – sonst wird er zum eigenen Incident.
So sieht eine echte Risikobewertung aus: Garantien zur Nachrichtenreihenfolge, Annahmen zur Idempotenz auf Consumer-Seite, die Frage, ob ein Reconnect nach einem Ausfall einen Rückstau auslöst, der groß genug ist, um den Produktionsdurchsatz zu beeinträchtigen, und ob Client-Anwendungen Redeliveries tatsächlich korrekt verarbeiten, statt von einem Exactly-once-Verhalten auszugehen, das ihnen nie garantiert wurde. Jeder dieser Punkte hängt von Ihrer Architektur und Ihren Anwendungen ab – eine Checklisten-Vorlage bringt sie nicht ans Licht, das schrittweise Durcharbeiten der Migration schon.
Was muss ein Rollback-Plan enthalten?
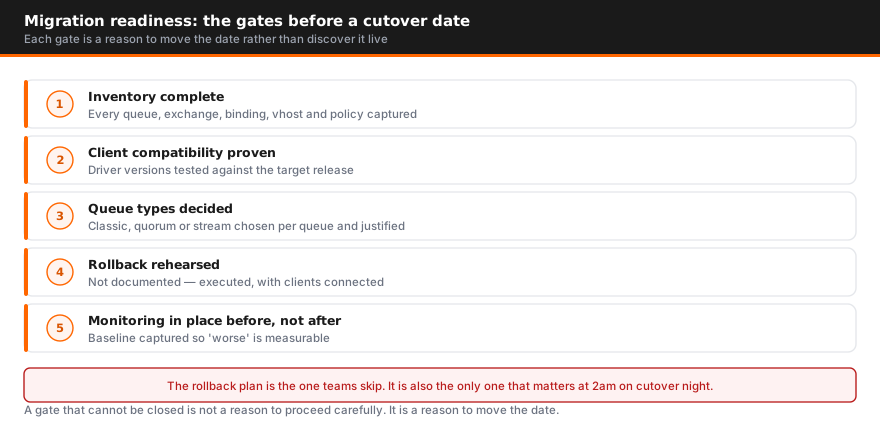
„Restore aus dem Backup“ ist für ein laufendes Messaging-System kein Rollback-Plan – es sagt weder, wie lange die Wiederherstellung dauert, noch welche Nachrichten in der Lücke verloren gehen, noch wie sich nachgelagerte Consumer währenddessen verhalten. Ein echter Rollback-Plan legt für jeden Migrationsschritt die konkrete Auslösebedingung für den Abbruch fest und die konkrete Maßnahme, mit der dieser Schritt rückgängig gemacht wird.
In der Praxis bewährt sich, aktuelle und Zielumgebung parallel zu betreiben, statt an Ort und Stelle zu migrieren. Bauen Sie den neuen Cluster neben dem alten auf, ziehen Sie die Consumer-Anwendungen in Wellen um und lassen Sie den alten Cluster live und mit Traffic weiterlaufen, bis sich die migrierten Wellen als stabil erwiesen haben – oft über einen kompletten Lastspitzenzyklus. Zeigt eine Welle ein Problem, leiten Sie diese Consumer Group zurück auf den alten Cluster, ohne irgendetwas anzufassen, das bereits erfolgreich migriert ist. Das funktioniert nur, wenn der Rollback-Pfad von Anfang an mitgeplant wurde; mitten in der Umstellung lässt er sich kaum noch nachrüsten.
Wenn Sie die Rollback-Maßnahme für einen Schritt nicht in einem Satz benennen können, ist dieser Schritt nicht bereit für die Ausführung.
Wenn Sie mit dem Upgrade zugleich auf einen unterstützten Build wechseln: Unter kommerzielle RabbitMQ-Lizenzierung erfahren Sie, was ein kommerzielles Abonnement umfasst und wie es bepreist wird.
Wie validieren Sie Last und Kapazität vor der Umstellung?
Lasttests vor einer Migration müssen auf Ihrem tatsächlichen Traffic beruhen, nicht auf einem synthetischen Benchmark. Ziehen Sie historische Daten zu Queue-Tiefe und Nachrichtenrate aus dem, was Sie bereits haben – Prometheus, Grafana, Dynatrace oder die Management-API Ihres Brokers –, und erstellen Sie daraus ein realistisches Profil von Spitzendurchsatz, Lastspitzen und Verteilung der Nachrichtengrößen, bevor Sie den Test entwerfen.
Zwei Dinge sollten Sie testen, die Teams oft auslassen. Erstens: Testen Sie bei Ihrer echten Spitzenlast, nicht bei der Durchschnittslast. Eine Zahlungsplattform, mit der wir gearbeitet haben, plante einen Replikationsansatz, der dauerhaft rund 2.000 Nachrichten pro Sekunde tragen musste – und die ehrliche Antwort auf die Frage, ob Federation das unter den gegebenen Netzwerkbeschränkungen schafft, erforderte echte Lasttests, keine Schätzung. Zweitens: Testen Sie den Abbau von Rückständen, nicht nur den Durchsatz im Normalbetrieb. Ein Cluster, der normalen Traffic problemlos bewältigt, kann trotzdem ins Straucheln geraten, wenn er gleichzeitig einen Recovery-Rückstand und Live-Traffic verarbeiten muss – genau das Szenario, in das Sie eine gescheiterte Umstellung oder ein DR-Failback bringt.
Wenn Ihre Zielarchitektur den Queue-Typ ändert, einen Replikations-Hop hinzufügt oder auf andere Infrastruktur umzieht, überträgt sich der Kapazitätspuffer des alten Systems nicht automatisch. Validieren Sie ihn vor dem Go-live-Termin, nicht währenddessen.
Welche Plugin- und Client-Library-Abhängigkeiten werden am häufigsten übersehen?
Über die grundlegende Bestandsaufnahme hinaus tauchen einige Abhängigkeitsprobleme überproportional häufig auf, sobald Teams mitten in der Migration stecken:
- Versionsdrift bei den Federation- und Shovel-Plugins. Diese Plugins werden unabhängig vom Broker-Kern ausgeliefert und müssen gegen die Zielversion neu verifiziert werden – gehen Sie nicht davon aus, dass sich die Kompatibilität automatisch fortsetzt.
- Erlang/OTP-Kompatibilität mit Lizenzbezug. Community-RabbitMQ in der aktuellen stabilen Serie erhält mit der Zeit keine Patches mehr für ältere Erlang-Runtimes, und der Wechsel auf eine neuere Erlang-Major-Version setzt je nach RabbitMQ-Serie mitunter eine kommerzielle Lizenz voraus. Das zeigt sich bei der Migrationsplanung weit häufiger, als Teams erwarten, und kann aus einem unkomplizierten technischen Upgrade eine Beschaffungsfrage mit Deadline machen.
- Clientseitige Standardwerte für Verbindungen und Timeouts, die auf die alte Umgebung abgestimmt sind. Heartbeat- und TCP-Timeout-Einstellungen, die für On-Premises-Netze mit niedriger Latenz optimiert wurden, verursachen falsch-positive Verbindungsabbrüche, sobald eine Migration den Traffic über Availability Zones hinweg oder durch ein NAT-Gateway leitet – eine Änderung, die Sie besser vor der Umstellung erkennen, als sie hinterher als rätselhaften Incident zu debuggen.
- Anwendungen, die noch mit alten Client-Libraries oder Runtimes laufen. Sie bringen oft konservative Standardwerte mit – etwa JVM-Speichereinstellungen, die weit unter dem liegen, was ein Container tatsächlich zur Verfügung hat –, die den Durchsatz unbemerkt deckeln und erst sichtbar werden, wenn Sie bei Migrationstests ein bestimmtes Performance-Ziel erreichen wollen.
Wie lange dauert ein Reife-Assessment, und was erhalten Sie am Ende?
Der Umfang bestimmt den Zeitplan. Ein Versions-Upgrade eines einzelnen Clusters mit wenigen konsumierenden Anwendungen ist typischerweise ein Projekt von einer Woche. Ein Multi-Region-Deployment mit Federation, eigenen Plugins und Dutzenden Consumer-Anwendungen braucht länger für Bestandsaufnahme, Risikobewertung und saubere Lasttests – meist zwei bis drei Wochen.
In beiden Fällen sollten Sie Folgendes in der Hand haben:
- Eine vollständige Bestandsaufnahme von Topologie, Plugins und Client-Libraries – die verbindliche Grundlage, auf der der Migrationsplan aufbaut
- Ein Risikoregister mit konkreten Fehlerbedingungen und ihren nachgelagerten Auswirkungen statt einer generischen Liste nach Schweregrad
- Einen Rollback-Plan mit definiertem Auslöser und Rückbaumaßnahme für jeden Migrationsschritt
- Lasttestergebnisse gegen die Zielkonfiguration, einschließlich Szenarien zum Abbau von Rückständen
- Eine Go/No-Go-Empfehlung, in der blockierende Punkte vor dem Umstellungstermin priorisiert sind
- Validierungskriterien für die Zeit nach der Migration und eine kurze Optimierungsrunde, sobald der Ziel-Cluster echten Traffic trägt
Wägen Sie die Kosten dieses Projekts gegen die Gesamtbetriebskosten eines Verzichts darauf ab – ein ungeplanter Rollback unter Produktionslast ist fast immer teurer als das Assessment selbst. Wenn Sie ein Versions-Upgrade, einen Plattformwechsel oder eine Architekturänderung planen und vor der Festlegung eines Umstellungstermins einen strukturierten Reife-Kontrollpunkt wollen: Unser RabbitMQ-Team führt diese Assessments parallel zu den Migrationen selbst durch. Sprechen Sie mit uns, um den Umfang passend zu Ihrem Zeitplan festzulegen.
Die Checkliste ist Schritt zwei von sieben im Leitfaden zur RabbitMQ-Migration, der Entscheidung, Bestandsaufnahme, semantisches Mapping, Ziel-Build, Umstellung und Validierung in die richtige Reihenfolge bringt.
FAQ
Was ist ein Assessment zur Migrationsreife für RabbitMQ?
Eine Stichtagsprüfung vor einem Major-Upgrade, einem Plattformwechsel oder einer Architekturänderung. Sie erfasst Ihre aktuelle Topologie und alle Abhängigkeiten, zeigt, was bricht, wenn die Migration schiefgeht, liefert einen getesteten Rollback-Plan und belegt, dass die Zielumgebung echte Produktionslast trägt – am Ende steht eine klare Go/No-Go-Empfehlung.
Worin unterscheidet sich ein Assessment zur Migrationsreife von einem allgemeinen RabbitMQ Health Check?
Ein Health Check ist eine regelmäßige Momentaufnahme des Betriebszustands – Cluster-Dimensionierung, Security-Baseline, Konfigurationsdrift – unabhängig von geplanten Änderungen. Ein Assessment zur Migrationsreife ist auf eine konkrete Umstellung zugeschnitten, hat eine feste Deadline und liefert Ergebnisse, die ein Health Check nicht liefert: einen Rollback-Plan, ein Risikoregister für die Umstellung und Lasttests gegen den Zielzustand, nicht nur gegen den Ist-Zustand.
Was muss die Bestandsaufnahme des Ist-Zustands abdecken?
Jede Queue, jeden Exchange und jedes Binding – und ob diese Topologie per Automatisierung definiert ist oder nur als manuelle, undokumentierte Konfiguration existiert; jedes eingesetzte Plugin, einschließlich Federation, Shovel und eigener oder selbst entwickelter Plugins; sowie die Version von Client-Library und Runtime in jeder Anwendung, die Nachrichten publiziert oder konsumiert – nicht nur die Broker-Version.
Was gehört tatsächlich in einen Rollback-Plan?
Ein definierter Auslöser – die konkrete Metrik oder Fehlerbedingung, bei der Sie abbrechen – und für jeden Schritt eine Aussage, wie er sich rückgängig machen lässt, statt eines pauschalen „Restore aus dem Backup“. In der Praxis heißt das meist: alte und neue Umgebung parallel betreiben und die Consumer Groups in Wellen migrieren, damit sich jede Welle zurückleiten lässt, ohne die bereits erfolgreich migrierten anzufassen.
Brauchen wir Lasttests, auch wenn sich die Hardware nicht ändert?
Ja. Ein Versions-Upgrade oder eine Topologieänderung (etwa der Wechsel von Classic Mirrored Queues zu Quorum Queues oder ein zusätzlicher Replikationspfad für Disaster Recovery) verändert das Verhalten des Brokers unter Last – auch auf identischer Hardware. Testen Sie gegen Ihren tatsächlichen Spitzendurchsatz und gegen Szenarien zum Abbau von Rückständen, nicht nur gegen gleichmäßigen Traffic.
Wie lange dauert ein Assessment zur Migrationsreife für RabbitMQ?
Je nach Anzahl der Cluster und Komplexität der Topologie in der Regel ein bis drei Wochen. Ein Upgrade eines einzelnen Clusters mit einer Handvoll konsumierender Anwendungen lässt sich in etwa einer Woche abdecken; ein Multi-Region-Deployment mit Federation, eigenen Plugins und Dutzenden Consumer-Anwendungen braucht länger, bis Bestandsaufnahme und Lasttests sauber erledigt sind.
Was macht ein solches Assessment typischerweise notwendig?
Ein Major-Upgrade (vor allem eines, das die Standard-Queue-Typen oder die Erlang-Kompatibilität ändert), ein Plattformwechsel etwa auf Kubernetes oder in ein neues Rechenzentrum, eine Architekturänderung wie zusätzliche Replikation für Disaster Recovery oder eine Lizenzänderung, die einen Versionssprung unter Zeitdruck erzwingt.

Autor
Mit einem Engineer sprechen
Brauchen Sie Unterstützung bei RabbitMQ?
Senior Engineers, die es selbst in Produktion betreiben. Fordern Sie ein Angebot oder ein kostenloses Erstgespräch an – ganz ohne Verkaufsgespräch.
Leitfäden, Vergleiche und Studien
Mehr zum Thema RabbitMQ
Leitfäden
14- Leitfaden zum RabbitMQ-Performance-Tuning
- Der Leitfaden zu RabbitMQ Streams
- Der RabbitMQ-Zuverlässigkeitsleitfaden: zehn Fehlermuster und ihre Lösungen
- Der Leitfaden zu RabbitMQ Disaster Recovery
- Der Leitfaden für RabbitMQ-Clustering und -Sizing
- Der Leitfaden zu RabbitMQ auf Kubernetes
8 weitere anzeigenWeniger anzeigen
- Leitfaden zu RabbitMQ-Sicherheit und -Härtung
- Leitfaden zu RabbitMQ Monitoring und Alerting
- RabbitMQ für KI-Agenten: Patterns, Setup und Fallstricke
- Celery und RabbitMQ für LLM-Task-Queues
- Agent-to-Agent-Messaging über AMQP und RabbitMQ
- RabbitMQ-Erlang-Kompatibilität: Matrix zu Version, Erlang und Patch-Verantwortlichem
- RabbitMQ 3.x auf 4.x: Upgrade-Runbook
- RabbitMQ-Schulung: Lehrplan mit Workshop-Modulen, Voraussetzungen und Labs
Vergleiche
9- Community RabbitMQ, Tanzu RabbitMQ oder Drittanbieter-Support?
- Die besten RabbitMQ-Support-Anbieter im Vergleich (2026)
- RabbitMQ vs. Amazon SQS im Vergleich
- RabbitMQ vs. Redis im Vergleich
- RabbitMQ-Anbieter im Vergleich: Amazon MQ, CloudAMQP, Stackhero, Northflank, Tanzu und AceMQ
- Support-Optionen für Message Broker im Vergleich


