
Sur cette page
Choisissez une stratégie de partitionnement Kafka en adaptant la logique de partitionnement à vos exigences d'ordre et de débit : le partitionnement par clé lorsque des messages liés doivent arriver dans l'ordre, le sticky partitioner par défaut lorsqu'une charge équilibrée compte davantage que l'ordre des messages, et un partitionneur personnalisé uniquement si vous avez des règles de routage qu'aucun des deux ne sait exprimer. Dimensionnez ensuite le nombre de partitions à partir du débit mesuré (débit cible du topic divisé par le débit par partition, arrondi au supérieur avec une marge de 2 à 3 fois), car le parallélisme des consommateurs est plafonné par le nombre de partitions, et réduire ce nombre par la suite est pratiquement impossible.
Cette réponse en deux phrases cache beaucoup de difficultés opérationnelles. Une mauvaise stratégie de partitionnement est l'une des erreurs les plus coûteuses que commettent les équipes avec Apache Kafka, car la disposition des partitions d'un topic est quasiment figée dès que du vrai trafic y circule. Ce guide explique comment Kafka choisit la partition qui reçoit chaque message, le calcul de dimensionnement du nombre de partitions, le fonctionnement de l'affectation des partitions aux consommateurs, et comment corriger les partitions chaudes avant qu'elles ne fassent tomber un cluster.
Qu'est-ce qu'une stratégie de partitionnement Kafka ?
Une stratégie de partitionnement Kafka est l'ensemble des décisions qui déterminent la répartition des données entre les partitions d'un topic : combien de partitions reçoit le topic Kafka, quelle clé de partitionnement (le cas échéant) utilisent les producteurs, et quel algorithme de partitionnement associe chaque enregistrement à une partition donnée. Chaque partition Apache Kafka est un log ordonné en ajout seul (append-only), et Kafka ne garantit l'ordre qu'au sein d'une partition, jamais entre partitions. Cette seule contrainte guide presque tous les choix abordés ci-dessous.
Les partitions existent pour permettre à Kafka de faire évoluer le streaming de données horizontalement. Répartir les partitions sur plusieurs brokers permet à un cluster Kafka d'absorber un volume de données qu'aucune machine seule ne pourrait gérer, et permet à un groupe de consommateurs de se partager le traitement, chaque consommateur détenant un sous-ensemble de partitions. En résumé : les partitions sont l'unité de parallélisme, d'ordre et de répartition de la charge dans le cluster Kafka. C'est pourquoi le choix d'une stratégie de partitionnement mérite un vrai temps de conception avant que le premier octet ne soit produit.
Comment Kafka choisit la partition qui reçoit un message
Ce sont les producteurs, et non les brokers, qui déterminent la partition. Lorsque vous envoyez un enregistrement, le partitionneur du producteur s'exécute côté client et décide où il atterrit. Il existe trois stratégies de partitionnement à connaître dans Kafka.
Partitionnement par clé (comportement par défaut avec une clé)
Lorsqu'un enregistrement a une clé non nulle, Kafka utilise murmur2(key) % numPartitions pour déterminer la partition. Les messages portant la même clé sont toujours routés vers la même partition, ce qui préserve l'ordre pour cette clé : tous les événements de customer-42 arrivent dans le même log, dans l'ordre. C'est la bonne stratégie dès que des messages liés doivent être traités séquentiellement : cycle de vie des commandes, soldes de comptes, événements de session, et tout ce qui concerne les jointures et agrégations Kafka Streams, qui exigent des topics d'entrée co-partitionnés.
Le revers : la répartition de vos partitions ne vaut que ce que vaut la cardinalité de vos clés. Choisir des clés de partitionnement avec peu de valeurs distinctes (code pays, statut de commande) concentre le trafic sur une poignée de partitions et laisse les autres sous-utilisées.
Partitionnement round-robin et sticky (clé nulle)
Avec une clé nulle, les anciens clients répartissent les enregistrements en round-robin, un enregistrement à la fois, sur chaque partition tour à tour. Depuis Kafka 2.4 (KIP-480), la stratégie par défaut pour les enregistrements sans clé est le sticky partitioner : il remplit un lot vers une partition, puis change de partition. Les enregistrements restent ainsi répartis équitablement, tout en produisant des lots beaucoup moins nombreux et plus gros, d'où une latence plus faible et une meilleure compression qu'avec un round-robin pur. Utilisez des clés nulles lorsque vous n'avez pas besoin d'ordre par clé et voulez simplement un débit maximal et bien équilibré.
Partitionneurs personnalisés
Implémenter l'interface Partitioner vous permet de contrôler directement la stratégie de partitionnement. Les équipes utilisent des partitionneurs personnalisés pour router les messages prioritaires vers la partition 0 pendant que le trafic de masse se répartit sur la partition 1 et au-delà, pour attacher un client à une plage de partitions, ou pour hacher un champ contenu dans la charge utile. Spécifier explicitement une partition pour chaque enregistrement dans le ProducerRecord produit le même effet au cas par cas. Ce sont deux outils tranchants : un partitionneur personnalisé qui ignore les changements du nombre de partitions, ou qui déséquilibre la charge, sabotera discrètement le topic. Testez-le au regard de la sémantique décrite dans la documentation officielle de Kafka avant qu'il n'arrive en production.
Combien de partitions ? Le calcul de dimensionnement
La formule la plus citée pour le nombre de partitions vient de Confluent : avec un débit cible T, un débit producteur mesuré par partition P et un débit par consommateur C, il vous faut au minimum :
partitions = max(T / P, T / C)
Supposons qu'il vous faille 100 Mo/s à travers le topic, qu'une partition soutienne 25 Mo/s sur votre matériel et qu'un consommateur traite 10 Mo/s en effectuant un vrai travail (désérialisation, enrichissement, écritures en base de données). Il vous faut alors au minimum max(100/25, 100/10) = 10 partitions. En pratique, c'est le calcul côté consommateur qui l'emporte, car les consommateurs effectuent un traitement plus lourd que le chemin d'écriture en ajout seul du broker. Mesurez ces deux valeurs sur votre propre infrastructure Kafka : la taille des messages, la compression, le facteur de réplication et le paramètre acks font tous varier considérablement le débit par partition.
Ajoutez ensuite une marge. Le nombre de partitions se dimensionne sur la charge de pointe prévue, et non sur la moyenne actuelle, car augmenter le nombre de partitions plus tard casse l'ordre par clé (nous y revenons plus bas). Une bonne pratique courante consiste à prévoir 2 à 3 fois le minimum calculé, arrondi à un nombre divisible par les nombres de consommateurs probables (12, 24, 30), afin que les partitions se répartissent équitablement entre les consommateurs Kafka.
Aide-mémoire du dimensionnement des partitions
| Débit cible | Limite producteur par partition | Limite par consommateur | Minimum | Recommandé (avec marge) |
|---|---|---|---|---|
| 10 Mo/s | 25 Mo/s | 10 Mo/s | 1 | 6–12 |
| 50 Mo/s | 25 Mo/s | 10 Mo/s | 5 | 12–15 |
| 100 Mo/s | 25 Mo/s | 10 Mo/s | 10 | 24–30 |
| 500 Mo/s | 25 Mo/s | 10 Mo/s | 50 | 100–120 |
| 1 Go/s | 25 Mo/s | 10 Mo/s | 100 | 200–240 |
Trop peu de partitions plafonne le débit et le parallélisme des consommateurs. Trop de partitions a aussi un coût : davantage de descripteurs de fichiers ouverts et de mémoire sur chaque broker, des élections de leader plus longues, plus de trafic de réplication et des rééquilibrages plus lents. Un topic qui a 10 fois plus de partitions qu'il n'en aura jamais besoin est une dette technique que vous payez à chaque basculement.
Groupes de consommateurs, parallélisme et affectation des partitions
Le nombre de partitions est un plafond strict pour le parallélisme de lecture. Au sein d'un groupe de consommateurs, chaque partition est attribuée à exactement un consommateur : un topic de 12 partitions accepte donc au plus 12 consommateurs actifs, et le 13e reste inactif. Si le nombre de consommateurs dont vous aurez besoin dépasse votre nombre de partitions, aucune mise à l'échelle horizontale n'y fera rien. C'est pourquoi le nombre de partitions se planifie en fonction du parallélisme en aval, et pas seulement de la capacité des brokers.
L'affectation des partitions aux consommateurs est régie par des stratégies d'affectation interchangeables : range (le comportement historique par défaut, sujet aux déséquilibres sur plusieurs topics), round-robin, sticky, et le plus récent CooperativeStickyAssignor. L'option coopérative compte en exploitation : le rééquilibrage eager classique arrête tout (stop-the-world). Chaque consommateur s'interrompt, abandonne ses partitions et rejoint à nouveau le groupe ; sur les grands groupes, cette pause crée des pics de lag et des timeouts en aval. Le rééquilibrage coopératif ne déplace que les partitions qui doivent l'être. Si vous êtes en Kafka 2.4 ou ultérieur et n'avez pas encore fait le changement, ce seul paramètre est souvent le gain de latence le moins coûteux à votre portée.
Les tempêtes de rééquilibrages sont aussi le moment où les problèmes de stratégie de partitionnement font surface à 3 h du matin : un consommateur lent manque son échéance de poll, déclenche un rééquilibrage, le lag augmente, d'autres consommateurs dépassent leur délai, et le groupe s'emballe. Si votre équipe lutte en ce moment contre des boucles de rééquilibrage ou un lag inexpliqué, le support Kafka 24/7 d'AceMQ affecte un ingénieur Kafka senior à votre incident avec des objectifs de réponse à partir de 15 minutes, selon le plan : toute la différence entre un simple accroc et une panne qui se compte en heures.
Partitions chaudes : causes et corrections
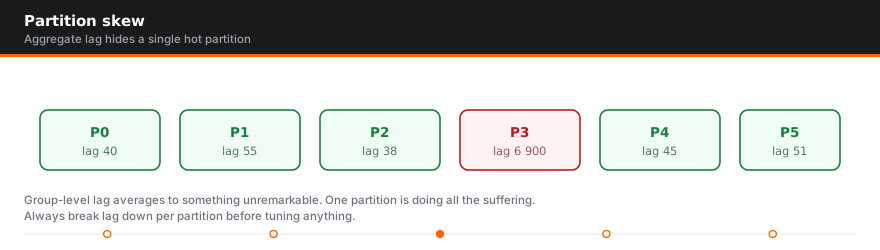
Une partition chaude (hot partition) reçoit une part disproportionnée du trafic : c'est le mode de défaillance classique du partitionnement par clé. Causes courantes :
- Clés de faible cardinalité : hacher sur
countryalors que 60 % du trafic provient d'un seul pays envoie la plupart des enregistrements vers une seule partition. - Clés « vedettes » : un client, un appareil ou un utilisateur génère des ordres de grandeur d'événements de plus que les autres, et tous aboutissent dans la même partition.
- Partitionneurs personnalisés déséquilibrés : un routage maison qui concentre la charge sur la partition 0 ou sur une petite plage.
Les symptômes : un broker chauffe pendant que les autres sont au repos, un consommateur prend du retard pendant que ses pairs sont à jour, et la latence de production augmente pour un sous-ensemble de clés. Pour corriger une partition chaude :
- Changez de clé pour une cardinalité plus forte. Utilisez
userIdplutôt queregion, ou une clé composite commetenantId:deviceId, afin que le hachage répartisse la charge vers une partition appropriée pour chaque entité. - Salez les clés chaudes. Ajoutez un petit suffixe aléatoire (
bigTenant-0…bigTenant-7) pour répartir une clé chaude sur plusieurs partitions, en acceptant de devoir réagréger ensuite, puisque l'ordre n'est plus garanti que par clé salée. - Isolez la baleine. Routez votre plus gros client vers un topic dédié, avec sa propre stratégie de partitionnement, dimensionné pour son seul trafic.
- Supprimez complètement la clé lorsque l'ordre n'est pas réellement nécessaire : de nombreux pipelines utilisent des clés par habitude et paient une pénalité de déséquilibre pour une garantie que personne n'exploite. Le sticky partitioner équilibrera presque parfaitement le trafic sans clé.
Surveillez la santé des partitions avant que les utilisateurs ne s'en aperçoivent : débit de production et taille du log par partition (déséquilibre du bytes-in), lag des consommateurs par partition, et déséquilibre disque et réseau entre brokers. Une alerte sur le déséquilibre de débit entre partitions, par exemple toute partition qui soutient 3 fois la médiane du topic, détecte la plupart des incidents de partition chaude tant qu'ils sont encore peu coûteux à corriger.
Pourquoi repartitionner fait mal (anticipez)
Vous pouvez augmenter le nombre de partitions d'un topic Kafka en service avec kafka-topics.sh --alter, mais vous ne pouvez jamais le réduire. Et l'augmenter n'est pas la correction anodine qu'il semble être : hash(key) % numPartitions change dès que le nombre change, si bien que les clés existantes commencent à pointer vers une autre partition. Les anciens événements de customer-42 restent dans la partition 3 tandis que les nouveaux arrivent dans la partition 7. L'ordre des messages pour ces clés est rompu à la jointure, et tout état Kafka Streams construit à partir de ce topic doit être reconstruit ou migré.
La seule vraie correction pour un topic avec clé mal partitionné est une migration complète : créer un nouveau topic avec le bon nombre de partitions, y répliquer les données, basculer les consommateurs, puis retirer l'original. Cela représente des jours de travail minutieux sur un cluster de production chargé, et c'est précisément pourquoi une planification rigoureuse des partitions Kafka dès le départ, avec de la marge, vaut 10 fois l'effort du nettoyage.
KRaft et limites de partitions : ce qu'a changé KIP-500
L'ancien plan de contrôle de Kafka, basé sur ZooKeeper, imposait un plafond pratique au nombre de partitions à l'échelle du cluster (on cite couramment environ 200 000 partitions), car le basculement du contrôleur et la propagation des métadonnées devenaient extrêmement lents au-delà. KIP-500 a remplacé ZooKeeper par KRaft, un quorum de métadonnées intégré basé sur Raft, qui est le seul mode pris en charge depuis Kafka 4.0. KRaft stocke les métadonnées dans un log d'événements interne : un nouveau contrôleur prend le relais en un temps quasi constant et les clusters peuvent atteindre des millions de partitions.
Ce que KRaft ne change pas : le calcul de dimensionnement par topic, les partitions chaudes, la sémantique d'ordre ou la douleur du repartitionnement. Il relève le plafond de la gestion des partitions Kafka à l'échelle du cluster ; il ne rend pas la stratégie appliquée à chaque topic moins lourde de conséquences. Au contraire, migrer un ancien cluster ZooKeeper vers KRaft est en soi un projet où les erreurs de disposition des partitions coûtent cher à traîner.
Bonnes pratiques de partitionnement Kafka
- Mesurez le débit réel par partition sur vos propres brokers Kafka ; ne réutilisez pas les chiffres de quelqu'un d'autre.
- Dimensionnez le nombre de partitions avec
max(T/P, T/C)plus une marge de 2 à 3 fois, divisible par le nombre de consommateurs attendu. - N'utilisez des clés que lorsque vous avez besoin d'un ordre par clé ; sinon, laissez le sticky partitioner affecter les enregistrements sans clé pour un équilibre maximal.
- Maintenez une cardinalité de clés au moins 10 à 100 fois supérieure au nombre de partitions pour garder une répartition homogène.
- Utilisez
CooperativeStickyAssignorpour réduire les pauses de rééquilibrage. - Surveillez le lag par partition, le déséquilibre du bytes-in et le déséquilibre entre brokers, et alertez sur le déséquilibre, pas seulement sur les totaux.
- Documentez votre stratégie de partitionnement topic par topic, pour que le prochain ingénieur ne « corrige » pas un choix délibéré.
Bien faire les choses relève de la conception ; les maintenir correctes à 2 h du matin relève de l'exploitation. Les ingénieurs seniors d'AceMQ exploitent et dépannent chaque jour des clusters Kafka de production pour des entreprises, des revues de stratégie de partitionnement et de la planification de capacité jusqu'à la réponse d'urgence avec des objectifs de réponse à partir de 15 minutes, selon le plan, jour et nuit. Découvrez les services Kafka pour entreprises d'AceMQ ou parlez-nous de la couverture 24/7 de votre cluster. Pour un second avis sur le nombre de partitions, un audit de santé Kafka les passe en revue.
Cet article est l'étape deux sur dix du guide d'exploitation de Kafka, qui aborde les décisions opérationnelles dans l'ordre où elles se présentent sur un parc en production.
Questions fréquentes
Peut-on modifier le nombre de partitions après la création d'un topic ?
On peut seulement l'augmenter, jamais le réduire. Augmenter le nombre de partitions modifie le calcul hash(key) % numPartitions : les enregistrements portant la même clé commencent alors à arriver sur une autre partition que leur historique, ce qui casse l'ordre par clé au moment de la transition. Pour les topics avec clé, la voie sûre consiste à migrer vers un nouveau topic correctement dimensionné.
Comment Kafka décide-t-il dans quelle partition va un message ?
C'est le producteur qui décide, côté client. Avec une clé, Kafka utilise un hash murmur2 de la clé modulo le nombre de partitions. Sans clé, le sticky partitioner remplit les lots une partition à la fois tout en équilibrant l'ensemble. Les producteurs peuvent aussi passer outre en implémentant un partitionneur personnalisé ou en définissant explicitement la partition sur l'enregistrement.
Qu'est-ce qui provoque une partition chaude, et comment la corriger rapidement ?
La cause habituelle : des clés de faible cardinalité ou très déséquilibrées. Trop de trafic est haché vers une seule partition, ce qui surcharge son broker et son consommateur. Les mesures immédiates consistent à saler la clé chaude sur plusieurs partitions, à changer de clé pour un champ de plus forte cardinalité, ou à isoler le client le plus lourd sur son propre topic.
À partir de combien de partitions est-ce trop ?
Il n'existe pas de chiffre universel, mais chaque partition ajoute de la mémoire sur le broker, des descripteurs de fichiers, du travail de réplication et du temps de rééquilibrage. Par broker, rester dans les quelques milliers de partitions est une règle largement suivie ; le mode KRaft relève considérablement les limites à l'échelle du cluster, mais un surdimensionnement par topic au-delà d'environ 3 fois le débit de pointe prévu coûte généralement plus qu'il ne protège.
Le nombre de partitions limite-t-il le nombre de consommateurs ?
Oui. Au sein d'un groupe de consommateurs, chaque partition est attribuée à exactement un consommateur (un consommateur peut toutefois lire plusieurs partitions) : les consommateurs au-delà du nombre de partitions restent donc inactifs. Votre parallélisme de lecture maximal est égal à votre nombre de partitions. C'est pourquoi le dimensionnement doit généralement être dicté par le débit des consommateurs, et non par la capacité des brokers.

Auteur
Guides, comparatifs et études
Approfondir : Kafka
Guides
3Comparatifs
9- NATS vs Kafka en 2026 : comparatif Core NATS, JetStream et Kafka
- Mosquitto vs Kafka : broker MQTT ou journal d'événements ?
- Kafka vs Kinesis : le comparatif
- Meilleurs fournisseurs Kafka managé en 2026, au-delà des hyperscalers
- Kafka Bring Your Own Cloud (BYOC) : les offres comparées
- Alternatives à Confluent et concurrents après le rachat par IBM


