Sur cette page
RabbitMQ Streams est un type de file d'attente qui stocke les messages dans un journal répliqué en ajout seul (append-only), afin que de nombreux consommateurs puissent lire le même historique de façon indépendante et le rejouer à partir de n'importe quel offset. Il s'exécute au sein d'un broker RabbitMQ, ce qui réunit routage et rejeu au même endroit ; Apache Kafka est la plateforme dédiée aux très gros volumes soutenus et à la longue rétention. Ce guide explique le fonctionnement de RabbitMQ Streams, ses performances, son optimisation et les cas où Kafka est le meilleur choix.
En bref : si vous exploitez déjà RabbitMQ et avez besoin de rejeu, RabbitMQ Streams est très probablement la réponse. Si vous ingérez des centaines de milliers de messages par seconde et les conservez pendant des semaines, c'est Kafka. Pour un choix plus global entre files d'attente, streams et Kafka, consultez RabbitMQ vs Kafka.
Ce qu'est réellement un stream
Une file RabbitMQ classique est destructive : un message est livré, acquitté, puis disparaît. Ce modèle convient à la distribution du travail : un consommateur prend une tâche, l'exécute, et elle disparaît.
Un stream est tout l'inverse. C'est un journal en ajout seul stocké sur disque. Les consommateurs lisent à leur propre offset et la lecture ne modifie rien : dix applications indépendantes peuvent ainsi lire chacune tous les messages et rejouer depuis le début chaque fois qu'elles en ont besoin.
Ce modèle non destructif est ce que les deux systèmes ont en commun, et c'est la seule raison pour laquelle on les compare. Tout le reste les distingue.
Si vous avez déjà opté pour les streams et devez les exploiter, le guide RabbitMQ Streams couvre la rétention, les offsets, les super streams, la gestion des réplicas et ce que garantit, ou non, une confirmation d'éditeur.
RabbitMQ Streams vs Kafka : la différence d'architecture
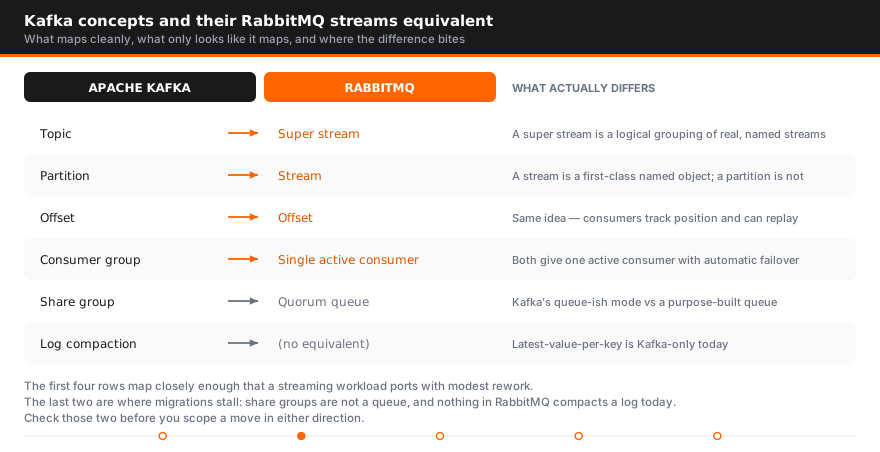
Kafka est une plateforme de streaming d'événements distribuée, et chaque mot de cette formule compte. Un topic Kafka est divisé en partitions réparties sur le cluster ; un producteur écrit dans une partition, et les consommateurs d'un groupe possèdent chacun certaines partitions. Parallélisme, ordre et débit découlent tous de ce modèle de partitions.
RabbitMQ est un broker de messages qui s'est doté d'un type de file stream. Le même cluster qui route le travail via des exchanges et des bindings peut aussi héberger des streams, accessibles en AMQP ou via un protocole stream binaire dédié. RabbitMQ prend en charge les deux modèles au même endroit : vous ajoutez une capacité à un broker, vous n'adoptez pas une seconde plateforme.
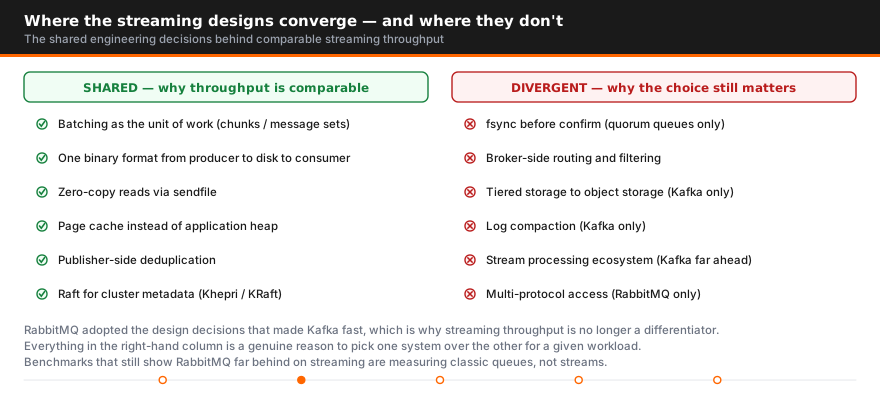
Ce seul fait structurel explique l'essentiel des différences pratiques présentées ci-dessous.
RabbitMQ Streams vs Apache Kafka : les principales différences
| RabbitMQ Streams | Apache Kafka | |
|---|---|---|
| Point fort principal | Routage et rejeu dans un seul broker | Volume et rétention à grande échelle |
| Protocole | AMQP 0-9-1 et 1.0, MQTT, plus un protocole stream | Protocole binaire propre à Kafka |
| Partitionnement | Super streams | Partitions de topic natives |
| Rétention | Limites de taille et de durée par stream | Taille, durée ou compaction par topic |
| Ordre | Par stream, ou par partition dans un super stream | Par partition |
| Volume typique | Élevé : des dizaines de milliers par seconde | Très élevé : des centaines de milliers et au-delà |
| Écosystème | Outils et clients RabbitMQ | Connect, API Streams, ksqlDB, vaste écosystème |
| Charge d'exploitation | Un seul broker, un modèle familier | Une plateforme à part entière à exploiter |
Traitement des messages, rétention et ordre
Les deux conservent les données sur disque et permettent aux consommateurs de les rejouer. Un topic Kafka conserve les messages selon des politiques fondées sur la durée, la taille ou la compaction, et la compaction (ne conserver que la dernière valeur par clé) est un véritable atout distinctif : les streams RabbitMQ ne la proposent pas.
L'ordre fonctionne de la même manière dans les deux : garanti au sein d'une partition, pas entre partitions. Si un ordre global strict est indispensable, il vous faut une partition unique dans l'un comme dans l'autre, et vous renoncez au parallélisme pour l'obtenir.
La différence apparaît dans le routage. RabbitMQ peut appliquer des bindings d'exchange, des motifs de topic et des en-têtes avant même qu'un message n'atteigne un stream. Un producteur Kafka choisit un topic et une clé de partition, et la logique de routage réside dans votre application ou dans le traitement de flux en aval.
Performances et montée en charge
Sur le débit, Kafka l'emporte nettement, et l'écart est réel dans le haut de gamme. Un broker Kafka est conçu pour les écritures séquentielles sur disque, et le modèle de partitions fait monter les écritures en charge horizontalement, ce qu'un stream seul ne permet pas.
Les streams RabbitMQ sont bien plus rapides que les files classiques et absorbent sans difficulté des charges à fort volume, mais un super stream reste un partitionnement greffé sur un broker dont le centre de gravité est le routage, et non une plateforme conçue dès l'origine pour le débit disque séquentiel.
Sur la latence, l'écart est plus faible que sur le débit. Pour la latence par message à volume modéré, RabbitMQ est souvent plus performant, car le batching de Kafka privilégie le traitement en masse plutôt que la vitesse de chaque message. Si votre exigence est « ce message doit arriver en quelques millisecondes » plutôt que « nous devons absorber un million d'événements par seconde », ne partez pas du principe que Kafka est le choix le plus rapide.
Les benchmarks, dans un sens comme dans l'autre, sont à prendre avec précaution. Les chiffres des éditeurs sont obtenus dans des conditions choisies pour flatter le système vendu, et la taille de vos messages, vos réglages de durabilité et votre réseau influenceront le résultat davantage que le choix du logiciel.
RabbitMQ Streams ou Kafka : lequel est le plus simple à exploiter ?
RabbitMQ, en général, et c'est un critère de décision légitime, pas un aveu de faiblesse.
Le modèle de déploiement de RabbitMQ correspond de près à la façon dont la plupart des développeurs raisonnent déjà : producteurs, exchanges, files, consommateurs. Les brokers RabbitMQ ont un comportement prévisible. Il existe des bibliothèques clientes pour tous les langages, l'interface de gestion est réellement utilisable, et un cluster fonctionnel se monte en un après-midi.
Kafka en demande davantage. Nombre de partitions, rééquilibrage des groupes de consommateurs, gestion des offsets, réglage de la rétention et paramètres de réplication doivent tous être maîtrisés avant la production. La contrepartie est un système qui monte plus loin en charge que RabbitMQ, mais la courbe d'apprentissage est réelle, et
Pour le dire franchement : choisissez le système que votre équipe saura exploiter à 3 h du matin, pas celui qui gagne un benchmark.
RabbitMQ Streams peut-il remplacer Kafka, ou l'inverse ?
Partiellement, dans les deux sens, et mal dans les deux sens si on force les choses.
Remplacer RabbitMQ par Kafka pose problème dès que vous avez besoin de routage. Kafka n'a pas d'équivalent aux bindings d'exchange, au TTL par message, aux files prioritaires ni au comportement de dead-letter. Les reproduire implique de les construire dans le code applicatif : beaucoup de travail pour éviter d'exploiter un broker que vous maîtrisez déjà.
Remplacer Kafka par RabbitMQ pose problème avec un volume et une rétention soutenus. Si vous conservez un mois d'événements pour les retraiter à des centaines de milliers de messages par seconde, les streams ne sont pas le bon outil, et l'écart d'écosystème compte aussi : Kafka Streams, Connect et ksqlDB n'ont pas d'équivalent direct.
Chacun peut faire le travail de l'autre pendant un temps. L'échec survient avec l'échelle ou la complexité, c'est-à-dire précisément au moment où une migration est la plus difficile.
Quand utiliser les deux
De nombreuses architectures matures exploitent les deux, et ce n'est pas un défaut de conception.
Un schéma courant : RabbitMQ gère la commande et le contrôle (requête/réponse, distribution de tâches, microservices événementiels nécessitant un routage précis), tandis que Kafka transporte le flot massif d'événements consommé par l'analytique et le traitement de flux. Chaque système fait ce qu'il fait de mieux, reliés par une passerelle ou une application qui lit dans l'un et écrit dans l'autre.
Le prix à payer : deux systèmes à exploiter, superviser et doter en personnel. Cela en vaut la peine quand les charges de travail diffèrent réellement ; pas pour éviter une discussion difficile sur le système à retenir comme standard.
Lequel convient le mieux à votre cas d'usage
Choisissez RabbitMQ si :
- vous exploitez déjà RabbitMQ et avez besoin de rejeu ou de plusieurs lecteurs indépendants ;
- le routage compte : motifs de topic, routage par en-têtes, topologies complexes ;
- vous avez besoin de files et de streams et préférez ne pas exploiter deux plateformes ;
- la latence par message compte davantage que le volume agrégé ;
- votre équipe est réduite et la simplicité d'exploitation a une vraie valeur.
Choisissez Kafka si :
- le volume d'ingestion est réellement très élevé et soutenu ;
- vous avez besoin d'une longue rétention, d'un rejeu sur plusieurs semaines ou de la compaction des logs ;
- vos cas d'usage de streaming nécessitent l'écosystème élargi : Connect, API Streams, ksqlDB ;
- de nombreuses équipes indépendantes consomment les mêmes flux de données ;
- vous disposez, ou allez recruter, de l'expertise d'exploitation qu'il exige.
Choisissez les deux si vous avez des charges de travail distinctes qui conviennent réellement à chacun, et la capacité d'exploitation pour les faire tourner correctement.
Même dans RabbitMQ, les streams ne sont pas toujours la réponse
Disons-le clairement : si votre charge relève de la distribution de tâches plutôt que du rejeu d'événements, la quorum queue reste le bon choix. Les streams ajoutent une rétention et un rejeu dont vous n'avez peut-être pas besoin, et stockent tout sur disque : un stream qui contient des données que personne ne rejoue est une dépense sans bénéfice.
Dans RabbitMQ, le choix entre file et stream vient en premier, et il fait souvent disparaître entièrement la question de Kafka. Consultez
Performances des streams RabbitMQ : à quoi s'attendre
Un stream RabbitMQ est un journal en ajout seul stocké sur disque, avec un seul rédacteur : le membre leader. C'est ce rédacteur unique qui rend un stream rapide : pas de routage par message, pas de remaniement d'index de file, pas de suppression à l'acquittement. C'est aussi son plafond. Le débit monte en charge par stream jusqu'à ce qu'un leader peut ajouter et répliquer, puis au-delà avec le nombre de streams répartis sur le cluster. Besoin de plus ? Ajoutez des streams, pas une machine plus grosse.
La façon dont vous dialoguez avec le stream compte plus que presque tout le reste. Le protocole stream natif sur le port 5552 (le plugin rabbitmq_stream) est un protocole binaire conçu pour les journaux : les éditeurs envoient des lots dans une seule trame, le broker écrit les chunks directement dans le fichier, et les consommateurs relisent ces chunks avec sendfile depuis le cache de pages, avec un travail par message quasi nul côté Erlang. L'accès AMQP 0-9-1 au même stream (x-queue-type: stream) passe par la mécanique habituelle des canaux : une livraison par message, un prefetch obligatoire, des acquittements par message. C'est pratique pour le code existant, mais au moins un ordre de grandeur plus lent en lecture. Avec le protocole stream et le batching, un seul stream sur du matériel ordinaire atteint des centaines de milliers de messages par seconde, et un cluster avec plusieurs streams atteint plusieurs millions. En AMQP, quelques dizaines de milliers par seconde et par stream constituent la fourchette réaliste.
Le batching par sous-entrées (sub-entry batching) pousse encore plus loin le protocole natif : un éditeur regroupe de nombreux messages dans une seule entrée et la compresse (gzip, snappy, lz4, zstd), et le broker stocke le lot comme une unité : le coût disque et de réplication n'est payé qu'une fois par lot. Les consommateurs AMQP ne peuvent pas lire les lots de sous-entrées.
La réplication repose sur un leader et des réplicas via la bibliothèque de réplication de journaux Osiris, et non sur Raft. Une publication est confirmée dès qu'une majorité de membres l'a écrite sur disque. Les réplicas supplémentaires coûtent de la bande passante sortante au leader et ajoutent au temps de confirmation la latence disque du réplica le plus lent ; ils ne coûtent rien en débit de lecture, puisque les consommateurs peuvent lire depuis les réplicas.
Le comportement disque est la partie que l'on sous-estime. Les écritures sont séquentielles et peu coûteuses. Les lectures de données récentes proviennent du cache de pages du système et sont quasi gratuites ; un consommateur qui rejoue depuis la semaine dernière va sur le disque et entre en concurrence avec le rédacteur. Une longue rétention combinée à des consommateurs qui reviennent en arrière exige de la marge dans le cache de pages : de la RAM pour le noyau, pas pour la VM Erlang.
La rétention s'applique par segment. max-age et max-length-bytes définissent la fenêtre, stream-max-segment-size-bytes (500 Mo par défaut) définit la granularité, car le broker ne supprime que des segments entiers. Aucun de ces paramètres n'affecte beaucoup la vitesse de publication ; ils déterminent l'utilisation du disque et le coût du rejeu.
Le suivi des offsets n'est pas gratuit non plus. Le stockage des offsets côté serveur écrit des entrées de suivi dans le stream lui-même : valider après chaque message double à peu près la charge d'écriture d'un consommateur. Validez à intervalle régulier et acceptez quelques relivraisons au redémarrage.
Comment optimiser les performances des streams RabbitMQ
Dans l'ordre où nous les appliquons :
- Utilisez le protocole stream et un client stream. Si votre chemin critique passe par AMQP, ce changement vaut plus que tout ce qui suit réuni.
- Regroupez les publications côté éditeur et confirmez de façon asynchrone. Les clients stream fonctionnent par lots par défaut ; augmentez la taille des lots et n'attendez jamais de confirmation message par message.
- Accordez du crédit aux consommateurs. Le protocole fonctionne par crédit : le consommateur demande des chunks et le broker envoie jusqu'à épuisement du crédit. Laissez plusieurs chunks en attente.
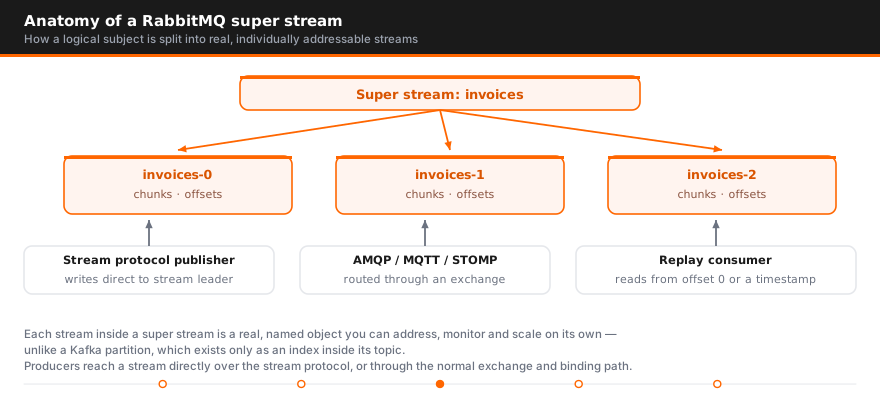
- Scindez avec des super streams. Un super stream est un ensemble de streams de partition regroupés sous un même nom ; les éditeurs choisissent une partition par clé de routage, hachée par défaut. L'ordre n'est garanti qu'au sein d'une partition : choisissez une clé qui regroupe ce qui doit rester ordonné (compte, appareil, session) et répartit le reste. Les partitions ont des leaders différents, ce qui permet d'exploiter chaque nœud.
- Réglez la réplication de façon délibérée.
x-initial-cluster-sizeà la déclaration détermine le nombre de membres. Trois pour tout ce qui compte, un pour une ingestion temporaire rejouable. - Placez les membres sur des disques locaux rapides. Du NVMe plutôt que des volumes réseau, sans partage avec les données des quorum queues.
- Dimensionnez la rétention selon votre schéma de rejeu. Une rétention courte si les consommateurs restent près de la tête du journal ; une rétention modérée et beaucoup de RAM s'ils remontent de plusieurs heures. Le dimensionnement du cluster lui-même est traité dans notre FAQ sur le dimensionnement pour la haute disponibilité et la reprise après sinistre.
- Validez les offsets à intervalle régulier. Toutes les quelques secondes ou tous les quelques milliers de messages.
- Tenez les consommateurs AMQP à l'écart des streams à haut débit. Acceptable pour un tableau de bord, inadapté pour le consommateur principal.
- Surveillez les bonnes métriques. L'interface de gestion affiche, par stream, les éditeurs, les consommateurs et le nœud leader ; l'endpoint Prometheus exporte le nombre de connexions stream, d'éditeurs et de consommateurs, ainsi que les débits de messages et d'octets au niveau des files. Le retard des consommateurs est une valeur côté client : exportez-la depuis l'application.
Une politique de rétention se présente ainsi :
rabbitmqctl set_policy stream-events "^events\." \
  '{"max-age":"7D","max-length-bytes":50000000000}' --apply-to queues
Les deux erreurs que nous voyons le plus souvent. D'abord, un seul stream pour tout : un leader unique plafonné sur un seul nœud, chaque consommateur qui filtre côté client, et un rejeu qui lit des téraoctets pour retrouver un seul tenant. Partitionnez avec un super stream ou utilisez plusieurs streams. Ensuite, traiter un stream comme une file : attendre des acquittements par message, des consommateurs concurrents qui se partagent le travail, des messages qui disparaissent une fois traités. Un stream conserve tout jusqu'à l'expiration de la rétention, chaque consommateur lit tout, et les acquittements n'existent pas. Si la charge de travail appelle une sémantique de file, il lui faut une quorum queue ou une file classique, pas un stream.
Si vos streams sont plus lents qu'ils ne devraient l'être, le support RabbitMQ analysera avec vous la configuration et les métriques ; le conseil RabbitMQ couvre la refonte lorsque c'est la topologie qui pose problème.
Parlez à un ingénieur AceMQ
Si la question derrière cet article relève de l'architecture plutôt que d'un incident en cours (stratégie de partitionnement, dimensionnement, conception de la sécurité, migration), le conseil Kafka d'AceMQ y affecte un ingénieur senior attitré.
FAQ
Quelle est la différence entre Kafka et RabbitMQ Streams ?
Tous deux fournissent un journal rejouable en ajout seul. RabbitMQ Streams est un type de file au sein d'un broker de messages qui assure aussi un routage avancé ; Kafka est une plateforme dédiée de streaming d'événements distribuée, conçue pour un très haut débit et une longue rétention.
RabbitMQ est-il plus simple à utiliser que Kafka ?
En général, oui. Son modèle repose sur les notions familières de producteur et de consommateur, l'interface de gestion est simple, et un cluster se met en place rapidement. Kafka exige de maîtriser partitions, groupes de consommateurs, offsets et rééquilibrage avant la mise en production.
Kafka ou RabbitMQ : l'un peut-il remplacer l'autre ?
Pour du pub/sub simple, souvent oui. Pour tout ce qui nécessite du routage, un TTL par message, des priorités ou du dead-lettering, vous finissez par reconstruire des fonctionnalités de broker dans le code applicatif.
RabbitMQ Streams peut-il remplacer Kafka ?
Pour des volumes modérés avec des besoins de rejeu, oui. Avec un débit soutenu très élevé et une longue rétention, ou si vous avez besoin de Connect et de l'API Streams, Kafka reste mieux adapté.
Quel système de messagerie est le plus performant ?
Kafka pour le débit soutenu ; RabbitMQ est souvent meilleur pour la latence par message, car Kafka regroupe les messages par lots pour privilégier le débit. Tout dépend de votre contrainte : le volume ou le temps de réponse.
Les streams prennent-ils en charge le partitionnement ?
Oui, grâce aux super streams, qui répartissent un stream logique sur plusieurs streams pour une consommation parallèle. Cela fonctionne bien, même si le modèle de partitions de Kafka est plus mature.
Faut-il utiliser à la fois RabbitMQ et Kafka ?
C'est une architecture courante et valable : RabbitMQ pour le routage et le trafic de commandes, Kafka pour le pipeline d'événements à fort volume. Le prix à payer est l'exploitation de deux systèmes : ne le faites que si les charges de travail diffèrent réellement.
Quand utiliser une quorum queue plutôt qu'un stream ?
Quand le travail est consommé une fois puis supprimé. Les quorum queues conviennent à la distribution de tâches ; les streams au rejeu et aux lecteurs multiples et indépendants. Utiliser un stream pour un simple traitement de tâches ajoute du coût disque et de la complexité sans aucun bénéfice.
Quelles performances attendre des streams RabbitMQ ?
Elles sont telles que c'est le protocole utilisé qui fixe la limite, pas le stream. Avec le protocole stream natif sur le port 5552, le batching côté éditeur et un client stream, un seul stream sur du matériel ordinaire atteint des centaines de milliers de messages par seconde, et un cluster avec plusieurs streams ou un super stream atteint plusieurs millions. Le même stream lu via AMQP 0-9-1 est un ordre de grandeur plus lent, car chaque message passe par la livraison sur canal, le prefetch et l'acquittement. La latence des confirmations est bornée par l'écriture disque du réplica le plus lent, généralement quelques millisecondes sur du NVMe local.
Comment améliorer les performances des streams RabbitMQ ?
Basculez d'abord le chemin critique sur le protocole stream et un client stream : ce changement éclipse tout le reste. Ensuite, publiez par lots avec des confirmations asynchrones, laissez plusieurs chunks de crédit consommateur en attente et validez les offsets à intervalle régulier plutôt qu'à chaque message. Si un stream sature son leader, scindez-le en super stream avec une clé de partition qui préserve l'ordre dont vous avez besoin. Placez trois membres sur du NVMe local, définissez la rétention avec max-age ou max-length-bytes, et tenez les consommateurs AMQP à l'écart des streams les plus sollicités. Vérifiez dans l'interface de gestion quel nœud porte chaque leader.

Auteur
Guides, comparatifs et études
Approfondir : Kafka
Guides
3Comparatifs
9- NATS vs Kafka en 2026 : comparatif Core NATS, JetStream et Kafka
- Mosquitto vs Kafka : broker MQTT ou journal d'événements ?
- Kafka vs Kinesis : le comparatif
- Meilleurs fournisseurs Kafka managé en 2026, au-delà des hyperscalers
- Kafka Bring Your Own Cloud (BYOC) : les offres comparées
- Alternatives à Confluent et concurrents après le rachat par IBM