
Sur cette page
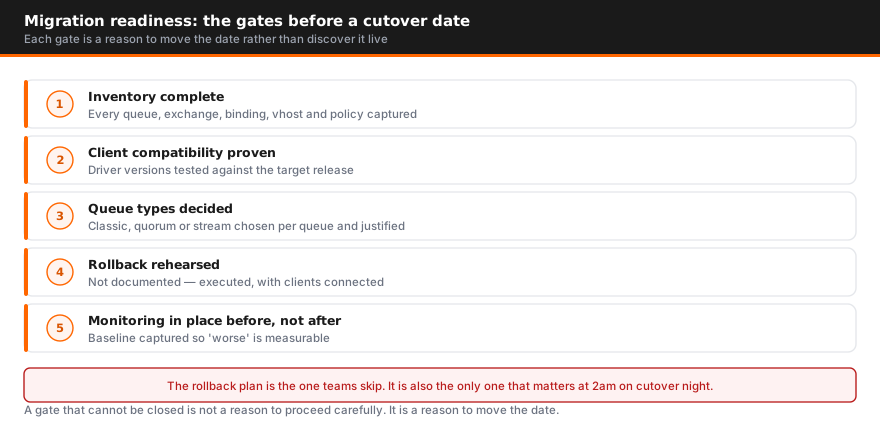
Une évaluation de préparation à la migration RabbitMQ est un point de contrôle ponctuel, mené avant une montée de version majeure, un changement de plateforme ou une évolution d'architecture, et non un bilan de santé continu. Elle confirme que votre topologie et vos dépendances sont entièrement inventoriées, que vous savez ce qui casse si une étape échoue, que vous disposez d'un retour arrière testé et que l'environnement cible peut absorber la charge réelle de production.
La plupart des équipes qui se brûlent les doigts lors d'une migration RabbitMQ n'exploitaient pas un cluster défaillant auparavant. Elles avaient un environnement stable, un plan raisonnable et une date de mise en production, et ont découvert en pleine bascule que la topologie d'une file d'attente n'existait que dans la tête d'un seul ingénieur, qu'un consommateur en aval utilisait encore une bibliothèque cliente vieille de trois versions majeures, ou que leur plan de retour arrière se résumait à « restaurer depuis la sauvegarde », sans aucune idée du temps que cela prendrait réellement sous charge.
C'est précisément ce qu'une évaluation structurée de préparation à la migration est conçue pour détecter, avant l'ouverture de la fenêtre de maintenance plutôt que pendant.
Qu'est-ce qu'une évaluation de préparation à la migration RabbitMQ ?
C'est une revue au périmètre fixe, liée à un changement planifié précis : une montée de version, un passage sur une nouvelle infrastructure (Kubernetes, un nouveau datacenter, une nouvelle région cloud) ou une évolution d'architecture comme l'ajout d'une réplication fédérée pour le plan de reprise d'activité. Ce n'est ni un abonnement ni un outil de supervision.
Le livrable est une feuille de route de migration et un rapport de préparation assortis d'une recommandation claire : go, go après des correctifs précis, ou pas encore. Ils couvrent chaque charge de travail touchée par la migration, pas seulement le broker. C'est un livrable différent de celui d'un bilan de santé classique, et mieux vaut bien cerner la différence avant d'en cadrer un.
En quoi une évaluation de préparation à la migration diffère-t-elle d'un bilan de santé RabbitMQ classique ?
Leurs méthodes se recoupent (toutes deux examinent la configuration du cluster, la topologie des files et l'état des versions), mais elles répondent à des questions différentes. Un bilan de santé RabbitMQ pose la question : « ce déploiement est-il sain aujourd'hui, et que faut-il corriger de manière générale ? » Il est réalisé périodiquement, indépendamment de tout changement prévu, et ses constats (classic mirrored queues, utilisateurs dotés de permissions excessives, heartbeats mal configurés) s'appliquent que vous migriez quelque chose ou non.
Une évaluation de préparation à la migration pose une question plus étroite et aux enjeux plus élevés : « pouvons-nous exécuter cette bascule précise, à cette date, sans interruption de service ni perte de données, et sinon, que faut-il changer d'abord ? » Ce cadrage change les livrables. Une évaluation de préparation produit un plan de retour arrière calé sur les étapes exactes de la migration, un registre des risques indiquant ce qui casse et dans quelles conditions, et des tests de charge menés sur la configuration cible, et pas seulement un instantané de la santé actuelle. Si vous ne prévoyez pas de bascule précise, c'est le bilan de santé qu'il vous faut. Si une montée de version ou un changement de plateforme figure au calendrier, c'est plutôt cette évaluation.
Que doit réellement recenser l'inventaire préalable à la migration ?
L'inventaire est la partie que les équipes sous-estiment le plus systématiquement, car l'essentiel se trouve en dehors de la configuration du broker lui-même. Quatre éléments doivent être recensés avant de pouvoir planifier une migration avec un minimum d'assurance :
- La topologie des files, exchanges et bindings, et si elle est définie dans l'automatisation. Nous avons récemment accompagné une société de traitement des paiements dont l'installation du cluster était entièrement automatisée, mais dont les files, les exchanges et les liens de federation avaient été créés à la main et n'existaient nulle part dans le code. C'est une lacune courante : la topologie ne peut alors pas être reconstruite de façon fiable sur un nouveau cluster sans que quelqu'un la reconstitue manuellement à partir du système en production.
- Les dépendances aux plugins. Federation, shovel et tout plugin personnalisé ou fourni par un éditeur doivent être vérifiés un par un par rapport à la version cible de RabbitMQ : un plugin compatible avec votre version actuelle ne l'est pas automatiquement avec celle vers laquelle vous migrez.
- Les versions des bibliothèques clientes et des runtimes de chaque application consommatrice. Pas la version du broker : celle du client. Les applications qui tournent sur d'anciennes bibliothèques clientes ou des runtimes obsolètes embarquent souvent des réglages de connexion, de threads ou de mémoire sous-dimensionnés, qui ne posent problème qu'une fois que les profils de trafic ou le comportement du broker changent pendant une migration.
- La compatibilité des types de files et des versions. Les classic mirrored queues sont en voie de dépréciation à l'approche des nouvelles versions majeures de RabbitMQ, et la prise en charge des versions d'Erlang/OTP dépend de votre version de RabbitMQ : l'édition communautaire de la 3.13.x, par exemple, ne prend pas en charge le runtime Erlang 27, ce qui impose une discussion sur les licences à toute équipe qui veut rester à jour sans montée de version complète.
Rien de tout cela n'est exotique. C'est simplement assez fastidieux pour que les équipes pressées par une échéance fassent l'impasse, puis le redécouvrent en direct pendant la migration.
Comment évaluer les risques avant une migration RabbitMQ : qu'est-ce qui casse vraiment ?
Évaluer les risques d'une migration, c'est examiner des conditions de défaillance précises, et non produire une liste générique classée par gravité. La version utile de cet exercice répond à la question suivante : pour chaque étape de la migration, qu'est-ce qui casse si elle échoue, et à quoi ressemble cette défaillance en aval ?
Un exemple concret, tiré d'un projet de réplication pour le plan de reprise d'activité que nous avons cadré avec un client de traitement des paiements : l'approche proposée utilisait des federated exchanges pour répliquer les messages vers un site secondaire. Les federated exchanges répliquent les messages, pas l'état du broker. Si le site de secours tombe, les messages à répliquer s'accumulent donc localement au lieu d'être perdus, mais un véritable exercice de reprise peut impliquer de résorber un backlog de plusieurs centaines de milliers de messages une fois le lien rétabli. Ce trafic de rattrapage retombe directement sur le cluster de production et doit être anticipé, faute de quoi il devient un incident à part entière.
Voilà à quoi ressemble une vraie évaluation des risques : garanties d'ordre des messages, hypothèses d'idempotence côté consommateur, risque qu'une reconnexion après une panne déclenche un backlog assez important pour affecter le débit de production, et capacité réelle des applications clientes à gérer correctement les relivraisons, plutôt que de supposer un comportement exactly-once qui ne leur a jamais été garanti. Chacun de ces points est propre à votre architecture et à vos applications : une checklist générique ne les fera pas apparaître, mais dérouler la migration étape par étape, si.
Que doit contenir un plan de retour arrière ?
« Restaurer depuis la sauvegarde » n'est pas un plan de retour arrière pour un système de messagerie en production : cela ne dit ni combien de temps prend la reprise, ni quels messages sont perdus dans l'intervalle, ni comment se comportent les consommateurs en aval pendant ce temps. Un vrai plan de retour arrière définit, pour chaque étape de la migration, la condition de déclenchement précise qui impose d'abandonner et l'action d'annulation précise de cette étape.
En pratique, l'approche qui fonctionne consiste à faire tourner l'environnement actuel et l'environnement cible en parallèle plutôt que de migrer sur place. Montez le nouveau cluster à côté de l'ancien, basculez les applications consommatrices par vagues, et gardez l'ancien cluster en service et alimenté en trafic jusqu'à ce que les vagues migrées aient prouvé leur stabilité, souvent sur tout un cycle de pic de trafic. Si une vague pose problème, vous redirigez ce groupe de consommateurs vers l'ancien cluster sans toucher à ce qui a déjà migré avec succès. Cela ne fonctionne que si le chemin de retour arrière a été conçu dès le départ ; il est très difficile de l'ajouter après coup une fois la bascule entamée.
Si vous ne pouvez pas énoncer en une phrase l'action de retour arrière d'une étape donnée, cette étape n'est pas prête à être exécutée.
Si la montée de version est aussi l'occasion de passer à une version supportée, la page licences commerciales RabbitMQ détaille ce que comprend une souscription commerciale et comment elle est tarifée.
Comment valider la charge et la capacité avant la bascule ?
Les tests de charge avant une migration doivent reposer sur votre trafic réel, et non sur un benchmark synthétique. Récupérez l'historique de la profondeur des files et des débits de messages depuis les outils dont vous disposez déjà (Prometheus, Grafana, Dynatrace ou l'API de management de votre broker) afin d'établir un profil réaliste du débit de pointe, des rafales et de la distribution des tailles de messages avant de concevoir le test.
Deux points méritent d'être testés alors que les équipes les négligent souvent. D'abord, testez à votre pic réel, pas à la charge moyenne : une plateforme de paiement que nous avons accompagnée cadrait une approche de réplication qui devait soutenir environ 2 000 messages par seconde en continu, et la seule réponse honnête à la question de savoir si federation tiendrait ce débit sous les contraintes réseau passait par de vrais tests de charge, pas par une estimation. Ensuite, testez la résorption d'un backlog, pas seulement le débit en régime établi. Un cluster qui encaisse sans peine le trafic normal peut tout de même peiner lorsqu'il doit traiter simultanément un backlog de rattrapage et le trafic en direct, ce qui est exactement la situation dans laquelle vous place une bascule ratée ou un retour depuis le site de secours.
Si votre architecture cible change de type de file, ajoute un saut de réplication ou passe sur une infrastructure sous-jacente différente, la marge de capacité de l'ancien système ne se reporte pas automatiquement. Validez-la avant la date de mise en production, pas pendant.
Quelles dépendances aux plugins et aux bibliothèques clientes passent le plus souvent inaperçues ?
Au-delà de l'inventaire de base, quelques problèmes de dépendances reviennent de manière disproportionnée une fois les équipes en pleine migration :
- La dérive de version des plugins federation et shovel. Ces plugins sont livrés indépendamment du cœur du broker et doivent être revérifiés par rapport à la version cible : ne supposez pas que la compatibilité se maintient.
- La compatibilité Erlang/OTP liée aux licences. Sur la série stable actuelle, RabbitMQ communautaire cesse avec le temps de recevoir des correctifs pour les anciens runtimes Erlang, et le passage à une version majeure plus récente d'Erlang est parfois conditionné à une licence commerciale selon votre série RabbitMQ. Ce point surgit lors de la planification des migrations bien plus souvent que les équipes ne s'y attendent, et peut transformer une simple montée de version technique en discussion d'achat assortie d'une échéance.
- Des valeurs par défaut de connexion et de timeout côté client réglées pour l'ancien environnement. Des réglages de heartbeat et de timeout TCP pensés pour un réseau on-premise à faible latence provoquent de fausses déconnexions dès qu'une migration fait transiter le trafic entre zones de disponibilité ou par une passerelle NAT : un changement à repérer avant la bascule plutôt qu'à déboguer ensuite comme un incident mystérieux.
- Des applications qui tournent encore sur d'anciennes bibliothèques clientes ou d'anciens runtimes. Elles embarquent souvent des valeurs par défaut prudentes (par exemple des réglages mémoire de la JVM très inférieurs à ce dont dispose réellement le conteneur) qui plafonnent discrètement le débit et n'apparaissent que lorsque vous cherchez à atteindre un objectif de performance précis pendant les tests de migration.
Combien de temps dure une évaluation de préparation, et qu'obtient-on à la fin ?
Le périmètre détermine le calendrier. Une montée de version sur un seul cluster avec un petit nombre d'applications consommatrices représente généralement une mission d'une semaine. Un déploiement multirégion avec federation, des plugins personnalisés et des dizaines d'applications consommatrices demande plus de temps pour être correctement inventorié, évalué sur le plan des risques et testé en charge : généralement deux à trois semaines.
Dans les deux cas, vous devez repartir avec :
- Un inventaire complet de la topologie, des plugins et des bibliothèques clientes : la référence sur laquelle repose le plan de migration
- Un registre des risques décrivant des conditions de défaillance précises et leur impact en aval, et non une liste générique classée par gravité
- Un plan de retour arrière avec un déclencheur défini et une action d'annulation pour chaque étape de la migration
- Les résultats des tests de charge sur la configuration cible, y compris les scénarios de résorption de backlog
- Une recommandation go/no-go, avec les éventuels points bloquants classés par priorité avant la date de bascule
- Des critères de validation post-migration et une courte passe d'optimisation une fois que le cluster cible porte du trafic réel
Mettez le coût de cette mission en regard du coût total de possession qu'implique de s'en passer : un retour arrière non planifié sous charge de production coûte presque toujours plus cher que l'évaluation elle-même. Si vous préparez une montée de version, un changement de plateforme ou une évolution d'architecture et souhaitez un point de contrôle structuré avant de vous engager sur une date de bascule, notre équipe RabbitMQ mène ces évaluations en parallèle des migrations elles-mêmes. Parlez-nous de votre calendrier pour en cadrer une.
Cette checklist est la deuxième des sept étapes du guide de migration RabbitMQ, qui enchaîne la décision, l'inventaire, la correspondance sémantique, la construction de la cible, la bascule et la validation.
FAQ
Qu'est-ce qu'une évaluation de préparation à la migration RabbitMQ ?
Une revue ponctuelle menée avant une montée de version majeure, un changement de plateforme ou une évolution d'architecture. Elle inventorie votre topologie et vos dépendances actuelles, identifie ce qui casse si la migration tourne mal, produit un plan de retour arrière testé et vérifie que l'environnement cible peut absorber la charge réelle de production, avant de conclure par une recommandation go/no-go.
En quoi une évaluation de préparation à la migration diffère-t-elle d'un bilan de santé RabbitMQ classique ?
Un bilan de santé est un instantané périodique de la santé opérationnelle (dimensionnement du cluster, socle de sécurité, dérive de configuration), réalisé indépendamment de tout changement prévu. Une évaluation de préparation à la migration porte sur une bascule précise, avec une échéance ferme, et produit des livrables qu'un bilan de santé ne fournit pas : un plan de retour arrière, un registre des risques de la bascule et des tests de charge sur l'état cible, et pas seulement sur l'état actuel.
Que doit couvrir l'inventaire de l'existant ?
Chaque file d'attente, exchange et binding, en précisant si cette topologie est définie dans l'automatisation ou n'existe que sous forme de configuration manuelle non documentée ; chaque plugin utilisé, y compris federation, shovel et tout plugin personnalisé ou développé en interne ; et la version de la bibliothèque cliente et du runtime de chaque application qui publie ou consomme, pas seulement la version du broker.
Que doit réellement contenir un plan de retour arrière ?
Un déclencheur défini (la métrique ou la condition de défaillance précise qui impose d'abandonner) et, pour chaque étape, la manière de l'annuler, et non un générique « restaurer depuis la sauvegarde ». En pratique, cela consiste généralement à faire tourner l'ancien et le nouvel environnement en parallèle et à migrer les groupes de consommateurs par vagues, afin de pouvoir rediriger n'importe quelle vague sans toucher à celles qui ont déjà réussi.
Faut-il quand même des tests de charge si nous ne changeons pas de matériel ?
Oui. Une montée de version ou un changement de topologie (par exemple le passage des classic mirrored queues aux quorum queues, ou l'ajout d'un chemin de réplication pour le plan de reprise d'activité) modifie le comportement du broker sous charge, même sur un matériel identique. Testez sur votre débit de pointe réel et sur des scénarios de résorption de backlog, pas seulement sur un trafic en régime établi.
Combien de temps dure une évaluation de préparation à la migration RabbitMQ ?
En général une à trois semaines, selon le nombre de clusters et la complexité de la topologie. Une montée de version sur un seul cluster avec quelques applications consommatrices se cadre en une semaine environ ; un déploiement multirégion avec federation, des plugins personnalisés et des dizaines d'applications consommatrices demande plus de temps pour être correctement inventorié et testé en charge.
Qu'est-ce qui rend généralement ce type d'évaluation nécessaire ?
Une montée de version majeure (surtout si elle change le type de file par défaut ou la compatibilité Erlang), un changement de plateforme, par exemple vers Kubernetes ou un nouveau datacenter, une évolution d'architecture comme l'ajout d'une réplication pour le plan de reprise d'activité, ou un changement de licence qui impose un saut de version à échéance fixe.

Auteur
Parler à un ingénieur
Besoin d’un coup de main sur RabbitMQ ?
Des ingénieurs seniors qui l’exploitent en production. Demandez un devis ou une consultation gratuite, sans argumentaire commercial.
Guides, comparatifs et études
Approfondir : RabbitMQ
Guides
13- Le guide d'optimisation des performances RabbitMQ
- Le guide des streams RabbitMQ
- Le guide de fiabilité RabbitMQ : dix schémas de panne et leurs correctifs
- Le guide de reprise après sinistre RabbitMQ
- Le guide du clustering et du dimensionnement RabbitMQ
- Le guide RabbitMQ sur Kubernetes
Afficher 7 de plusAfficher moins
- Le guide de sécurité et de durcissement de RabbitMQ
- Le guide de la supervision et des alertes RabbitMQ
- RabbitMQ pour les agents IA : patterns, mise en place et pièges
- Celery et RabbitMQ pour les files de tâches LLM
- Dépannage RabbitMQ : arbre de décision
- Runbook de mise à niveau RabbitMQ 3.x vers 4.x
- Programme de formation RabbitMQ : modules de l'atelier, prérequis et labs
Comparatifs
9- RabbitMQ communautaire, Tanzu RabbitMQ ou support tiers ?
- Meilleurs prestataires de support RabbitMQ : comparatif (2026)
- RabbitMQ vs Amazon SQS : le comparatif
- RabbitMQ vs Redis : comparatif
- Fournisseurs RabbitMQ comparés : Amazon MQ, CloudAMQP, Stackhero, Northflank, Tanzu et AceMQ
- Options de support des brokers de messages comparées


