
En esta página
Elija una estrategia de particiones en Kafka ajustando la lógica de particionamiento a sus requisitos de orden y throughput: use particionamiento por clave cuando los mensajes relacionados deban llegar en orden, el sticky partitioner predeterminado cuando una carga uniforme importe más que el orden de los mensajes, y un partitioner personalizado solo cuando tenga reglas de enrutamiento que ninguno de los dos pueda expresar. Luego dimensione el número de particiones a partir del throughput medido (throughput objetivo del topic dividido por el throughput por partición, redondeado hacia arriba con un margen de 2–3x), porque el paralelismo de los consumidores está limitado por el número de particiones y reducirlas después es prácticamente imposible.
Esa respuesta de dos frases esconde mucho dolor operativo. Una estrategia de particiones equivocada es uno de los errores más caros que cometen los equipos con Apache Kafka, porque la distribución de particiones de un topic es casi inmutable una vez que circula tráfico real. Esta guía explica cómo elige Kafka qué partición recibe cada mensaje, el cálculo para dimensionar el número de particiones, cómo funciona la asignación de particiones a los consumidores y cómo corregir las particiones calientes antes de que tumben un clúster.
¿Qué es una estrategia de particiones en Kafka?
Una estrategia de particiones en Kafka es el conjunto de decisiones que controlan cómo se reparten los datos entre las particiones de un topic: cuántas particiones tiene el topic de Kafka, qué clave de partición usan los productores (si usan alguna) y qué algoritmo de particionamiento asigna cada registro a una partición específica. Cada partición de Apache Kafka es un log ordenado de solo escritura al final (append-only), y Kafka solo garantiza el orden dentro de una partición, nunca entre particiones. Esa única restricción guía casi todas las decisiones que se analizan a continuación.
Las particiones existen para que Kafka pueda escalar el streaming de datos de forma horizontal. Repartir las particiones entre varios brokers permite que un clúster de Kafka absorba un volumen de datos que ninguna máquina por sí sola podría asumir, y que un grupo de consumidores divida el trabajo de procesamiento, con cada consumidor a cargo de un subconjunto de particiones. En resumen: las particiones son la unidad de paralelismo, de orden y de distribución de carga en el clúster de Kafka, y por eso elegir una estrategia de particionamiento merece tiempo real de diseño antes de producir el primer byte.
Cómo elige Kafka qué partición recibe un mensaje
La partición la determinan los productores, no los brokers. Cuando usted envía un registro, el partitioner del productor se ejecuta del lado del cliente y decide dónde cae. Hay tres estrategias de particiones en Kafka que conviene conocer.
Particionamiento por clave (el predeterminado cuando hay clave)
Cuando un registro tiene una clave no nula, Kafka usa murmur2(key) % numPartitions para determinar la partición. Los mensajes con la misma clave siempre se enrutan a la misma partición, lo que preserva el orden para esa clave: todos los eventos de customer-42 caen en el mismo log, en orden. Esta es la estrategia de particionamiento correcta siempre que los mensajes relacionados deban procesarse de forma secuencial: ciclos de vida de pedidos, saldos de cuentas, eventos de sesión y cualquier cosa destinada a joins y agregaciones de Kafka Streams, que requieren topics de entrada co-particionados.
La contrapartida: la distribución de sus particiones es tan buena como la cardinalidad de sus claves. Elegir claves de partición con pocos valores distintos (código de país, estado del pedido) concentra el tráfico en un puñado de particiones y deja sin carga al resto.
Particionamiento round-robin y sticky (clave nula)
Con una clave nula, los clientes antiguos reparten los registros en round-robin, de uno en uno, a cada partición por turnos. Desde Kafka 2.4 (KIP-480), la estrategia predeterminada para registros sin clave es el sticky partitioner: llena un lote en una partición y luego cambia, lo que mantiene los registros repartidos de forma uniforme entre las particiones y produce muchos menos lotes, más grandes; el resultado es menor latencia y mejor compresión que el round-robin puro. Use claves nulas cuando no necesite orden por clave y solo quiera el máximo throughput, equilibrado de forma uniforme.
Partitioners personalizados
Implementar la interfaz Partitioner le permite controlar directamente la estrategia de particiones. Los equipos usan partitioners personalizados para enrutar los mensajes de alta prioridad a la partición 0 mientras el tráfico masivo se reparte de la partición 1 en adelante, para fijar un cliente a un rango de particiones o para calcular el hash sobre un campo dentro del payload. Especificar de forma explícita una partición por registro en el ProducerRecord logra lo mismo de manera puntual. Ambas son armas de doble filo: un partitioner personalizado que ignora los cambios en el número de particiones, o que sesga la carga, saboteará el topic en silencio. Pruébelo contra la semántica de la documentación oficial de Kafka antes de que llegue a producción.
¿Cuántas particiones? El cálculo del tamaño
La fórmula más citada para el número de particiones viene de Confluent: con un throughput objetivo T, un throughput medido del productor por partición P y un throughput por consumidor C, necesita al menos:
partitions = max(T / P, T / C)
Supongamos que necesita 100 MB/s a través del topic, que una sola partición sostiene 25 MB/s en su hardware y que un consumidor procesa 10 MB/s después de hacer trabajo real (deserialización, enriquecimiento, escrituras en base de datos). Entonces max(100/25, 100/10) = 10 particiones como mínimo. En la práctica domina el cálculo del lado del consumidor, porque los consumidores hacen un procesamiento de datos más pesado que la ruta append-only del broker. Haga un benchmark de ambos números en su propia infraestructura de Kafka: el tamaño de los mensajes, la compresión, el factor de replicación y acks cambian drásticamente el throughput por partición.
Después añada margen. El número de particiones se dimensiona según la carga pico proyectada, no según el promedio de hoy, porque aumentar las particiones más adelante rompe el orden por clave (más sobre esto abajo). Una buena práctica común es usar 2–3x el mínimo calculado, redondeado a un número divisible por los números probables de consumidores (12, 24, 30), para que las particiones se repartan de forma uniforme entre los consumidores de Kafka.
Referencia rápida para dimensionar particiones
| Throughput objetivo | Límite del productor por partición | Límite por consumidor | Mínimo | Recomendado (con margen) |
|---|---|---|---|---|
| 10 MB/s | 25 MB/s | 10 MB/s | 1 | 6–12 |
| 50 MB/s | 25 MB/s | 10 MB/s | 5 | 12–15 |
| 100 MB/s | 25 MB/s | 10 MB/s | 10 | 24–30 |
| 500 MB/s | 25 MB/s | 10 MB/s | 50 | 100–120 |
| 1 GB/s | 25 MB/s | 10 MB/s | 100 | 200–240 |
Muy pocas particiones limitan el throughput y el paralelismo de los consumidores. Demasiadas particiones también tienen un coste: más file handles abiertos y más memoria en cada broker, elecciones de líder más largas, más tráfico de replicación y rebalanceos más lentos. Un topic con 10x más particiones de las que jamás necesitará es deuda técnica que se paga en cada failover.
Grupos de consumidores, paralelismo y asignación de particiones
El número de particiones es un límite estricto para el paralelismo de lectura. Dentro de un grupo de consumidores, cada partición se asigna exactamente a un consumidor, así que un topic con 12 particiones admite como máximo 12 consumidores activos: el número 13 queda inactivo. Si el número de consumidores que llegará a necesitar supera su número de particiones, ningún escalado horizontal sirve. Por eso el número de particiones se planifica en función del paralelismo posterior y no solo de la capacidad de los brokers.
La asignación de particiones a los consumidores se rige por estrategias de asignación intercambiables: range (el valor predeterminado histórico, propenso a desequilibrios entre varios topics), round-robin, sticky y el moderno CooperativeStickyAssignor. La opción cooperativa importa en la operación: el rebalanceo eager clásico es stop-the-world (cada consumidor se detiene, entrega sus particiones y vuelve a unirse) y, en grupos grandes, esa pausa genera picos de lag de consumidores y timeouts aguas abajo. El rebalanceo cooperativo mueve solo las particiones que deben moverse. Si usa Kafka 2.4+ y todavía no ha hecho el cambio, ese único ajuste de configuración suele ser la mejora de latencia más barata disponible.
Las tormentas de rebalanceo también son el lugar donde los problemas de estrategia de particiones aparecen a las 3 de la mañana: un consumidor lento no cumple su plazo de poll, dispara un rebalanceo, el lag crece, más consumidores agotan su timeout y el grupo entra en un ciclo sin fin. Si su equipo está apagando incendios de ciclos de rebalanceo o de lag inexplicable de consumidores en este momento, el soporte de Kafka 24/7 de AceMQ asigna a su incidente un ingeniero sénior de Kafka con objetivos de respuesta desde 15 minutos, según el plan: la diferencia entre un tropiezo y una caída que se mide en horas.
Particiones calientes: causas y soluciones
Una partición caliente recibe una porción desproporcionada del tráfico, y es el modo de fallo clásico del particionamiento por clave. Causas comunes:
- Claves de baja cardinalidad: calcular el hash sobre
countrycuando el 60 % del tráfico corresponde a un país envía la mayoría de los registros a una sola partición. - Claves "celebridad": un cliente, dispositivo o usuario genera órdenes de magnitud más eventos que el resto, y todos van a la misma partición.
- Partitioners personalizados sesgados: enrutamiento hecho a mano que concentra la carga en la partición 0 o en un rango pequeño.
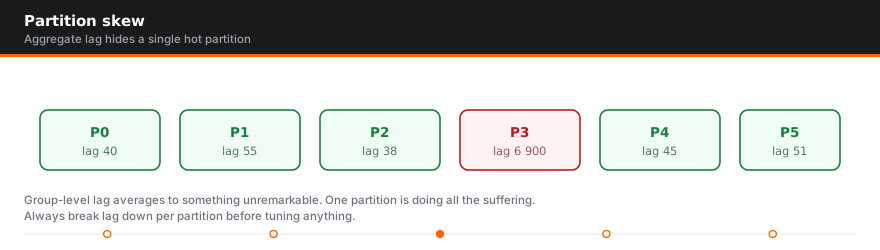
Los síntomas: un broker trabaja al límite mientras otros están ociosos, un consumidor acumula lag mientras sus pares están al día y la latencia de producción sube para un subconjunto de claves. Para corregir una partición caliente:
- Cambie a una clave de mayor cardinalidad. Use
userIden lugar deregion, o una clave compuesta comotenantId:deviceId, para que el hash reparta la carga y cada entidad caiga en una partición adecuada. - Aplique salting a las claves calientes. Añada un pequeño sufijo aleatorio (
bigTenant-0…bigTenant-7) para repartir una clave caliente entre varias particiones, aceptando que ahora deberá volver a agregar los datos, ya que el orden solo se mantiene por cada clave con salt. - Separe a la "ballena". Enrute a su cliente más grande a un topic dedicado con su propia estrategia de particiones, dimensionado solo para su tráfico.
- Elimine la clave por completo donde el orden no sea realmente necesario: muchos pipelines usan claves por costumbre y pagan una penalización por sesgo a cambio de una garantía que nadie aprovecha. El sticky partitioner equilibrará el tráfico sin clave casi a la perfección.
Monitorice la salud de las particiones antes de que lo noten los usuarios: tasa de producción y tamaño del log por partición (sesgo de bytes-in), lag de consumidores por partición y desequilibrio de disco/red entre brokers. Alertar sobre el sesgo del throughput por partición (por ejemplo, cualquier partición que sostenga 3x la mediana del topic) detecta la mayoría de los incidentes de particiones calientes cuando todavía es barato optimizar.
Por qué reparticionar duele (planifique con antelación)
Puede aumentar el número de particiones de un topic de Kafka en producción con kafka-topics.sh --alter, pero no puede reducirlo, nunca. Y aumentarlo no es la solución inofensiva que parece: hash(key) % numPartitions cambia en el momento en que cambia el número, así que las claves existentes empiezan a asignarse a otra partición. Los eventos antiguos de customer-42 quedan en la partición 3 mientras los nuevos caen en la partición 7. El orden de los mensajes para esas claves se rompe en la unión, y cualquier estado de Kafka Streams construido a partir de ese topic debe reconstruirse o migrarse.
La solución honesta para un topic con clave mal particionado es una migración completa: crear un topic nuevo con el número correcto, replicar los datos, pasar los consumidores y retirar el original. Eso son días de trabajo cuidadoso en un clúster de producción con mucho tráfico, y precisamente por eso una planificación de particiones de Kafka bien hecha desde el principio, con margen, vale 10x el esfuerzo de la limpieza.
KRaft y los límites de particiones: qué cambió KIP-500
El antiguo plano de control de Kafka basado en ZooKeeper imponía un techo práctico al número de particiones a nivel de clúster (se suele citar alrededor de 200.000 particiones), porque más allá de ese punto el failover del controlador y la propagación de metadatos se volvían lentísimos. KIP-500 reemplazó ZooKeeper por KRaft, un quórum de metadatos integrado basado en Raft, que es el único modo admitido a partir de Kafka 4.0. KRaft guarda los metadatos en un log de eventos interno, de modo que un nuevo controlador toma el relevo en un tiempo casi constante y los clústeres escalan a millones de particiones.
Lo que KRaft no cambia: el cálculo del tamaño por topic, las particiones calientes, la semántica de orden ni el dolor de reparticionar. Eleva el techo de la gestión de particiones de Kafka a escala de clúster, pero no hace que la estrategia de cada topic sea menos determinante. En todo caso, migrar un clúster heredado de ZooKeeper a KRaft es en sí un proyecto en el que arrastrar errores de distribución de particiones sale caro.
Buenas prácticas de estrategia de particiones en Kafka
- Haga un benchmark del throughput real por partición en sus propios brokers de Kafka; no reutilice los números de otros.
- Dimensione el número de particiones con
max(T/P, T/C)más un margen de 2–3x, divisible por el número de consumidores que espera. - Use claves solo cuando necesite orden por clave; de lo contrario, deje que el sticky partitioner asigne los registros sin clave para conseguir el máximo equilibrio.
- Mantenga una cardinalidad de claves de al menos 10–100x el número de particiones para que la distribución sea uniforme.
- Use
CooperativeStickyAssignorpara acortar las pausas de rebalanceo. - Monitorice el lag por partición, el sesgo de bytes-in y el desequilibrio entre brokers, y alerte sobre el sesgo, no solo sobre los totales.
- Documente la estrategia de particiones de cada topic para que el próximo ingeniero no "corrija" una decisión deliberada.
Hacerlo bien es un problema de diseño; mantenerlo bien a las 2 de la mañana es un problema de operaciones. Los ingenieros sénior de AceMQ operan y rescatan Kafka en producción para empresas todos los días, desde revisiones de estrategia de particiones y planificación de capacidad hasta respuesta de emergencia con objetivos de respuesta desde 15 minutos, según el plan, a cualquier hora. Descubra los servicios empresariales de Kafka de AceMQ o hable con nosotros sobre la cobertura 24/7 para su clúster. Para una segunda opinión sobre el número de particiones, una revisión de estado de Kafka las analiza.
Este es el segundo de los diez pasos de la guía de operaciones de Kafka, que aborda las decisiones operativas en el orden en que surgen en un entorno de producción.
Preguntas frecuentes
¿Puedo cambiar el número de particiones después de crear un topic?
Solo puede aumentarlo, nunca reducirlo. Aumentar las particiones cambia el resultado de hash(key) % numPartitions, así que los registros con la misma clave empiezan a caer en una partición distinta de la de su historial, lo que rompe el orden por clave en la transición. Para topics con clave, el camino seguro es migrar a un topic nuevo con el tamaño correcto.
¿Cómo decide Kafka a qué partición va un mensaje?
Lo decide el productor, del lado del cliente. Con clave, Kafka usa un hash murmur2 de la clave módulo el número de particiones. Sin clave, el sticky partitioner llena los lotes una partición cada vez mientras equilibra la carga en general. Los productores también pueden cambiar este comportamiento implementando un partitioner personalizado o definiendo la partición de forma explícita en el registro.
¿Qué causa una partición caliente y cómo la soluciono rápido?
La causa habitual son claves de baja cardinalidad o muy sesgadas: demasiado tráfico cae por hash en una sola partición y sobrecarga a su broker y a su consumidor. Las mitigaciones inmediatas son aplicar salting a la clave caliente para repartirla en varias particiones, cambiar la clave por un campo de mayor cardinalidad o aislar al cliente de mayor volumen en su propio topic.
¿Cuántas particiones son demasiadas?
No hay un número universal, pero cada partición añade memoria en el broker, file handles, trabajo de replicación y tiempo de rebalanceo. Por broker, mantenerse en unos pocos miles de particiones es una pauta muy utilizada; el modo KRaft eleva drásticamente los límites a nivel de clúster, pero sobreaprovisionar un topic más allá de ~3x el throughput pico proyectado suele costar más de lo que protege.
¿El número de particiones limita cuántos consumidores puedo ejecutar?
Sí. Dentro de un grupo de consumidores, cada partición va exactamente a un consumidor (aunque un consumidor puede leer varias particiones), así que los consumidores que superan el número de particiones quedan inactivos. Su paralelismo máximo de lectura es igual a su número de particiones; por eso el throughput de los consumidores, y no la capacidad del broker, suele ser lo que debe guiar el cálculo del tamaño.

Autor
Guías, comparativas e investigación
Profundice en Kafka
Guías
2Comparativas
9- NATS vs Kafka en 2026: comparativa de Core NATS, JetStream y Kafka
- Mosquitto vs Kafka: ¿broker MQTT o log de eventos?
- Kafka vs Kinesis: comparativa
- Mejores proveedores de Kafka gestionado en 2026, más allá de los hiperescaladores
- Comparativa de opciones de Kafka BYOC (en su propia nube)
- Alternativas a Confluent y competidores tras la adquisición por IBM


