En esta página
RabbitMQ Streams es un tipo de cola que almacena los mensajes en un log replicado de solo anexado (append-only), de modo que muchos consumidores pueden leer el mismo histórico de forma independiente y hacer replay desde cualquier offset. Se ejecuta dentro de un broker de RabbitMQ, lo que reúne enrutamiento y replay en un mismo lugar; Apache Kafka es la plataforma dedicada para un volumen sostenido muy alto y una retención prolongada. Esta guía explica cómo funcionan los RabbitMQ Streams, qué velocidad alcanzan, cómo optimizarlos y en qué casos Kafka es la mejor opción.
En resumen: si ya utiliza RabbitMQ y necesita replay, RabbitMQ Streams es muy probablemente la respuesta. Si ingiere cientos de miles de mensajes por segundo y los retiene durante semanas, la respuesta es Kafka. Para la decisión general entre colas, streams y Kafka, consulte RabbitMQ vs Kafka.
Qué es realmente un stream
Una cola clásica de RabbitMQ es destructiva: un mensaje se entrega, se confirma y desaparece. Ese modelo sirve para distribuir trabajo: un consumidor toma una tarea, la ejecuta y la tarea desaparece.
Un stream es lo contrario. Es un log de solo anexado en disco. Los consumidores leen desde su propio offset y la lectura no cambia nada, así que diez aplicaciones independientes pueden leer cada mensaje y reproducir desde el principio cuando lo necesiten.
Ese modelo no destructivo es lo que comparten ambos sistemas, y es la razón por la que se comparan. Todo lo demás es distinto.
Si ya se ha decidido por los streams y necesita operarlos, la guía de RabbitMQ Streams cubre la retención, los offsets, los super streams, la gestión de réplicas y lo que una confirmación al publicador garantiza y lo que no.
RabbitMQ Streams vs Kafka: la diferencia de arquitectura
Kafka es una plataforma distribuida de streaming de eventos, y esa frase no es decorativa. Un topic de Kafka se divide en particiones repartidas por el clúster; un productor escribe en una partición, y cada consumidor de un grupo se encarga de algunas particiones. El paralelismo, el orden y el volumen se derivan de ese modelo de particiones.
RabbitMQ es un broker de mensajería que ha incorporado un tipo de cola stream. El mismo clúster que enruta el trabajo mediante exchanges y bindings puede alojar streams, accesibles por AMQP o por un protocolo binario dedicado para streams. RabbitMQ admite ambos modelos en un solo lugar: usted añade una capacidad a un broker, no adopta una segunda plataforma.
Ese único hecho estructural explica la mayoría de las diferencias prácticas que se ven a continuación.
RabbitMQ Streams vs Apache Kafka: diferencias clave
| RabbitMQ Streams | Apache Kafka | |
|---|---|---|
| Fortaleza principal | Enrutamiento y reproducción en un solo broker | Volumen y retención a escala |
| Protocolo | AMQP 0-9-1 y 1.0, MQTT y un protocolo de streams | El protocolo binario propio de Kafka |
| Particionamiento | Super streams | Particiones nativas de topics |
| Retención | Límites de tamaño y tiempo por stream | Tamaño, tiempo o compactación por topic |
| Orden | Por stream, o por partición en un super stream | Por partición |
| Volumen típico | Alto: decenas de miles por segundo | Muy alto: cientos de miles y más |
| Ecosistema | Herramientas y clientes de RabbitMQ | Connect, Streams API, ksqlDB y un amplio ecosistema |
| Carga operativa | Un solo broker, modelo conocido | Una plataforma que hay que operar por sí misma |
Gestión de mensajes, retención y orden
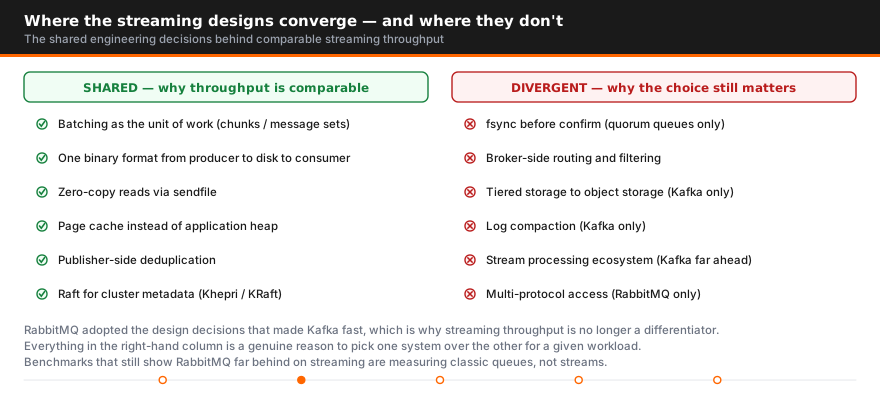
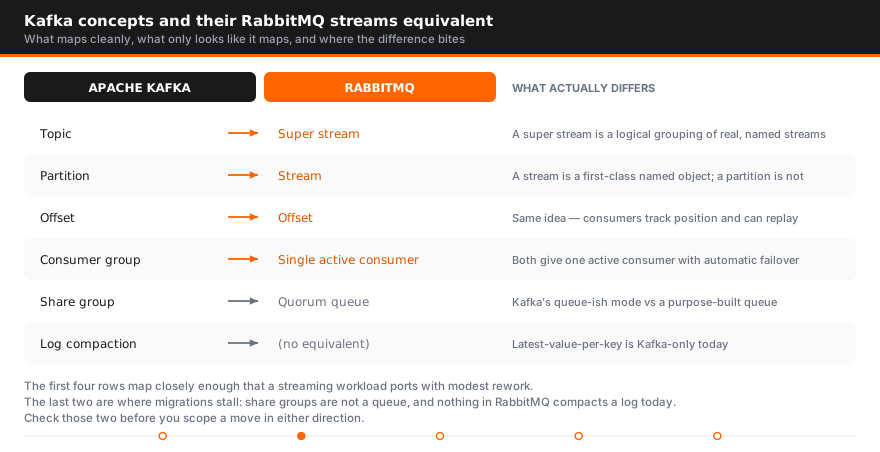
Ambos retienen datos en disco y permiten que los consumidores los reproduzcan. Un topic de Kafka retiene mensajes con políticas por tiempo, por tamaño o de compactación, y la compactación (conservar solo el último valor por clave) es realmente distintiva; los streams de RabbitMQ no la ofrecen.
El orden funciona igual en ambos: está garantizado dentro de una partición, no entre particiones. Si necesita un orden global estricto, requiere una sola partición en cualquiera de los dos sistemas, y para lograrlo renuncia al paralelismo.
La diferencia aparece en el enrutamiento. RabbitMQ puede aplicar bindings de exchanges, patrones de topics y headers antes de que un mensaje llegue a un stream. Un productor de Kafka elige un topic y una clave de partición, y la lógica de enrutamiento reside en su aplicación o en el procesamiento de streams posterior.
Rendimiento y escalabilidad
En volumen, Kafka gana sin discusión, y la diferencia es real en el extremo superior. Un broker de Kafka está diseñado para escrituras secuenciales en disco, y el modelo de particiones escala las escrituras horizontalmente de una forma en que un solo stream no lo hace.
Los streams de RabbitMQ son mucho más rápidos que las colas clásicas y gestionan cómodamente cargas de alto volumen, pero un super stream es particionamiento añadido a un broker cuyo centro de gravedad es el enrutamiento, no una plataforma diseñada desde cero para el rendimiento secuencial en disco.
En latencia, la diferencia es menor que en volumen. Para la latencia por mensaje con volumen moderado, RabbitMQ suele rendir mejor, porque el procesamiento por lotes de Kafka prioriza el volumen sobre la velocidad de cada mensaje. Si su requisito es «este mensaje debe llegar en menos de diez milisegundos» y no «debemos absorber un millón de eventos por segundo», no dé por hecho que Kafka es la opción más rápida.
Los benchmarks, en cualquier dirección, deben tomarse con cuidado. Las cifras de los proveedores se obtienen en condiciones elegidas para favorecer al sistema que se vende, y el tamaño de sus mensajes, la configuración de durabilidad y su red influyen en el resultado más que la elección del software.
RabbitMQ Streams o Kafka: ¿cuál es más fácil de operar?
RabbitMQ, en general, y ese es un factor de decisión legítimo, no una admisión de debilidad.
El modelo de despliegue de RabbitMQ se parece mucho a la forma en que la mayoría de los desarrolladores ya piensa: productores, exchanges, colas, consumidores. Los brokers de RabbitMQ se comportan de forma predecible. Hay bibliotecas cliente para todos los lenguajes, la interfaz de administración es realmente útil y se puede tener un clúster funcionando en una tarde.
Kafka exige más. Antes de llegar a producción hay que entender el número de particiones, el rebalanceo de grupos de consumidores, la gestión de offsets, el ajuste de la retención y la configuración de replicación. La recompensa es un sistema que escala más que RabbitMQ, pero la curva de aprendizaje es real, y
El planteamiento honesto: elija el sistema que su equipo puede operar a las 3 de la madrugada, no el que gana un benchmark.
¿Puede RabbitMQ Streams sustituir a Kafka, o al revés?
Parcialmente, en ambas direcciones, y mal en ambas direcciones si se fuerza.
Kafka como sustituto de RabbitMQ tiene problemas en todo lo que requiera enrutamiento. Kafka no tiene un equivalente a los bindings de exchanges, el TTL por mensaje, las colas de prioridad ni el comportamiento de dead-letter. Reproducirlos implica construirlos en el código de la aplicación: mucho trabajo para evitar operar un broker que ya conoce.
RabbitMQ como sustituto de Kafka tiene problemas con el volumen sostenido y la retención. Si conserva un mes de eventos para reprocesarlos a cientos de miles de mensajes por segundo, los streams no son la herramienta adecuada, y la diferencia de ecosistema también pesa: Kafka Streams, Connect y ksqlDB no tienen un equivalente directo.
Cualquiera de los dos puede hacer el trabajo del otro durante un tiempo. El fallo llega con la escala o la complejidad, que es justo cuando una migración resulta más difícil.
Cuándo usar ambos
Muchas arquitecturas maduras usan ambos, y no es un error de diseño.
Una configuración habitual: RabbitMQ se encarga de los comandos y el control (solicitud/respuesta, distribución de tareas, microservicios orientados a eventos que necesitan un enrutamiento preciso), mientras que Kafka transporta el flujo masivo de eventos que consumen la analítica y el procesamiento de streams. Cada sistema hace lo que mejor sabe hacer, conectados por un puente o por una aplicación que lee de uno y escribe en el otro.
El coste es tener dos sistemas que operar, monitorizar y dotar de personal. Vale la pena cuando las cargas de trabajo son realmente distintas; no vale la pena para evitar una conversación difícil sobre cuál estandarizar.
Cuál es mejor para su caso de uso
Use RabbitMQ cuando:
- Ya ejecuta RabbitMQ y necesita reproducción o varios lectores independientes
- El enrutamiento importa: patrones de topics, enrutamiento por headers, topologías complejas
- Necesita colas y streams y prefiere no operar dos plataformas
- La latencia por mensaje importa más que el volumen agregado
- Su equipo es pequeño y la simplicidad operativa tiene un valor real
Use Kafka cuando:
- El volumen de ingesta es realmente muy alto y sostenido
- Necesita retención prolongada, reproducción de varias semanas o compactación de logs
- Sus casos de uso de streaming necesitan el ecosistema más amplio: Connect, Streams API, ksqlDB
- Muchos equipos independientes consumen los mismos flujos de datos
- Tiene, o va a contratar, la experiencia operativa que requiere
Elija ambos cuando tenga cargas de trabajo distintas que realmente se adapten a cada uno, y la capacidad operativa para operarlos como corresponde.
Dentro de RabbitMQ, los streams tampoco son siempre la respuesta
Vale la pena decirlo con claridad: si su carga de trabajo es distribución de tareas y no reproducción de eventos, la cola de quórum sigue siendo la opción correcta. Los streams añaden una retención y una reproducción que quizá no necesite, y guardan todo en disco, así que un stream con datos que nadie reproduce es un gasto sin beneficio.
La decisión entre cola y stream dentro de RabbitMQ va primero, y a menudo elimina por completo la pregunta sobre Kafka. Consulte
Rendimiento de los streams de RabbitMQ: qué esperar
Un stream de RabbitMQ es un log de solo anexado en disco con un único escritor, el miembro líder. Ese escritor único es la razón por la que un stream es rápido: no hay enrutamiento por mensaje, ni rotación del índice de la cola, ni eliminación con cada ack. También es el techo. El volumen escala por stream hasta lo que un líder puede anexar y replicar, y, más allá de eso, con el número de streams repartidos por el clúster. ¿Necesita más? Añada streams, no una máquina más grande.
La forma de comunicarse con el stream importa más que casi cualquier otra cosa. El protocolo nativo de streams en el puerto 5552 (el plugin rabbitmq_stream) es un protocolo binario diseñado para logs: los publicadores envían lotes en un solo frame, el broker escribe los chunks directamente en el fichero, y los consumidores vuelven a leer esos chunks con sendfile desde la caché de páginas, casi sin trabajo por mensaje en Erlang. El acceso al mismo stream por AMQP 0-9-1 (x-queue-type: stream) pasa por la maquinaria habitual de los canales: una entrega por mensaje, prefetch obligatorio y acks por mensaje. Es práctico para el código existente, pero un orden de magnitud o más lento en las lecturas. Con el protocolo de streams y procesamiento por lotes, un solo stream en hardware común alcanza cientos de miles de mensajes por segundo, y un clúster con varios streams llega a millones. Por AMQP, el rango realista es de decenas de miles por segundo por stream.
El sub-entry batching lleva aún más lejos al protocolo nativo: un publicador empaqueta muchos mensajes en una sola entrada y la comprime (gzip, snappy, lz4, zstd), y el broker almacena el lote como una unidad, así que el coste de disco y de replicación se paga una vez por lote. Los consumidores AMQP no pueden leer lotes sub-entry.
La replicación es de líder y réplicas, con la biblioteca de replicación de logs Osiris en lugar de Raft. Una publicación se confirma cuando la mayoría de los miembros la ha escrito en disco. Las réplicas adicionales le cuestan al líder ancho de banda de salida y suman la latencia de disco de la réplica más lenta al tiempo de confirmación; no le restan volumen de lectura, ya que los consumidores pueden leer desde las réplicas.
El comportamiento del disco es la parte que se suele subestimar. Las escrituras son secuenciales y baratas. Las lecturas de datos recientes vienen de la caché de páginas del sistema operativo y son casi gratuitas; un consumidor que reproduce desde la semana pasada va a disco y compite con el escritor. La retención prolongada con consumidores que retroceden necesita margen en la caché de páginas: RAM para el kernel, no para la máquina virtual de Erlang.
La retención se aplica por segmento. max-age y max-length-bytes definen la ventana, y stream-max-segment-size-bytes (500 MB por defecto) define la granularidad, porque el broker solo elimina segmentos completos. Ninguno de los dos afecta mucho la velocidad de publicación; determinan el uso de disco y el coste de la reproducción.
El seguimiento de offsets tampoco es gratis. El almacenamiento de offsets del lado del servidor escribe entradas de seguimiento en el propio stream, así que confirmar después de cada mensaje duplica aproximadamente la carga de escritura de un consumidor. Confirme a intervalos y acepte algunas reentregas al reiniciar.
Cómo ajustar el rendimiento de los streams de RabbitMQ
En el orden en que recurrimos a cada medida:
- Use el protocolo de streams y un cliente de streams. Si su ruta crítica está en AMQP, este cambio vale más que todo lo que sigue junto.
- Agrupe en lotes en el publicador y confirme de forma asíncrona. Los clientes de streams agrupan en lotes por defecto; aumente el tamaño del lote y nunca espere una confirmación por cada mensaje.
- Dé crédito a los consumidores. El protocolo se basa en créditos: el consumidor pide chunks y el broker envía hasta que se agota el crédito. Mantenga varios chunks pendientes.
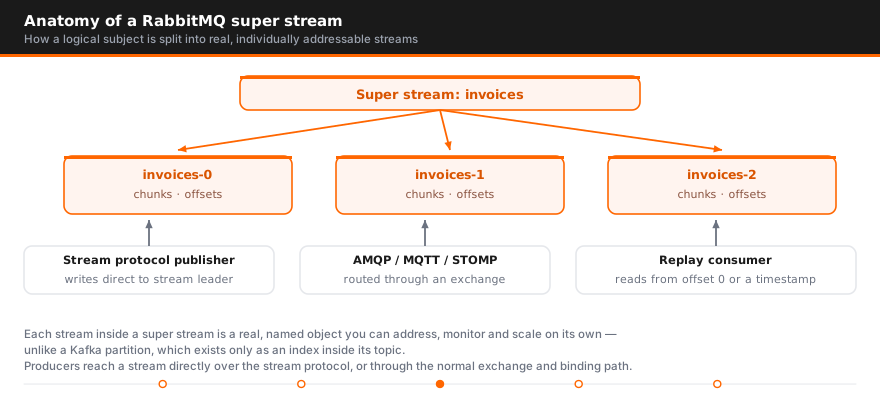
- Divida con super streams. Un super stream es un conjunto de streams de partición bajo un mismo nombre; los publicadores eligen una partición según la routing key, con hash por defecto. El orden se mantiene dentro de una partición y en ningún otro lugar, así que elija una clave que agrupe lo que debe mantenerse ordenado (cuenta, dispositivo, sesión) y reparta el resto. Las particiones tienen líderes distintos, que es la forma de aprovechar todos los nodos.
- Configure la replicación de forma deliberada.
x-initial-cluster-size, al declarar, controla el número de miembros. Tres para todo lo que importe, uno para ingestas temporales reproducibles. - Ubique los miembros en discos locales rápidos. NVMe antes que volúmenes conectados por red, y sin compartirlos con los datos de las colas de quórum.
- Dimensione la retención según su patrón de reproducción. Retención corta si los consumidores se mantienen cerca del extremo más reciente; retención moderada y RAM generosa si retroceden horas. El dimensionamiento del clúster en sí se trata en nuestras preguntas frecuentes sobre dimensionamiento para alta disponibilidad y recuperación ante desastres.
- Confirme offsets a intervalos. Cada pocos segundos o cada pocos miles de mensajes.
- Mantenga a los consumidores AMQP lejos de los streams de alto volumen. Sirven para un panel, no para el consumidor principal.
- Vigile las métricas correctas. La interfaz de administración muestra, por stream, los publicadores, los consumidores y el nodo líder; el endpoint de Prometheus exporta los recuentos de conexiones, publicadores y consumidores de streams junto con las tasas de mensajes y bytes a nivel de cola. El lag de los consumidores es un dato del lado del cliente, así que expórtelo desde la aplicación.
Una política de retención se ve así:
rabbitmqctl set_policy stream-events "^events\." \
  '{"max-age":"7D","max-length-bytes":50000000000}' --apply-to queues
Los dos errores que más vemos. El primero, un solo stream para todo: un único líder limitado a un nodo, todos los consumidores filtrando del lado del cliente y una reproducción que lee terabytes para encontrar un solo tenant. Particione con un super stream o use varios streams. El segundo, tratar un stream como una cola: esperar acks por mensaje, consumidores que compiten por repartirse el trabajo y mensajes que desaparecen una vez procesados. Un stream lo conserva todo hasta que vence la retención, cada consumidor lee todo y los acks no existen. Si la carga de trabajo necesita semántica de cola, lo que necesita es una cola de quórum o clásica, no un stream.
Si sus streams son más lentos de lo que deberían, el soporte de RabbitMQ revisará con usted la configuración y las métricas; la consultoría de RabbitMQ cubre el rediseño cuando el problema es la topología.
Hable con un ingeniero de AceMQ
Si la pregunta detrás de este artículo es de arquitectura y no un incidente en curso (estrategia de particiones, dimensionamiento, diseño de seguridad, una migración), la consultoría de Kafka de AceMQ asigna a un ingeniero sénior dedicado.
Preguntas frecuentes
¿Cuál es la diferencia entre Kafka y RabbitMQ Streams?
Ambos ofrecen un log de solo anexado (append-only) reproducible. RabbitMQ Streams es un tipo de cola dentro de un broker de mensajería que además hace enrutamiento sofisticado; Kafka es una plataforma distribuida de streaming de eventos dedicada, diseñada para un volumen muy alto y una retención prolongada.
¿Es RabbitMQ más fácil de usar que Kafka?
Por lo general, sí. Su modelo se corresponde con los conceptos conocidos de productor y consumidor, la interfaz de administración es sencilla y un clúster se pone en marcha rápidamente. Kafka exige entender particiones, grupos de consumidores, offsets y rebalanceo antes de llegar a producción.
Kafka o RabbitMQ: ¿puede uno sustituir al otro?
Para pub/sub simple, a menudo sí. Para todo lo que necesite enrutamiento, TTL por mensaje, prioridades o dead-lettering, acaba reconstruyendo funciones del broker en el código de la aplicación.
¿Puede RabbitMQ Streams sustituir a Kafka?
Para volúmenes moderados con requisitos de reproducción, sí. Con un volumen sostenido muy alto y retención prolongada, o cuando necesita Connect y la Streams API, Kafka sigue siendo la mejor opción.
¿Qué sistema de mensajería rinde mejor?
Kafka en volumen sostenido; RabbitMQ suele ser mejor en latencia por mensaje, ya que Kafka agrupa en lotes para ganar volumen. Lo que importa depende de si su restricción es el volumen o el tiempo de respuesta.
¿Admiten particionamiento los streams?
Sí, mediante super streams, que distribuyen un stream lógico en varios streams para el consumo en paralelo. Funciona bien, aunque el modelo de particiones de Kafka es más maduro.
¿Debería usar RabbitMQ y Kafka a la vez?
Es una arquitectura habitual y válida: RabbitMQ para el enrutamiento y el tráfico de comandos, Kafka para el pipeline de eventos de alto volumen. El coste es operar dos sistemas, así que hágalo solo cuando las cargas de trabajo sean realmente distintas.
¿Cuándo debería usar una cola de quórum en lugar de un stream?
Cuando el trabajo se consume una vez y se descarta. Las colas de quórum sirven para distribuir tareas; los streams, para la reproducción y para varios lectores independientes. Usar un stream para un procesamiento de trabajos simple suma coste de disco y complejidad sin ningún beneficio.
¿Qué velocidad alcanzan los streams de RabbitMQ?
Lo bastante rápidos como para que el límite lo ponga el protocolo que usa, no el stream. Con el protocolo nativo de streams en el puerto 5552, publicaciones por lotes y un cliente de streams, un solo stream en hardware común alcanza cientos de miles de mensajes por segundo, y un clúster con varios streams o un super stream llega a millones. El mismo stream leído mediante AMQP 0-9-1 es un orden de magnitud más lento, porque cada mensaje pasa por la entrega del canal, el prefetch y el ack. La latencia de las confirmaciones está acotada por la escritura en disco de la réplica más lenta, normalmente pocos milisegundos en NVMe local.
¿Cómo mejoro el rendimiento de los streams de RabbitMQ?
Primero, pase la ruta crítica al protocolo de streams y a un cliente de streams; ese cambio pesa más que todo lo demás. Después, publique por lotes con confirmaciones asíncronas, mantenga varios chunks de crédito pendientes para los consumidores y confirme offsets a intervalos en lugar de mensaje por mensaje. Si un stream satura a su líder, divídalo en un super stream con una clave de partición que preserve el orden que necesita. Mantenga tres miembros en NVMe local, configure la retención con max-age o max-length-bytes y mantenga a los consumidores AMQP lejos de los streams más cargados. Revise en la interfaz de administración qué nodo tiene cada líder.

Autor
Guías, comparativas e investigación
Profundice en Kafka
Guías
2Comparativas
9- NATS vs Kafka en 2026: comparativa de Core NATS, JetStream y Kafka
- Mosquitto vs Kafka: ¿broker MQTT o log de eventos?
- Kafka vs Kinesis: comparativa
- Mejores proveedores de Kafka gestionado en 2026, más allá de los hiperescaladores
- Comparativa de opciones de Kafka BYOC (en su propia nube)
- Alternativas a Confluent y competidores tras la adquisición por IBM