
En esta página
Una evaluación de preparación para la migración de RabbitMQ es un control puntual que se realiza antes de una actualización importante, un cambio de plataforma o un cambio de arquitectura; no es un health check continuo. Confirma que la topología y las dependencias están totalmente inventariadas, que sabe qué se rompe si falla un paso, que dispone de un rollback probado y que el entorno de destino puede absorber la carga real de producción.
La mayoría de los equipos que salen escaldados de una migración de RabbitMQ no tenían un clúster averiado de antemano. Tenían un entorno estable, un plan razonable y una fecha de puesta en producción, y descubrieron en pleno cutover que la topología de una cola solo existía en la cabeza de un ingeniero, que un consumidor aguas abajo seguía con una librería cliente de hace tres versiones mayores o que su plan de rollback era «restaurar desde la copia de seguridad» sin tener ni idea de cuánto tardaría eso realmente bajo carga.
Para detectar esto existe una evaluación estructurada de preparación previa a la migración: antes de que empiece la ventana de mantenimiento, no durante ella.
¿Qué es una evaluación de preparación para la migración de RabbitMQ?
Es una revisión de alcance cerrado ligada a un cambio planificado concreto: una actualización de versión, un traslado a nueva infraestructura (Kubernetes, un nuevo centro de datos, una nueva región cloud) o un cambio de arquitectura, como añadir replicación federada para recuperación ante desastres. No es una suscripción ni una herramienta de monitorización.
El resultado es una hoja de ruta de la migración y un informe de preparación con una recomendación clara: adelante, adelante tras aplicar antes unas correcciones concretas, o todavía no. Cubre todas las cargas de trabajo a las que afecta la migración, no solo el broker. Es un entregable distinto al de un health check general, y conviene tener clara la diferencia antes de definir el alcance.
¿En qué se diferencia una evaluación de preparación para la migración de un health check general de RabbitMQ?
Coinciden en el método (ambos examinan la configuración del clúster, la topología de colas y el estado de las versiones), pero responden a preguntas distintas. Un health check de RabbitMQ se pregunta: «¿está sano este despliegue ahora mismo y qué deberíamos corregir en general?». Se realiza periódicamente, con independencia de cualquier cambio previsto, y sus hallazgos (colas clásicas replicadas, usuarios con demasiados permisos, heartbeats mal configurados) son válidos tanto si va a migrar algo como si no.
Una evaluación de preparación para la migración plantea una pregunta más acotada y con más en juego: «¿podemos ejecutar este cutover concreto, en esta fecha, sin una caída ni pérdida de datos? Y, si no, ¿qué tiene que cambiar antes?». Ese planteamiento cambia los entregables. Una evaluación de preparación produce un plan de rollback ajustado a los pasos exactos de la migración, un registro de riesgos con qué se rompe y en qué condiciones, y pruebas de carga ejecutadas contra la configuración de destino, no solo una fotografía de la salud actual. Si no tiene previsto un cutover concreto, lo que necesita es el health check. Si tiene una actualización o un cambio de plataforma en el calendario, necesita esto.
¿Qué debe recoger realmente un inventario previo a la migración?
El inventario es la parte cuyo alcance los equipos subestiman con más frecuencia, porque la mayor parte está fuera de la propia configuración del broker. Hay cuatro elementos que deben recogerse antes de poder planificar una migración con cierta seguridad:
- La topología de colas, exchanges y bindings, y si está definida en la automatización. Hace poco trabajamos con una empresa de procesamiento de pagos cuya instalación del clúster estaba totalmente automatizada, pero cuyas colas, exchanges y enlaces de federation se habían creado a mano y no existían en ningún código. Es una carencia habitual, y significa que la topología no puede reconstruirse de forma fiable en un clúster nuevo sin que alguien la deduzca manualmente a partir del sistema en ejecución.
- Las dependencias de plugins. Federation, shovel y cualquier plugin personalizado o de terceros deben comprobarse uno a uno con la versión de RabbitMQ de destino: un plugin compatible con su versión actual no lo es automáticamente con aquella a la que migra.
- Las versiones de la librería cliente y del runtime en cada aplicación consumidora. No la versión del broker: la del cliente. Las aplicaciones con librerías cliente antiguas o runtimes obsoletos suelen arrastrar ajustes de conexión, de hilos o de memoria mal dimensionados que solo se manifiestan como problema cuando, durante una migración, cambian los patrones de tráfico o el comportamiento del broker.
- La compatibilidad de tipos de cola y de versiones. Las colas clásicas replicadas son terreno obsoleto de cara a las nuevas versiones mayores de RabbitMQ, y el soporte de versiones de Erlang/OTP está ligado a su versión de RabbitMQ: la edición community de 3.13.x, por ejemplo, no admite el runtime de Erlang 27, lo que obliga a hablar de licencias a cualquier equipo que quiera mantenerse al día sin una actualización completa.
Nada de esto es exótico. Simplemente es lo bastante tedioso como para que los equipos con una fecha límite se lo salten y lo redescubran en directo durante la migración.
¿Cómo se evalúa el riesgo antes de una migración de RabbitMQ y qué se rompe realmente?
Evaluar el riesgo de una migración significa analizar condiciones de fallo concretas, no elaborar una lista genérica ordenada por gravedad. La versión útil de este ejercicio responde a lo siguiente: en cada paso de la migración, ¿qué se rompe si falla y cómo se ve ese fallo aguas abajo?
Un ejemplo concreto de un proyecto de replicación para recuperación ante desastres que definimos con un cliente de procesamiento de pagos: el enfoque que proponían usaba exchanges federados para replicar los mensajes en un sitio secundario. Los exchanges federados replican mensajes, no el estado del broker. Por eso, si el lado de DR se cae, los mensajes replicados se acumulan localmente en lugar de perderse, pero un simulacro de DR real podría suponer recuperar un backlog de cientos de miles de mensajes cuando el enlace se restablece. Ese tráfico de recuperación cae directamente sobre el clúster de producción y hay que tenerlo en cuenta, o se convierte en un incidente por sí mismo.
Así es una evaluación de riesgos real: garantías de orden de los mensajes, supuestos de idempotencia en el lado del consumidor, si una reconexión tras una caída provoca un backlog lo bastante grande como para afectar al throughput de producción, y si las aplicaciones cliente gestionan correctamente las reentregas en lugar de dar por hecho un comportamiento exactly-once que nunca se les garantizó. Todo esto depende de su arquitectura y de sus aplicaciones: una checklist de plantilla no lo sacará a la luz, pero analizar la migración paso a paso sí.
¿Qué debe incluir un plan de rollback?
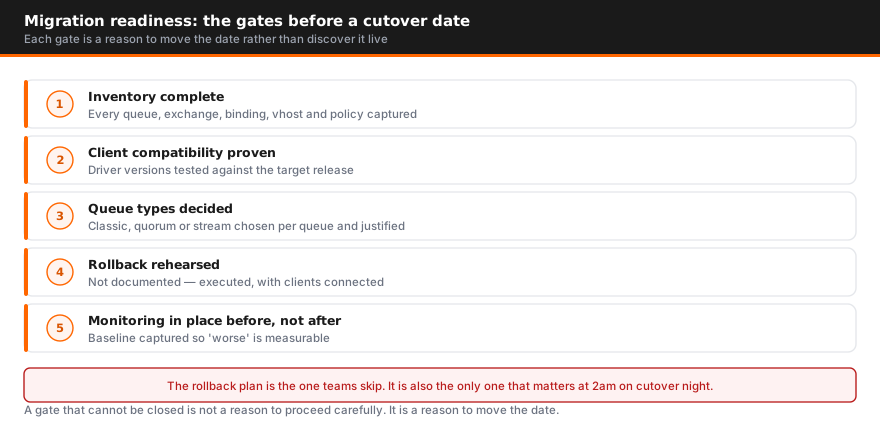
«Restaurar desde la copia de seguridad» no es un plan de rollback para un sistema de mensajería en producción: no dice cuánto tarda la recuperación, qué mensajes se pierden en el intervalo ni cómo se comportan los consumidores aguas abajo mientras tanto. Un plan de rollback real define, para cada paso de la migración, la condición disparadora concreta que significa que hay que abortar y la acción de reversión específica de ese paso.
En la práctica, el patrón que funciona es ejecutar en paralelo el entorno actual y el de destino en lugar de migrar in situ. Levante el nuevo clúster junto al antiguo, traslade las aplicaciones consumidoras por oleadas y mantenga el clúster antiguo activo y recibiendo tráfico hasta que las oleadas migradas hayan demostrado ser estables, a menudo durante todo un ciclo de tráfico pico. Si una oleada presenta un problema, se redirige ese grupo de consumidores al clúster antiguo sin tocar nada de lo que ya se migró con éxito. Esto solo funciona si la ruta de rollback se diseñó desde el principio; es muy difícil incorporarla a posteriori en pleno cutover.
Si no puede describir en una frase la acción de rollback de un paso, ese paso no está listo para ejecutarse.
Si la actualización es también el momento de pasar a una build con soporte, en licencias comerciales de RabbitMQ se explica qué incluye una suscripción comercial y cómo se calcula su precio.
¿Cómo se validan la carga y la capacidad antes del cutover?
Las pruebas de carga previas a una migración deben construirse a partir de su tráfico real, no de un benchmark sintético. Extraiga los datos históricos de profundidad de colas y de tasa de mensajes de lo que ya tenga (Prometheus, Grafana, Dynatrace o la propia API de gestión del broker) para crear un perfil realista del throughput pico, los patrones de ráfaga y la distribución del tamaño de los mensajes antes de diseñar la prueba.
Hay dos cosas que conviene probar y que los equipos suelen pasar por alto. La primera: pruebe con su pico real, no con la carga media. Una plataforma de pagos con la que trabajamos estaba definiendo un enfoque de replicación que debía sostener aproximadamente 2.000 mensajes por segundo de forma continuada, y para responder con honestidad si federation podía aguantarlo con las limitaciones de red hacían falta pruebas de carga reales, no una estimación. La segunda: pruebe la recuperación de un backlog, no solo el throughput en régimen estable. Un clúster que gestiona sin problemas el tráfico normal puede tener dificultades cuando tiene que procesar a la vez un backlog de recuperación y el tráfico en directo, que es exactamente la situación en la que le deja un cutover fallido o un failback de DR.
Si su arquitectura de destino cambia el tipo de cola, añade un salto de replicación o pasa a otra infraestructura subyacente, el margen de capacidad que tenía el sistema antiguo no se traslada automáticamente. Valídelo antes de la fecha de puesta en producción, no durante ella.
¿Qué dependencias de plugins y librerías cliente se pasan por alto con más frecuencia?
Más allá del inventario básico, hay algunos problemas de dependencias que aparecen con una frecuencia desproporcionada cuando los equipos ya están en plena migración:
- Desfase de versiones de los plugins federation y shovel. Estos plugins se publican de forma independiente del núcleo del broker y hay que volver a verificarlos con la versión de destino: no dé por hecho que la compatibilidad se mantiene.
- Compatibilidad con Erlang/OTP ligada a las licencias. RabbitMQ community en la serie estable actual deja de recibir parches para los runtimes de Erlang más antiguos con el tiempo, y pasar a una versión mayor más reciente de Erlang a veces exige una licencia comercial, según la serie de RabbitMQ que utilice. Esto aflora durante la planificación de la migración con mucha más frecuencia de la que los equipos esperan, y puede convertir una actualización técnica sencilla en una conversación de compras con fecha límite.
- Valores por defecto de conexión y timeouts en el cliente ajustados para el entorno antiguo. Los ajustes de heartbeat y de timeout TCP pensados para redes on-premise de baja latencia provocan desconexiones falsas en cuanto una migración mueve el tráfico entre zonas de disponibilidad o a través de un NAT gateway. Es un cambio que conviene detectar antes del cutover en lugar de depurarlo después como un incidente misterioso.
- Aplicaciones que siguen con librerías cliente o runtimes antiguos. Suelen arrastrar valores por defecto conservadores (por ejemplo, ajustes de memoria de la JVM muy por debajo de lo que el contenedor tiene realmente disponible) que limitan el throughput sin hacer ruido y solo se hacen visibles cuando se intenta alcanzar un objetivo de rendimiento concreto durante las pruebas de migración.
¿Cuánto dura una evaluación de preparación y qué se obtiene al final?
El alcance determina el plazo. Una actualización de versión de un único clúster con pocas aplicaciones consumidoras suele ser un proyecto de una semana. Un despliegue multirregión con federation, plugins personalizados y decenas de aplicaciones consumidoras requiere más tiempo para inventariarlo, evaluar sus riesgos y someterlo a pruebas de carga como es debido: normalmente entre dos y tres semanas.
En cualquier caso, debería obtener:
- Un inventario completo de topología, plugins y librerías cliente: la fuente de verdad sobre la que se construye el plan de migración
- Un registro de riesgos que describe condiciones de fallo concretas y su impacto aguas abajo, no una lista genérica por gravedad
- Un plan de rollback con un disparador definido y una acción de reversión para cada paso de la migración
- Resultados de pruebas de carga contra la configuración de destino, incluidos escenarios de recuperación de backlog
- Una recomendación de go/no-go con los problemas bloqueantes priorizados antes de la fecha del cutover
- Criterios de validación posteriores a la migración y una breve fase de optimización cuando el clúster de destino ya soporta tráfico real
Compare el coste de ese proyecto con el coste total de propiedad de saltárselo: un rollback no planificado bajo carga de producción casi siempre sale más caro que la propia evaluación. Si tiene previsto una actualización de versión, un cambio de plataforma o un cambio de arquitectura y quiere un control de preparación estructurado antes de comprometerse con una fecha de cutover, nuestro equipo de RabbitMQ realiza estas evaluaciones junto con las propias migraciones. Hable con nosotros para definir el alcance de una según su calendario.
Esta checklist es el segundo de los siete pasos de la guía de migración de RabbitMQ, que ordena la decisión, el inventario, el mapeo semántico, la build de destino, el cutover y la validación.
Preguntas frecuentes
¿Qué es una evaluación de preparación para la migración de RabbitMQ?
Una revisión puntual que se realiza antes de una actualización de versión mayor, un cambio de plataforma o un cambio de arquitectura. Inventaría la topología y las dependencias actuales, identifica qué se rompe si la migración sale mal, elabora un plan de rollback probado y valida que el entorno de destino puede soportar la carga real de producción. Termina con una recomendación de go/no-go.
¿En qué se diferencia una evaluación de preparación para la migración de un health check general de RabbitMQ?
Un health check es una fotografía periódica de la salud operativa (dimensionamiento del clúster, línea base de seguridad, deriva de la configuración) que se realiza con independencia de cualquier cambio previsto. Una evaluación de preparación para la migración se limita a un cutover concreto, tiene una fecha límite firme y genera entregables que un health check no produce: un plan de rollback, un registro de riesgos del cutover y pruebas de carga contra el estado de destino, no solo contra el actual.
¿Qué debe cubrir el inventario del estado actual?
Cada cola, exchange y binding, y si esa topología está definida en la automatización o solo existe como configuración manual y sin documentar; cada plugin en uso, incluidos federation, shovel y cualquier plugin personalizado o de desarrollo propio; y la versión de la librería cliente y del runtime de cada aplicación que publica o consume, no solo la versión del broker.
¿Qué debe incluir realmente un plan de rollback?
Un disparador definido (la métrica o condición de fallo concreta que significa que hay que abortar) y una declaración de reversibilidad para cada paso, no un genérico «restaurar desde la copia de seguridad». En la práctica, esto suele implicar ejecutar el entorno antiguo y el nuevo en paralelo y migrar los grupos de consumidores por oleadas, de modo que cualquier oleada pueda redirigirse de vuelta sin tocar las que ya se completaron con éxito.
¿Necesitamos pruebas de carga aunque no cambiemos el hardware?
Sí. Una actualización de versión o un cambio de topología (por ejemplo, pasar de colas clásicas replicadas a colas de quórum (quorum queues) o añadir una ruta de replicación para recuperación ante desastres) cambia el comportamiento del broker bajo carga, incluso con un hardware idéntico. Haga pruebas con su pico real de throughput y con escenarios de recuperación de backlog, no solo con tráfico estable.
¿Cuánto dura una evaluación de preparación para la migración de RabbitMQ?
Normalmente entre una y tres semanas, según el número de clústeres y la complejidad de la topología. Una actualización de un único clúster con unas pocas aplicaciones consumidoras puede abordarse en aproximadamente una semana; un despliegue multirregión con federation, plugins personalizados y decenas de aplicaciones consumidoras requiere más tiempo para inventariarlo y someterlo a pruebas de carga como es debido.
¿Qué suele hacer necesaria una evaluación de este tipo?
Una actualización de versión mayor (sobre todo si cambia los tipos de cola por defecto o la compatibilidad con Erlang), un cambio de plataforma, como pasar a Kubernetes o a un nuevo centro de datos, un cambio de arquitectura, como añadir replicación para recuperación ante desastres, o un cambio de licencias que obliga a saltar de versión con una fecha límite.

Autor
Hablar con un ingeniero
¿Necesita ayuda con RabbitMQ?
Ingenieros sénior que lo gestionan en producción. Solicite un presupuesto o una consulta gratuita, sin discursos comerciales.
Guías, comparativas e investigación
Profundice en RabbitMQ
Guías
7- Guía de optimización del rendimiento de RabbitMQ
- Guía de RabbitMQ Streams
- Guía de clústeres y dimensionamiento de RabbitMQ
- Guía de RabbitMQ en Kubernetes
- RabbitMQ para agentes de IA: patrones, configuración y errores
- Celery y RabbitMQ para colas de tareas de LLM
Mostrar 1 másMostrar menos
Comparativas
9- ¿RabbitMQ de la comunidad, Tanzu RabbitMQ o soporte de terceros?
- Mejores proveedores de soporte de RabbitMQ: comparativa (2026)
- RabbitMQ vs Amazon SQS: comparativa
- RabbitMQ vs Redis: comparativa
- Proveedores de RabbitMQ comparados: Amazon MQ, CloudAMQP, Stackhero, Northflank, Tanzu y AceMQ
- Comparativa de opciones de soporte para brokers de mensajería


