On this page
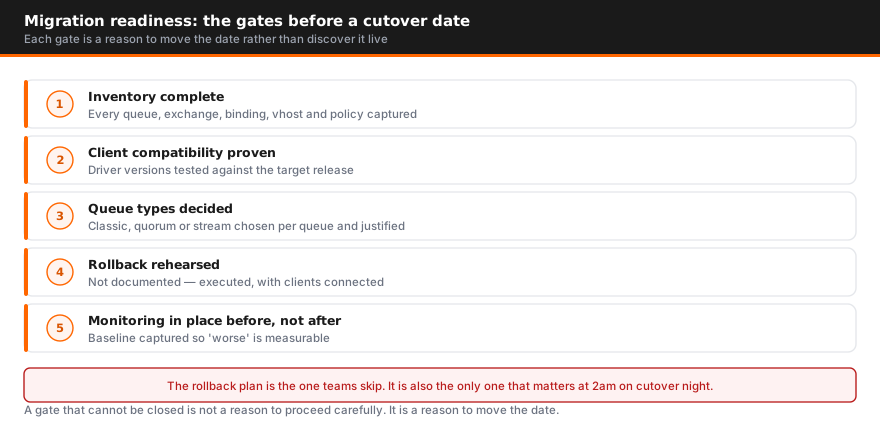
RabbitMQの移行準備アセスメントは、大規模なアップグレード、プラットフォームの移行、アーキテクチャの変更の前に、ある時点で通過すべき関門です。継続的なヘルスチェックではありません。トポロジーと依存関係が漏れなく棚卸しされていること、どこかのステップが失敗したら何が壊れるかを把握していること、検証済みのロールバックがあること、そして移行先の環境が実際の本番負荷を吸収できることを確認します。
RabbitMQの移行で痛い目に遭うチームの多くは、それ以前から壊れたクラスターを運用していたわけではありません。安定した環境、妥当な計画、本番稼働の日程がありました。それでも切り替えの最中に、あるキューのトポロジーが1人のエンジニアの頭の中にしか存在しないこと、あるいは下流のコンシューマーが3メジャーバージョンも前のクライアントライブラリのままだったこと、あるいはロールバック計画が「バックアップから復元」だけで、負荷がかかった状態で実際にどれだけ時間がかかるのか誰も分かっていなかったことに気づくのです。
構造化された移行前の準備アセスメントは、こうした問題をメンテナンスウィンドウの最中ではなく、始まる前に見つけるためのものです。
RabbitMQの移行準備アセスメントとは?
特定の1つの計画変更に紐づいた、範囲を固定したレビューです。対象となるのは、バージョンアップグレード、新しいインフラ(Kubernetes、新しいデータセンター、新しいクラウドリージョン)への移行、あるいはディザスタリカバリのためのFederationによるレプリケーションの追加といったアーキテクチャの変更です。サブスクリプションでも、監視ツールでもありません。
成果物は、移行のロードマップと準備状況レポートで、明確な推奨事項を示します。実施可、特定の修正を先に行ったうえで実施可、あるいはまだ実施すべきではない、のいずれかです。対象はブローカー自体だけでなく、移行が影響するすべてのワークロードに及びます。これは一般的なヘルスチェックとは異なる成果物であり、範囲を決める前にその違いを正確に理解しておく価値があります。
移行準備アセスメントは、一般的なRabbitMQのヘルスチェックとどう違うのか?
手法は重なります。どちらもクラスターの設定、キューのトポロジー、バージョンの状況を調べます。しかし、答える問いが違います。RabbitMQのヘルスチェックが問うのは、「このデプロイは今健全か、全般的に何を直すべきか」です。予定されている変更とは関係なく定期的に実施され、その指摘事項(クラシックミラーキュー、過剰な権限を持つユーザー、ハートビートの設定ミスなど)は、移行するかどうかに関係なく当てはまります。
移行準備アセスメントが問うのは、より範囲が狭く、より重大な問いです。「この特定の切り替えを、この日に、障害やデータ損失なしに実行できるか。できないなら、先に何を変える必要があるか」。この問いの立て方が、成果物を変えます。準備アセスメントでは、実際の移行ステップに合わせたロールバック計画、何がどんな条件で壊れるかをまとめたリスク登録簿、そして現在の健全性のスナップショットではなく移行後の構成に対して実施する負荷テストを作成します。特定の切り替えを予定していないなら、必要なのはヘルスチェックです。アップグレードやプラットフォームの移行が予定に入っているなら、必要なのはこちらです。
移行前の棚卸しで、実際に何を把握すべきか?
棚卸しは、チームが最も一貫して範囲を小さく見積もりがちな部分です。その大半がブローカー自身の設定の外にあるからです。自信を持って移行を計画するには、事前に次の4つを把握する必要があります。
- キュー、エクスチェンジ、バインディングのトポロジーと、それが自動化の中で定義されているかどうか。最近当社が支援したある決済処理会社では、クラスターのインストールは完全に自動化されていましたが、キュー、エクスチェンジ、Federationのリンクは手作業で作成されており、コードのどこにも存在しませんでした。これはよくある抜け漏れで、誰かが稼働中のシステムから手作業で構成を割り出し直さない限り、新しいクラスター上でトポロジーを確実に再構築できないことを意味します。
- プラグインの依存関係。Federation、Shovel、カスタムやベンダー提供のプラグインは、移行先のRabbitMQのバージョンに対して1つずつ確認する必要があります。現在のバージョンと互換性があるプラグインが、移行先のバージョンとも自動的に互換性があるわけではありません。
- コンシューマー側のすべてのアプリケーションにおけるクライアントライブラリとランタイムのバージョン。ブローカーではなく、クライアントのバージョンです。古いクライアントライブラリや古いランタイムで動いているアプリケーションは、接続、スレッド、メモリの設定が十分にチューニングされていないことが多く、それが問題として表面化するのは、移行中にトラフィックのパターンやブローカーの挙動が変わったときです。
- キュータイプとバージョンの互換性。新しいRabbitMQのメジャーバージョンに向けて、クラシックミラーキューは非推奨の領域に入っています。また、Erlang/OTPのサポートバージョンはRabbitMQのバージョンに紐づいています。たとえば3.13.xのコミュニティエディションはErlang 27のランタイムをサポートしていないため、フルアップグレードをせずに最新の状態を保ちたいチームは、ライセンスの検討を迫られます。
どれも特殊なことではありません。ただ、期限に追われるチームが省いてしまうほどには面倒で、その結果、移行の本番中に改めて発見することになるのです。
RabbitMQの移行前にリスクをどう評価するか:実際に何が壊れるのか?
移行のリスク評価とは、重大度順に並べたありきたりのリストを作ることではなく、具体的な障害条件を1つずつ検討することです。この作業で役に立つのは、次の問いに答えることです。移行の各ステップについて、それが失敗したら何が壊れるのか、そしてその障害は下流でどう現れるのか。
当社がある決済処理会社のお客様と範囲を定めたディザスタリカバリのレプリケーション案件から、具体例を挙げます。提案されていた方式では、Federationを使ったエクスチェンジでセカンダリサイトにメッセージを複製するものでした。Federationを使ったエクスチェンジが複製するのはメッセージであり、ブローカーの状態ではありません。そのため、DR側が停止しても、複製対象のメッセージは失われずにローカルに滞留します。しかし実際のDR訓練では、リンクが再接続された時点で数十万件規模の滞留メッセージを回復させることになりかねません。その回復トラフィックは本番クラスターに直接かかるため、あらかじめ考慮しておかなければ、それ自体が新たなインシデントになります。
本当のリスク評価とは、こういうものです。メッセージの順序保証、コンシューマー側の冪等性の前提、障害後の再接続で本番のスループットに影響するほどの滞留が発生するかどうか、そしてクライアントのアプリケーションが、保証されたこともないexactly-onceの挙動を前提にするのではなく、再配信を本当に正しく処理できるかどうか。いずれもお客様のアーキテクチャとアプリケーションに固有のものです。テンプレートのチェックリストでは浮かび上がりませんが、移行を1ステップずつ検討していけば見えてきます。
ロールバック計画には何を含める必要があるか?
稼働中のメッセージングシステムにとって、「バックアップから復元」はロールバック計画ではありません。復旧にどれだけ時間がかかるのか、その間にどのメッセージが失われるのか、その最中に下流のコンシューマーがどう振る舞うのかが何も示されていないからです。本当のロールバック計画では、移行のステップごとに、中止を意味する具体的なトリガー条件と、そのステップを元に戻す具体的な操作を定義します。
実際にうまくいくのは、その場で移行するのではなく、現在の環境と移行先の環境を並行稼働させるパターンです。新しいクラスターを旧クラスターと並べて構築し、コンシューマーのアプリケーションを段階的に移し、移行した段階が安定していることが証明されるまで(多くの場合はピークトラフィックの1サイクルを丸ごと経るまで)、旧クラスターを稼働させてトラフィックを受け続けます。ある段階で問題が見つかれば、すでに移行に成功したものには手を付けずに、そのコンシューマーグループを旧クラスターに戻します。これが機能するのは、最初からロールバックの経路を設計に組み込んでいた場合だけです。切り替えの途中で後付けするのは非常に困難です。
あるステップのロールバック操作を一文で説明できないなら、そのステップはまだ実行できる状態にありません。
アップグレードをサポート付きのビルドへ移行するタイミングにもするなら、RabbitMQの商用ライセンスのページで、商用サブスクリプションに含まれる内容と価格の決まり方をご確認ください。
切り替え前に、負荷とキャパシティをどう検証するか?
移行前の負荷テストは、合成ベンチマークではなく、実際のトラフィックをもとに組み立てる必要があります。テストを設計する前に、Prometheus、Grafana、Dynatrace、あるいはブローカー自身の管理APIなど、すでにあるものからキューの深さとメッセージレートの履歴データを取得し、ピーク時のスループット、バーストのパターン、メッセージサイズの分布について現実的なプロファイルを作ります。
チームがよく省いてしまうテストが2つあります。1つ目は、平均負荷ではなく実際のピークでテストすることです。当社が支援したある決済プラットフォームでは、毎秒約2,000メッセージを持続的に処理する必要があるレプリケーション方式を検討していました。ネットワークの制約の下でFederationがそれを維持できるかどうかについて正直な答えを出すには、見積もりではなく実際の負荷テストが必要でした。2つ目は、定常状態のスループットだけでなく、滞留からの回復をテストすることです。通常のトラフィックなら問題なく処理できるクラスターでも、回復のための滞留分とライブのトラフィックを同時に処理しなければならなくなると苦戦することがあります。そしてそれこそが、切り替えの失敗やDRからのフェイルバックで直面するシナリオです。
移行後のアーキテクチャでキュータイプが変わる、レプリケーションのホップが加わる、あるいは基盤となるインフラが変わるのであれば、旧システムにあったキャパシティの余裕がそのまま引き継がれるわけではありません。本番稼働日の最中ではなく、その前に検証してください。
見落とされやすいプラグインとクライアントライブラリの依存関係は?
基本的な棚卸しに加えて、移行の途中で不釣り合いなほど頻繁に問題になる依存関係がいくつかあります。
- FederationとShovelのプラグインのバージョンのずれ。これらのプラグインはコアのブローカーとは別にリリースされるため、移行先のバージョンに対して改めて検証する必要があります。互換性がそのまま引き継がれると思い込まないでください。
- ライセンスに紐づくErlang/OTPの互換性。現行の安定版シリーズのコミュニティ版RabbitMQは、時間の経過とともに古いErlangランタイム向けのパッチを受け取らなくなります。また、RabbitMQのシリーズによっては、新しいErlangのメジャーバージョンへの移行に商用ライセンスが必要になることがあります。これはチームの想定をはるかに上回る頻度で移行計画の段階に表面化し、単純な技術的アップグレードを、期限付きの調達の話に変えてしまうことがあります。
- 旧環境に合わせてチューニングされた、クライアント側の接続とタイムアウトのデフォルト値。オンプレミスの低レイテンシなネットワーク向けにチューニングされたハートビートとTCPタイムアウトの設定は、移行によってトラフィックがアベイラビリティゾーンをまたいだりNATゲートウェイを経由したりするようになると、誤検知による切断を引き起こします。後から原因不明のインシデントとしてデバッグするのではなく、切り替え前に見つけておくべき変更です。
- 古いクライアントライブラリやランタイムのままのアプリケーション。こうしたアプリケーションには、控えめなデフォルト値(たとえば、コンテナで実際に使えるメモリよりはるかに小さく設定されたJVMのメモリ設定)が残っていることが多く、それが静かにスループットの上限を作っています。移行テストで特定の性能目標を達成しようとして初めて、それが見えてくるのです。
準備アセスメントにはどのくらいの期間がかかり、最後に何が得られるのか?
期間は範囲によって決まります。コンシューマーのアプリケーションが少ない単一クラスターのバージョンアップグレードであれば、通常は1週間の案件です。Federation、カスタムプラグイン、数十のコンシューマーアプリケーションを抱えるマルチリージョン構成では、棚卸し、リスク評価、負荷テストをきちんと行うのにもっと時間がかかり、通常は2〜3週間です。
いずれの場合も、最終的に次のものが手元に残るはずです。
- トポロジー、プラグイン、クライアントライブラリの完全な棚卸し。移行計画の土台となる信頼できる情報源です
- ありきたりの重大度リストではなく、具体的な障害条件とその下流への影響を記述したリスク登録簿
- 移行の各ステップについて、明確なトリガーと元に戻す操作を定義したロールバック計画
- 滞留からの回復シナリオを含む、移行後の構成に対する負荷テストの結果
- 実施可否(Go/No-Go)の推奨と、切り替え日より前に優先して解決すべきブロッカー
- 移行後の検証基準と、移行先のクラスターが実際のトラフィックを処理し始めた後の短期間の最適化
この案件の費用は、アセスメントを省いた場合の総保有コストと比べて検討してください。本番負荷の下での計画外のロールバックは、ほぼ必ずアセスメントそのものより高くつきます。バージョンアップグレード、プラットフォームの移行、アーキテクチャの変更を計画していて、切り替え日を確定する前に構造化された準備の関門を設けたい場合は、当社のRabbitMQチームが、移行そのものとあわせてこうしたアセスメントを実施します。お客様のスケジュールに合わせた範囲の設定について、お気軽にご相談ください。
このチェックリストは、RabbitMQ移行ガイドの7つのステップのうち2つ目にあたります。ガイドでは、意思決定、棚卸し、セマンティクスの対応付け、移行先の構築、切り替え、検証を順に解説しています。
よくある質問
RabbitMQの移行準備アセスメントとは何ですか?
メジャーバージョンのアップグレード、プラットフォームの移行、アーキテクチャの変更の前に、ある時点で実施するレビューです。現在のトポロジーと依存関係を棚卸しし、移行がうまくいかなかった場合に何が壊れるかを特定し、検証済みのロールバック計画を作成し、移行先の環境が実際の本番負荷に耐えられることを検証します。そして最後に、実施するか見送るか(Go/No-Go)の判断を提示します。
移行準備アセスメントは、一般的なRabbitMQのヘルスチェックとどう違うのですか?
ヘルスチェックは、クラスターのサイジング、セキュリティのベースライン、設定のドリフトといった運用の健全性を定期的に確認するもので、予定されている変更とは関係なく実施します。移行準備アセスメントは、特定の1回の切り替えを対象とし、明確な期限があり、ヘルスチェックでは作成しない成果物を作ります。ロールバック計画、切り替えのリスク登録簿、そして現在の状態だけでなく移行後の状態を対象とした負荷テストです。
現状の棚卸しでは何を押さえる必要がありますか?
すべてのキュー、エクスチェンジ、バインディングと、そのトポロジーが自動化の中で定義されているのか、手作業で作られた文書化されていない設定としてしか存在しないのか。Federation、Shovel、独自開発やカスタムのプラグインを含め、使用しているすべてのプラグイン。そしてブローカーのバージョンだけでなく、パブリッシュまたはコンシュームを行うすべてのアプリケーションで動いているクライアントライブラリとランタイムのバージョンです。
ロールバック計画には、具体的に何を含めるべきですか?
中止を意味する具体的なメトリクスや障害条件という明確なトリガーと、すべてのステップについての「どう元に戻すか」の記述です。ありきたりの「バックアップから復元」では不十分です。実際には、旧環境と新環境を並行稼働させ、コンシューマーのグループを段階的に移行するのが一般的です。そうすれば、どの段階でも、すでに成功した段階に手を付けずにトラフィックを元に戻せます。
ハードウェアを変更しない場合でも、負荷テストは必要ですか?
はい。バージョンアップグレードやトポロジーの変更(たとえばクラシックミラーキューからクォーラムキューへの移行や、ディザスタリカバリのためのレプリケーション経路の追加)は、同じハードウェア上でも負荷がかかったときのブローカーの挙動を変えます。定常状態のトラフィックだけでなく、実際のピーク時のスループットと、滞留メッセージからの回復シナリオに対してテストしてください。
RabbitMQの移行準備アセスメントには、どのくらいの期間がかかりますか?
クラスターの数とトポロジーの複雑さによりますが、通常は1〜3週間です。コンシューマーのアプリケーションが数個程度の単一クラスターのアップグレードなら、約1週間で対応できます。Federation、カスタムプラグイン、数十のコンシューマーアプリケーションを抱えるマルチリージョン構成では、棚卸しと負荷テストをきちんと行うのにもっと時間がかかります。
どのような場合にアセスメントが必要になりますか?
メジャーバージョンのアップグレード(特にキュータイプのデフォルトやErlangの互換性が変わるもの)、Kubernetesや新しいデータセンターへの移行といったプラットフォームの移行、ディザスタリカバリのためのレプリケーションの追加といったアーキテクチャの変更、あるいは期限付きでバージョンの引き上げを迫られるライセンスの変更です。
著者
Talk to an engineer
Need a hand with RabbitMQ?
Senior engineers who run it in production. Get a quote or a free consultation, no sales pitch.
ガイド・製品比較・調査レポート