On this page
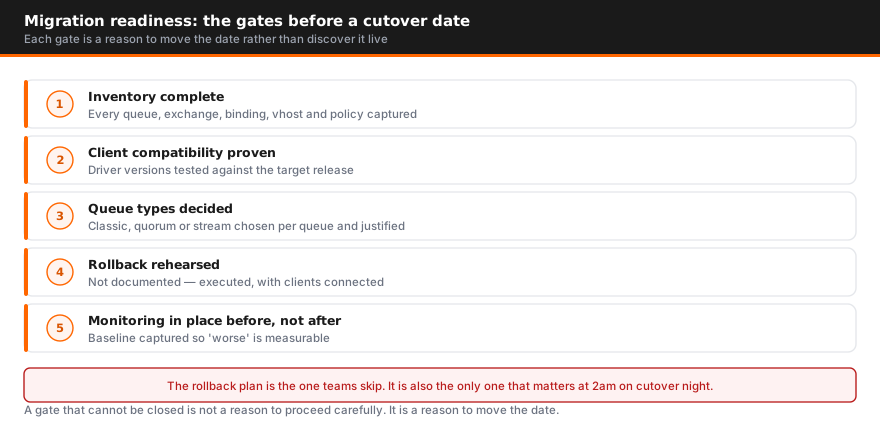
Una evaluación de preparación para la migración de RabbitMQ es una compuerta puntual que se pasa antes de una actualización mayor, un cambio de plataforma o un cambio de arquitectura; no es un health check continuo. Confirma que su topología y sus dependencias están completamente inventariadas, que usted sabe qué se rompe si falla un paso, que tiene un rollback probado y que el entorno de destino puede absorber la carga real de producción.
La mayoría de los equipos que salen mal parados de una migración de RabbitMQ no tenían un clúster roto antes de empezar. Tenían un entorno estable, un plan razonable y una fecha de salida a producción, y descubrieron a mitad del corte que la topología de una cola solo existía en la cabeza de un ingeniero, que un consumidor aguas abajo seguía usando una librería cliente de tres versiones mayores atrás, o que su plan de rollback era 'restaurar desde el backup' sin tener idea de cuánto tardaría eso realmente bajo carga.
Para detectar exactamente eso existe una evaluación estructurada de preparación previa a la migración: antes de que empiece la ventana de mantenimiento, no durante ella.
¿Qué es una evaluación de preparación para la migración de RabbitMQ?
Es una revisión de alcance fijo atada a un cambio planificado específico: una actualización de versión, el paso a una nueva infraestructura (Kubernetes, un nuevo data center, una nueva región de nube) o un cambio de arquitectura, como agregar replicación federada para recuperación ante desastres. No es una suscripción ni una herramienta de monitoreo.
El resultado es una hoja de ruta de la migración y un reporte de preparación con una recomendación clara: avanzar, avanzar después de corregir puntos específicos, o todavía no. Cubre cada carga de trabajo que toca la migración, no solo el broker. Es un entregable distinto al de un health check general, y conviene tener clara la diferencia antes de definir el alcance.
¿En qué se diferencia una evaluación de preparación para la migración de un health check general de RabbitMQ?
Se parecen en el método (ambas examinan la configuración del clúster, la topología de colas y el estado de las versiones), pero responden preguntas distintas. Un health check de RabbitMQ pregunta: '¿este despliegue está sano ahora y qué deberíamos corregir en general?'. Se hace de forma periódica, sin relación con ningún cambio planificado, y sus hallazgos (classic mirrored queues, usuarios con permisos excesivos, heartbeats mal configurados) aplican tanto si va a migrar algo como si no.
Una evaluación de preparación para la migración hace una pregunta más acotada y con más en juego: '¿podemos ejecutar este corte específico, en esta fecha, sin una caída ni pérdida de datos? Y si no, ¿qué tiene que cambiar primero?'. Ese enfoque cambia los entregables. Una evaluación de preparación produce un plan de rollback acotado a los pasos exactos de la migración, un registro de riesgos con qué se rompe y bajo qué condición, y pruebas de carga sobre la configuración de destino, no solo una foto de la salud actual. Si no tiene un corte específico planificado, lo que necesita es el health check. Si tiene una actualización o un cambio de plataforma en el calendario, necesita esto.
¿Qué debe registrar realmente el inventario previo a la migración?
El inventario es la parte que los equipos subestiman con más frecuencia, porque la mayor parte vive fuera de la propia configuración del broker. Hay cuatro cosas que registrar antes de poder planificar una migración con algo de confianza:
- La topología de colas, exchanges y bindings, y si está definida en automatización. Hace poco trabajamos con una empresa de procesamiento de pagos cuya instalación del clúster estaba totalmente automatizada, pero cuyas colas, exchanges y enlaces de Federation se habían creado a mano y no existían en ningún código. Es una brecha común, y significa que la topología no se puede reconstruir de forma confiable en un clúster nuevo sin que alguien la deduzca manualmente del sistema en ejecución.
- Dependencias de plugins. Federation, Shovel y cualquier plugin personalizado o de un proveedor deben verificarse uno por uno contra la versión de RabbitMQ de destino: que un plugin sea compatible con su versión actual no lo hace automáticamente compatible con la versión a la que va a migrar.
- Versiones de librerías cliente y de runtime en cada aplicación consumidora. No la versión del broker, sino la del cliente. Las aplicaciones con librerías cliente antiguas o runtimes desactualizados suelen arrastrar configuraciones de conexión, threading o memoria mal ajustadas que solo se vuelven un problema cuando cambian los patrones de tráfico o el comportamiento del broker durante una migración.
- Compatibilidad de tipos de cola y versiones. Las classic mirrored queues son terreno deprecado de cara a las nuevas versiones mayores de RabbitMQ, y el soporte de versiones de Erlang/OTP depende de su versión de RabbitMQ: la edición comunitaria de 3.13.x, por ejemplo, no admite el runtime Erlang 27, lo que obliga a hablar de licenciamiento a cualquier equipo que quiera mantenerse al día sin una actualización completa.
Nada de esto es exótico. Simplemente es lo bastante tedioso como para que los equipos con una fecha límite lo salteen, y después lo redescubran en vivo durante la migración.
¿Cómo se evalúa el riesgo antes de migrar RabbitMQ? ¿Qué se rompe realmente?
Evaluar el riesgo de una migración significa recorrer condiciones de falla específicas, no producir una lista genérica ordenada por severidad. La versión útil de este ejercicio responde: para cada paso de la migración, ¿qué se rompe si falla y cómo se ve esa falla aguas abajo?
Un ejemplo concreto de un proyecto de replicación para recuperación ante desastres que acotamos con un cliente de procesamiento de pagos: el enfoque propuesto usaba exchanges federados para replicar mensajes a un sitio secundario. Los exchanges federados replican mensajes, no el estado del broker; así que, si el lado de DR se cae, los mensajes replicados se acumulan localmente en lugar de perderse, pero un simulacro real de DR podría implicar recuperar un backlog de cientos de miles de mensajes una vez que el enlace se reconecta. Ese tráfico de recuperación cae directamente sobre el clúster de producción y hay que tenerlo en cuenta, o se convierte en un incidente en sí mismo.
Esa es la forma de una evaluación de riesgos real: garantías de orden de los mensajes, supuestos de idempotencia del lado del consumidor, si una reconexión después de una caída provoca un backlog lo bastante grande como para afectar el throughput de producción, y si las aplicaciones cliente realmente manejan bien las reentregas en lugar de dar por sentado un comportamiento exactly-once que nunca se les garantizó. Cada uno de esos puntos es específico de su arquitectura y de sus aplicaciones: un checklist de plantilla no los va a hacer aparecer, pero recorrer la migración paso a paso sí.
¿Qué debe incluir un plan de rollback?
'Restaurar desde el backup' no es un plan de rollback para un sistema de mensajería en vivo: no dice cuánto tarda la recuperación, qué mensajes se pierden en el intervalo ni cómo se comportan los consumidores aguas abajo mientras tanto. Un plan de rollback real define, para cada paso de la migración, la condición específica que dispara el aborto y la acción específica para revertir ese paso.
En la práctica, el patrón que funciona es operar los entornos actual y de destino en paralelo en lugar de migrar sobre la misma infraestructura. Levante el clúster nuevo junto al viejo, mueva las aplicaciones consumidoras por olas y mantenga el clúster viejo activo y recibiendo tráfico hasta que las olas migradas demuestren ser estables, a menudo durante todo un ciclo de tráfico pico. Si una ola muestra un problema, ese grupo de consumidores vuelve al clúster viejo sin tocar nada de lo que ya migró con éxito. Eso solo funciona si la ruta de rollback se diseñó desde el principio; es muy difícil agregarla cuando ya está a mitad del corte.
Si no puede describir en una oración la acción de rollback de un paso, ese paso no está listo para ejecutarse.
Si la actualización es también el momento de pasar a una versión con soporte, licenciamiento comercial de RabbitMQ explica qué incluye una suscripción comercial y cómo se cotiza.
¿Cómo se valida la carga y la capacidad antes del corte?
Las pruebas de carga previas a una migración tienen que construirse a partir de su tráfico real, no de un benchmark sintético. Extraiga datos históricos de profundidad de colas y tasa de mensajes de lo que ya tenga (Prometheus, Grafana, Dynatrace o la propia API de administración del broker) para armar un perfil realista del throughput pico, los patrones de ráfagas y la distribución de tamaños de mensaje antes de diseñar la prueba.
Hay dos cosas que vale la pena probar y que los equipos suelen saltear. Primero, pruebe con su pico real, no con la carga promedio: una plataforma de pagos con la que trabajamos estaba acotando un enfoque de replicación que debía sostener alrededor de 2,000 mensajes por segundo de forma continua, y la respuesta honesta sobre si Federation podía mantener ese ritmo con las restricciones de red requería pruebas de carga reales, no una estimación. Segundo, pruebe la recuperación de un backlog, no solo el throughput en régimen estable. Un clúster que maneja bien el tráfico normal puede tener problemas cuando debe procesar al mismo tiempo un backlog de recuperación y el tráfico en vivo, que es exactamente el escenario en el que lo deja un corte fallido o un failback de DR.
Si su arquitectura de destino cambia el tipo de cola, agrega un salto de replicación o pasa a otra infraestructura subyacente, el margen de capacidad que existía en el sistema viejo no se traslada automáticamente. Valídelo antes de la fecha de salida a producción, no durante.
¿Qué dependencias de plugins y librerías cliente se pasan por alto con más frecuencia?
Más allá del inventario base, hay algunos problemas de dependencias que aparecen con una frecuencia desproporcionada cuando los equipos ya están a mitad de la migración:
- Desfase de versiones de los plugins Federation y Shovel. Estos plugins se publican de forma independiente del broker y hay que volver a verificarlos contra la versión de destino: no dé por sentado que la compatibilidad se mantiene.
- Compatibilidad de Erlang/OTP atada al licenciamiento. Con el tiempo, RabbitMQ comunitario en la serie estable actual deja de recibir parches para los runtimes de Erlang más antiguos, y pasar a una versión mayor más nueva de Erlang a veces queda condicionado a una licencia comercial, según su serie de RabbitMQ. Esto aparece durante la planificación de la migración mucho más seguido de lo que los equipos esperan, y puede convertir una actualización técnica sencilla en una conversación de compras con fecha límite.
- Valores por defecto de conexión y timeout del lado del cliente ajustados para el entorno viejo. Los ajustes de heartbeat y de timeout TCP pensados para redes on-premises de baja latencia provocan desconexiones falsas en cuanto una migración mueve el tráfico entre zonas de disponibilidad o a través de un NAT gateway; conviene detectarlo antes del corte y no depurarlo después como un incidente misterioso.
- Aplicaciones que todavía usan librerías cliente o runtimes antiguos. Suelen arrastrar valores por defecto conservadores (por ejemplo, configuraciones de memoria de la JVM muy por debajo de lo que el contenedor tiene disponible) que limitan el throughput en silencio y solo se notan cuando se intenta alcanzar un objetivo de rendimiento concreto durante las pruebas de migración.
¿Cuánto tarda una evaluación de preparación y qué recibe al final?
El alcance define el plazo. Una actualización de versión de un solo clúster con pocas aplicaciones consumidoras suele ser un proyecto de una semana. Un despliegue multirregión con Federation, plugins personalizados y decenas de aplicaciones consumidoras lleva más tiempo para inventariarlo, evaluar sus riesgos y probarlo bajo carga como corresponde: normalmente de dos a tres semanas.
En cualquier caso, usted debería terminar con:
- Un inventario completo de topología, plugins y librerías cliente: la fuente de verdad sobre la que se construye el plan de migración
- Un registro de riesgos que describe condiciones de falla específicas y su impacto aguas abajo, no una lista genérica de severidades
- Un plan de rollback con un disparador definido y una acción de reversión para cada paso de la migración
- Resultados de pruebas de carga sobre la configuración de destino, incluidos escenarios de recuperación de backlog
- Una recomendación de go/no-go con los problemas bloqueantes priorizados antes de la fecha de corte
- Criterios de validación posteriores a la migración y una breve etapa de optimización cuando el clúster de destino ya esté llevando tráfico real
Compare el costo de ese proyecto con el costo total de propiedad de saltearlo: un rollback no planificado bajo carga de producción casi siempre sale más caro que la evaluación en sí. Si está planificando una actualización de versión, un cambio de plataforma o un cambio de arquitectura y quiere una compuerta de preparación estructurada antes de comprometerse con una fecha de corte, nuestro equipo de RabbitMQ hace estas evaluaciones junto con las migraciones. Hable con nosotros para definir el alcance según sus plazos.
Este checklist es el paso dos de siete de la guía de migración de RabbitMQ, que ordena la decisión, el inventario, el mapeo semántico, la construcción del destino, el corte y la validación.
Preguntas frecuentes
¿Qué es una evaluación de preparación para la migración de RabbitMQ?
Una revisión puntual que se hace antes de una actualización de versión mayor, un cambio de plataforma o un cambio de arquitectura. Inventaría su topología y sus dependencias actuales, identifica qué se rompe si la migración sale mal, produce un plan de rollback probado y valida que el entorno de destino soporte la carga real de producción, y termina con una recomendación de go/no-go.
¿En qué se diferencia una evaluación de preparación para la migración de un health check general de RabbitMQ?
Un health check es una foto periódica de la salud operativa (dimensionamiento del clúster, línea base de seguridad, desviaciones de configuración) que se hace sin relación con ningún cambio planificado. Una evaluación de preparación para la migración se acota a un corte específico, tiene una fecha límite firme y produce entregables que un health check no produce: un plan de rollback, un registro de riesgos del corte y pruebas de carga sobre el estado de destino, no solo sobre el actual.
¿Qué debe cubrir el inventario del estado actual?
Cada cola, exchange y binding, y si esa topología está definida en automatización o existe solo como configuración manual sin documentar; cada plugin en uso, incluidos Federation, Shovel y cualquier plugin personalizado o desarrollado internamente; y la versión de la librería cliente y del runtime en cada aplicación que publica o consume, no solo la versión del broker.
¿Qué debe incluir realmente un plan de rollback?
Un disparador definido (la métrica o condición de falla específica que indica que hay que abortar) y una forma de revertir cada paso, no un genérico 'restaurar desde el backup'. En la práctica, esto suele significar operar los entornos viejo y nuevo en paralelo y migrar los grupos de consumidores por olas, para que cualquier ola pueda volver al entorno anterior sin tocar las que ya migraron con éxito.
¿Hacen falta pruebas de carga si no vamos a cambiar el hardware?
Sí. Una actualización de versión o un cambio de topología (por ejemplo, pasar de classic mirrored queues a colas de quórum, o agregar una ruta de replicación para recuperación ante desastres) cambia el comportamiento del broker bajo carga incluso con hardware idéntico. Pruebe con su throughput pico real y con escenarios de recuperación de backlog, no solo con tráfico en régimen estable.
¿Cuánto tarda una evaluación de preparación para la migración de RabbitMQ?
Normalmente de una a tres semanas, según la cantidad de clústeres y la complejidad de la topología. Una actualización de un solo clúster con unas pocas aplicaciones consumidoras se puede acotar en alrededor de una semana; un despliegue multirregión con Federation, plugins personalizados y decenas de aplicaciones consumidoras lleva más tiempo para inventariarlo y probarlo bajo carga como corresponde.
¿Qué suele hacer necesaria una evaluación así?
Una actualización de versión mayor (sobre todo si cambia los tipos de cola por defecto o la compatibilidad con Erlang), un cambio de plataforma, como pasar a Kubernetes o a un nuevo data center, un cambio de arquitectura, como agregar replicación para recuperación ante desastres, o un cambio de licenciamiento que obliga a saltar de versión con fecha límite.
Autor
Talk to an engineer
Need a hand with RabbitMQ?
Senior engineers who run it in production. Get a quote or a free consultation, no sales pitch.
Guías, comparativas e investigación