
On this page
Un assessment di readiness per la migrazione RabbitMQ è un punto di controllo puntuale da superare prima di un aggiornamento importante, di un cambio di piattaforma o di una modifica architetturale, non un health check continuativo. Conferma che topologia e dipendenze siano state inventariate per intero, che sappiate che cosa si rompe se uno step fallisce, che abbiate un rollback collaudato e che l'ambiente di destinazione possa assorbire il carico reale di produzione.
La maggior parte dei team che si scotta con una migrazione RabbitMQ non aveva un cluster guasto in partenza. Avevano un ambiente stabile, un piano ragionevole e una data di go-live, e hanno scoperto a metà cutover che la topologia di una coda esisteva solo nella testa di un ingegnere, che un consumer a valle usava ancora una libreria client vecchia di tre major version, o che il loro piano di rollback era 'ripristino da backup' senza alcuna idea di quanto avrebbe richiesto davvero sotto carico.
È esattamente ciò che un assessment strutturato di readiness pre-migrazione è pensato per intercettare, prima che inizi la finestra di manutenzione e non durante.
Che cos'è un assessment di readiness per la migrazione RabbitMQ?
È una revisione a perimetro fisso legata a una specifica modifica pianificata: un aggiornamento di versione, il passaggio a una nuova infrastruttura (Kubernetes, un nuovo data center, una nuova regione cloud) o una modifica architetturale come l'aggiunta della replica federata per il disaster recovery. Non è un abbonamento e non è uno strumento di monitoraggio.
Il risultato è una roadmap di migrazione e un report di readiness con una raccomandazione chiara: si procede, si procede dopo correzioni specifiche, oppure non ancora. Copre ogni workload toccato dalla migrazione, non solo il broker. È un deliverable diverso da un health check generale, e conviene avere chiara la differenza prima di definirne il perimetro.
In che cosa un assessment di readiness per la migrazione differisce da un normale health check di RabbitMQ?
Il metodo è in parte lo stesso (entrambi esaminano configurazione del cluster, topologia delle code e stato delle versioni), ma rispondono a domande diverse. Un health check di RabbitMQ si chiede: 'questo deployment è in salute adesso, e che cosa dovremmo correggere in generale?'. Viene eseguito periodicamente, indipendentemente da qualsiasi modifica pianificata, e i suoi risultati (classic mirrored queue, utenti con permessi eccessivi, heartbeat configurati male) valgono che stiate migrando qualcosa oppure no.
Un assessment di readiness per la migrazione si pone una domanda più circoscritta e con una posta in gioco più alta: 'possiamo eseguire questo cutover specifico, in questa data, senza disservizi né perdita di dati, e se no, che cosa deve cambiare prima?'. Questa impostazione cambia i deliverable. Un assessment di readiness produce un piano di rollback circoscritto agli step esatti della migrazione, un registro dei rischi che descrive che cosa si rompe e in quale condizione, e test di carico eseguiti sulla configurazione di destinazione, non solo una fotografia della salute attuale. Se non state pianificando un cutover specifico, vi serve l'health check. Se avete un aggiornamento o un cambio di piattaforma in calendario, vi serve questo.
Che cosa deve registrare davvero un inventario pre-migrazione?
L'inventario è la parte che i team sottodimensionano con maggiore regolarità, perché gran parte di esso si trova al di fuori della configurazione del broker. Prima di poter pianificare una migrazione con un minimo di fiducia vanno registrati quattro elementi:
- Topologia di code, exchange e binding, e se è definita nell'automazione. Di recente abbiamo lavorato con una società di elaborazione dei pagamenti la cui installazione del cluster era completamente automatizzata, mentre code, exchange e link di federation erano stati creati a mano e non esistevano da nessuna parte nel codice. È una lacuna comune, e significa che la topologia non può essere ricostruita in modo affidabile su un nuovo cluster senza che qualcuno la ricavi manualmente dal sistema in esercizio.
- Dipendenze dai plugin. Federation, Shovel ed eventuali plugin personalizzati o di terze parti vanno verificati uno per uno rispetto alla versione RabbitMQ di destinazione: un plugin compatibile con la versione attuale non lo è automaticamente con quella verso cui migrate.
- Versioni delle librerie client e dei runtime in ogni applicazione consumer. Non la versione del broker, quella del client. Le applicazioni con librerie client datate o runtime obsoleti hanno spesso impostazioni di connessione, threading o memoria poco ottimizzate, che emergono come problema solo quando durante una migrazione cambiano i pattern di traffico o il comportamento del broker.
- Tipo di coda e compatibilità di versione. Le classic mirrored queue sono territorio deprecato nelle major version più recenti di RabbitMQ, e il supporto delle versioni di Erlang/OTP è legato alla vostra versione di RabbitMQ: la community edition della 3.13.x, ad esempio, non supporta il runtime Erlang 27, il che impone una discussione sulle licenze a qualsiasi team voglia restare aggiornato senza un aggiornamento completo.
Niente di tutto ciò è esotico. È solo abbastanza noioso da far sì che i team sotto scadenza lo saltino, per poi riscoprirlo in diretta durante la migrazione.
Come si valuta il rischio prima di una migrazione RabbitMQ: che cosa si rompe davvero?
L'analisi dei rischi per una migrazione consiste nell'esaminare condizioni di guasto specifiche, non nel produrre un elenco generico ordinato per severità. La versione utile di questo esercizio risponde a una domanda: per ogni step della migrazione, che cosa si rompe se fallisce, e come si manifesta quel guasto a valle?
Un esempio concreto viene da un progetto di replica per il disaster recovery che abbiamo definito con un cliente del settore dei pagamenti: l'approccio proposto usava exchange federati per replicare i messaggi verso un sito secondario. Gli exchange federati replicano i messaggi, non lo stato del broker: se il lato DR va giù, i messaggi da replicare si accumulano in locale invece di andare persi, ma una vera esercitazione di DR potrebbe comportare il recupero di un backlog dell'ordine delle centinaia di migliaia di messaggi una volta che il link si riconnette. Quel traffico di recupero arriva direttamente sul cluster di produzione e va messo in conto, altrimenti diventa un incidente a sé.
Ecco la forma di una vera analisi dei rischi: garanzie di ordinamento dei messaggi, ipotesi di idempotenza lato consumer, se una riconnessione dopo un disservizio genera un backlog abbastanza grande da incidere sul throughput di produzione, e se le applicazioni client gestiscono davvero correttamente la riconsegna invece di dare per scontato un comportamento exactly-once che non è mai stato garantito. Ciascuno di questi aspetti è specifico della vostra architettura e delle vostre applicazioni: una checklist preconfezionata non li farà emergere, mentre ripercorrere la migrazione step per step sì.
Che cosa deve includere un piano di rollback?
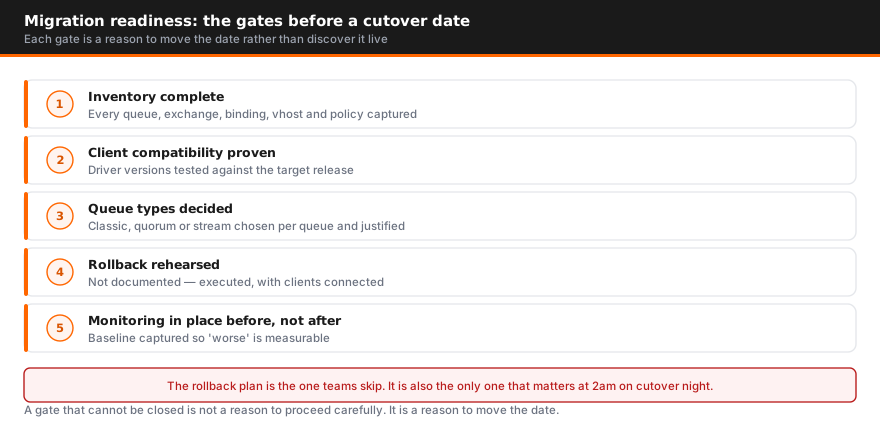
'Ripristino da backup' non è un piano di rollback per un sistema di messaggistica in esercizio: non dice quanto dura il ripristino, quali messaggi vanno persi nel frattempo né come si comportano i consumer a valle mentre accade. Un vero piano di rollback definisce, per ogni step della migrazione, la condizione di trigger specifica che impone di interrompere e l'azione specifica per annullare quello step.
In pratica, lo schema che funziona è eseguire in parallelo l'ambiente attuale e quello di destinazione invece di migrare sul posto. Si mette in piedi il nuovo cluster accanto al vecchio, si spostano le applicazioni consumer a ondate e si mantiene il vecchio cluster attivo e in grado di ricevere traffico finché le ondate migrate non si sono dimostrate stabili, spesso per un intero ciclo di traffico di picco. Se un'ondata mostra un problema, si reindirizza quel consumer group verso il vecchio cluster senza toccare nulla di ciò che è già stato migrato con successo. Funziona solo se il percorso di rollback è stato progettato fin dall'inizio; è molto difficile introdurlo a posteriori quando si è già a metà cutover.
Se non riuscite a descrivere in una frase l'azione di rollback per un dato step, quello step non è pronto per essere eseguito.
Se l'aggiornamento è anche il momento in cui passate a una build supportata, la pagina sul licensing commerciale di RabbitMQ spiega che cosa include una subscription commerciale e come viene tariffata.
Come si convalidano carico e capacità prima del cutover?
I test di carico prima di una migrazione vanno costruiti sul vostro traffico reale, non su un benchmark sintetico. Estraete i dati storici di profondità delle code e di tasso dei messaggi da ciò di cui già disponete (Prometheus, Grafana, Dynatrace o la management API del broker) per costruire un profilo realistico di throughput di picco, pattern di burst e distribuzione delle dimensioni dei messaggi prima di progettare il test.
Ci sono due aspetti che vale la pena testare e che i team spesso saltano. Primo, testate al vostro picco reale, non al carico medio: una piattaforma di pagamenti con cui abbiamo lavorato stava definendo un approccio di replica che doveva sostenere in modo continuativo circa 2.000 messaggi al secondo, e per rispondere onestamente alla domanda se la federation potesse reggerli con i vincoli di rete servivano test di carico reali, non una stima. Secondo, testate il recupero da un backlog, non solo il throughput a regime. Un cluster che gestisce senza problemi il traffico normale può comunque andare in difficoltà quando deve elaborare contemporaneamente un backlog di recupero e il traffico live, che è esattamente lo scenario in cui vi mette un cutover fallito o un failback dal DR.
Se l'architettura di destinazione cambia tipo di coda, aggiunge un passaggio di replica o si sposta su un'infrastruttura sottostante diversa, il margine di capacità che esisteva sul vecchio sistema non si trasferisce automaticamente. Convalidatelo prima della data di go-live, non durante.
Quali dipendenze da plugin e librerie client vengono trascurate più spesso?
Oltre all'inventario di base, alcuni problemi di dipendenze emergono con frequenza sproporzionata quando i team sono già a metà migrazione:
- Disallineamento di versione dei plugin federation e Shovel. Questi plugin vengono rilasciati indipendentemente dal broker e vanno riverificati sulla versione di destinazione: non date per scontato che la compatibilità si mantenga.
- Compatibilità con Erlang/OTP legata alle licenze. RabbitMQ community sulla serie stabile corrente smette nel tempo di ricevere patch per i runtime Erlang più vecchi, e il passaggio a una major version di Erlang più recente è talvolta subordinato a una licenza commerciale, a seconda della vostra serie di RabbitMQ. Questo emerge durante la pianificazione della migrazione molto più spesso di quanto i team si aspettino, e può trasformare un semplice aggiornamento tecnico in una trattativa di procurement con una scadenza.
- Valori predefiniti di connessione e timeout lato client calibrati sul vecchio ambiente. Impostazioni di heartbeat e di timeout TCP pensate per reti on-premise a bassa latenza causano disconnessioni falsamente positive quando una migrazione sposta il traffico tra availability zone o attraverso un NAT gateway: un cambiamento da intercettare prima del cutover anziché da indagare a posteriori come un incidente misterioso.
- Applicazioni che usano ancora librerie client o runtime datati. Spesso hanno impostazioni predefinite prudenti, ad esempio impostazioni di memoria della JVM dimensionate molto al di sotto di quanto il container abbia effettivamente a disposizione, che limitano silenziosamente il throughput e diventano visibili solo quando si cerca di raggiungere un obiettivo di prestazioni specifico durante i test di migrazione.
Quanto dura un assessment di readiness e che cosa si ottiene alla fine?
È il perimetro a determinare i tempi. L'aggiornamento di versione di un singolo cluster con poche applicazioni consumer richiede di solito una settimana di lavoro. Un deployment multi-regione con federation, plugin personalizzati e decine di applicazioni consumer richiede più tempo per inventario, analisi dei rischi e test di carico fatti come si deve: in genere da due a tre settimane.
In ogni caso, al termine dovreste avere:
- Un inventario completo di topologia, plugin e librerie client: la fonte di verità su cui si costruisce il piano di migrazione
- Un registro dei rischi che descrive condizioni di guasto specifiche e il loro impatto a valle, non un elenco generico per severità
- Un piano di rollback con un trigger definito e un'azione di annullamento per ogni step della migrazione
- I risultati dei test di carico sulla configurazione di destinazione, compresi gli scenari di recupero del backlog
- Una raccomandazione go/no-go con gli eventuali problemi bloccanti messi in priorità prima della data di cutover
- Criteri di validazione post-migrazione e un breve ciclo di ottimizzazione una volta che il cluster di destinazione sostiene traffico reale
Confrontate il costo di questo incarico con il costo totale di possesso del saltarlo: un rollback non pianificato sotto carico di produzione costa quasi sempre più dell'assessment stesso. Se state pianificando un aggiornamento di versione, un cambio di piattaforma o una modifica architetturale e volete un punto di controllo strutturato prima di impegnarvi su una data di cutover, il nostro team RabbitMQ esegue questi assessment insieme alle migrazioni stesse. Parlatene con noi per definirne uno in base alle vostre tempistiche.
La checklist è il secondo dei sette passaggi della guida alla migrazione RabbitMQ, che mette in sequenza la decisione, l'inventario, la mappatura semantica, la build di destinazione, il cutover e la validazione.
Domande frequenti
Che cos'è un assessment di readiness per la migrazione RabbitMQ?
Una revisione puntuale eseguita prima di un aggiornamento di major version, di un cambio di piattaforma o di una modifica architetturale. Inventaria la topologia e le dipendenze attuali, individua che cosa si rompe se la migrazione va male, produce un piano di rollback collaudato e verifica che l'ambiente di destinazione regga il carico reale di produzione, per concludersi con una raccomandazione go/no-go.
In che cosa un assessment di readiness per la migrazione differisce da un normale health check di RabbitMQ?
Un health check è una fotografia periodica della salute operativa (dimensionamento del cluster, baseline di sicurezza, drift della configurazione) eseguita indipendentemente da qualsiasi modifica pianificata. Un assessment di readiness per la migrazione è circoscritto a un cutover specifico, ha una scadenza precisa e produce deliverable che un health check non prevede: un piano di rollback, un registro dei rischi del cutover e test di carico sullo stato di destinazione, non solo su quello attuale.
Che cosa deve coprire l'inventario dello stato attuale?
Ogni coda, exchange e binding, e se quella topologia è definita nell'automazione o esiste solo come configurazione manuale non documentata; ogni plugin in uso, compresi federation, Shovel ed eventuali plugin personalizzati o sviluppati internamente; e la versione della libreria client e del runtime in esecuzione in ogni applicazione che pubblica o consuma, non solo la versione del broker.
Che cosa deve includere davvero un piano di rollback?
Un trigger definito, cioè la metrica o la condizione di errore specifica che impone di interrompere, e una dichiarazione di reversibilità per ogni step, non un generico 'ripristino da backup'. In pratica significa di solito eseguire in parallelo il vecchio e il nuovo ambiente e migrare i consumer group a ondate, così che ogni ondata possa essere reindirizzata indietro senza toccare quelle già riuscite.
Servono comunque i test di carico se non cambiamo l'hardware?
Sì. Un aggiornamento di versione o una modifica di topologia (ad esempio il passaggio dalle classic mirrored queue alle code quorum, o l'aggiunta di un percorso di replica per il disaster recovery) cambia il comportamento del broker sotto carico anche su hardware identico. Testate con il vostro throughput di picco reale e con scenari di recupero del backlog, non solo con il traffico a regime.
Quanto dura un assessment di readiness per la migrazione RabbitMQ?
Di solito da una a tre settimane, a seconda del numero di cluster e della complessità della topologia. L'aggiornamento di un singolo cluster con poche applicazioni consumer può essere definito in circa una settimana; un deployment multi-regione con federation, plugin personalizzati e decine di applicazioni consumer richiede più tempo per un inventario e test di carico fatti come si deve.
Che cosa rende di solito necessario un assessment di questo tipo?
Un aggiornamento di major version (soprattutto se cambia i tipi di coda predefiniti o la compatibilità con Erlang), un cambio di piattaforma come il passaggio a Kubernetes o a un nuovo data center, una modifica architetturale come l'aggiunta della replica per il disaster recovery, oppure un cambiamento di licenza che impone un salto di versione entro una scadenza.

Autore
Talk to an engineer
Need a hand with RabbitMQ?
Senior engineers who run it in production. Get a quote or a free consultation, no sales pitch.
Guide, confronti e ricerche


