
On this page
Ocena gotowości do migracji RabbitMQ to jednorazowa bramka, przez którą przechodzi się przed dużą aktualizacją, przeniesieniem na inną platformę lub zmianą architektury — a nie stały health check. Potwierdza, że topologia i zależności są w pełni zinwentaryzowane, wiadomo, co się zepsuje, jeśli któryś krok zawiedzie, istnieje przetestowany plan wycofania, a środowisko docelowe przyjmie rzeczywiste obciążenie produkcyjne.
Większość zespołów, które sparzyły się na migracji RabbitMQ, nie miała wcześniej zepsutego klastra. Miały stabilne środowisko, rozsądny plan i datę uruchomienia — a w połowie przełączenia odkryły, że topologia jakiejś kolejki istniała tylko w głowie jednego inżyniera, że jeden z konsumentów wciąż korzysta z biblioteki klienckiej sprzed trzech wersji głównych albo że plan wycofania brzmi „przywrócimy z kopii zapasowej”, bez pojęcia, ile to faktycznie potrwa pod obciążeniem.
Właśnie to ma wychwycić ustrukturyzowana ocena gotowości przed migracją — zanim zacznie się okno serwisowe, a nie w jego trakcie.
Czym jest ocena gotowości do migracji RabbitMQ?
To przegląd o stałym zakresie, powiązany z jedną konkretną planowaną zmianą: aktualizacją wersji, przeniesieniem na nową infrastrukturę (Kubernetes, nowe centrum danych, nowy region chmury) albo zmianą architektury, taką jak dodanie replikacji federacyjnej na potrzeby disaster recovery. Nie jest to subskrypcja ani narzędzie do monitoringu.
Rezultatem jest mapa drogowa migracji i raport gotowości z jasną rekomendacją: zaczynamy, zaczynamy po wprowadzeniu konkretnych poprawek albo jeszcze nie — obejmujący każde obciążenie, którego dotyczy migracja, a nie tylko sam broker. To inny produkt niż ogólny health check i warto precyzyjnie rozumieć tę różnicę, zanim określi się zakres oceny.
Czym ocena gotowości do migracji różni się od ogólnego health checku RabbitMQ?
Metodycznie się pokrywają — obie analizują konfigurację klastra, topologię kolejek i stan wersji — ale odpowiadają na różne pytania. RabbitMQ Health Check pyta: „czy to wdrożenie jest teraz w dobrej kondycji i co ogólnie powinniśmy poprawić?”. Przeprowadza się go okresowo, niezależnie od planowanych zmian, a jego ustalenia — klasyczne kolejki mirrorowane, użytkownicy z nadmiernymi uprawnieniami, błędna konfiguracja heartbeatów — obowiązują bez względu na to, czy cokolwiek jest migrowane.
Ocena gotowości do migracji zadaje węższe pytanie o wyższą stawkę: „czy możemy przeprowadzić to konkretne przełączenie, w tym terminie, bez przestoju i utraty danych — a jeśli nie, co musi się najpierw zmienić?”. Takie ujęcie zmienia rezultaty. Ocena gotowości daje plan wycofania obejmujący dokładnie kroki migracji, rejestr ryzyk opisujący, co i w jakich warunkach się psuje, oraz testy obciążeniowe konfiguracji docelowej — a nie tylko migawkę obecnej kondycji. Jeśli nie planują Państwo konkretnego przełączenia, potrzebny jest health check. Jeśli w kalendarzu jest aktualizacja lub przeniesienie na inną platformę, potrzebna jest właśnie ta ocena.
Co tak naprawdę powinna obejmować inwentaryzacja przed migracją?
Inwentaryzację zespoły najczęściej niedoszacowują, bo większość jej zakresu znajduje się poza konfiguracją samego brokera. Zanim będzie można z jakąkolwiek pewnością zaplanować migrację, trzeba ująć cztery rzeczy:
- Topologię kolejek, exchange'y i powiązań — oraz to, czy jest zdefiniowana w automatyzacji. Niedawno pracowaliśmy z firmą obsługującą płatności, której instalacja klastra była w pełni zautomatyzowana, ale kolejki, exchange'e i łącza federacyjne utworzono ręcznie i nie istniały nigdzie w kodzie. To częsta luka, która oznacza, że topologii nie da się niezawodnie odtworzyć na nowym klastrze, dopóki ktoś ręcznie nie odczyta jej z działającego systemu.
- Zależności od pluginów. Federation, Shovel oraz wszelkie pluginy niestandardowe lub dostawców trzeba sprawdzić pojedynczo pod kątem docelowej wersji RabbitMQ — plugin zgodny z obecną wersją nie jest automatycznie zgodny z tą, na którą Państwo migrują.
- Wersje bibliotek klienckich i środowisk uruchomieniowych w każdej aplikacji konsumującej. Nie wersję brokera — klienta. Aplikacje ze starymi bibliotekami klienckimi lub przestarzałymi środowiskami uruchomieniowymi często mają niedostrojone ustawienia połączeń, wątków lub pamięci, które stają się problemem dopiero wtedy, gdy podczas migracji zmieniają się wzorce ruchu lub zachowanie brokera.
- Zgodność typów kolejek i wersji. Klasyczne kolejki mirrorowane to w nowszych wersjach głównych RabbitMQ obszar wycofywany, a obsługa wersji Erlang/OTP jest powiązana z wersją RabbitMQ — na przykład wydanie społecznościowe 3.13.x nie obsługuje środowiska uruchomieniowego Erlang 27, co wymusza rozmowę o licencjach w każdym zespole, który chce pozostać na bieżąco bez pełnej aktualizacji.
Nic z tego nie jest egzotyczne. To po prostu na tyle żmudne, że zespoły pod presją terminu to pomijają, a potem odkrywają na żywo w trakcie migracji.
Jak ocenić ryzyko przed migracją RabbitMQ — co tak naprawdę się psuje?
Ocena ryzyka migracji oznacza przeanalizowanie konkretnych warunków awarii, a nie przygotowanie ogólnikowej listy uszeregowanej według ważności. Przydatna wersja tego ćwiczenia odpowiada na pytanie: co się zepsuje, jeśli dany krok migracji zawiedzie, i jak ta awaria będzie wyglądać dalej w łańcuchu przetwarzania?
Konkretny przykład z projektu replikacji na potrzeby disaster recovery, którego zakres określaliśmy dla klienta z branży płatności: proponowane podejście wykorzystywało exchange'e federacyjne do replikowania komunikatów do lokalizacji zapasowej. Exchange'e federacyjne replikują komunikaty, a nie stan brokera — jeśli więc strona DR przestanie działać, replikowane komunikaty nie giną, lecz gromadzą się lokalnie, ale prawdziwe ćwiczenie DR może oznaczać odrabianie zaległości liczonych w setkach tysięcy komunikatów po ponownym zestawieniu łącza. Ten ruch trafia bezpośrednio na klaster produkcyjny i trzeba go uwzględnić, bo inaczej sam stanie się incydentem.
Tak wygląda prawdziwa ocena ryzyka: gwarancje kolejności komunikatów, założenia dotyczące idempotentności po stronie konsumentów, to, czy ponowne połączenie po awarii wywoła zaległości na tyle duże, że wpłyną na przepustowość produkcyjną, oraz to, czy aplikacje klienckie rzeczywiście poprawnie obsługują ponowne dostarczenia, zamiast zakładać semantykę exactly-once, której nikt im nigdy nie gwarantował. Każdy z tych punktów jest specyficzny dla Państwa architektury i aplikacji — szablonowa lista kontrolna ich nie ujawni, ale przejście migracji krok po kroku już tak.
Co musi zawierać plan wycofania?
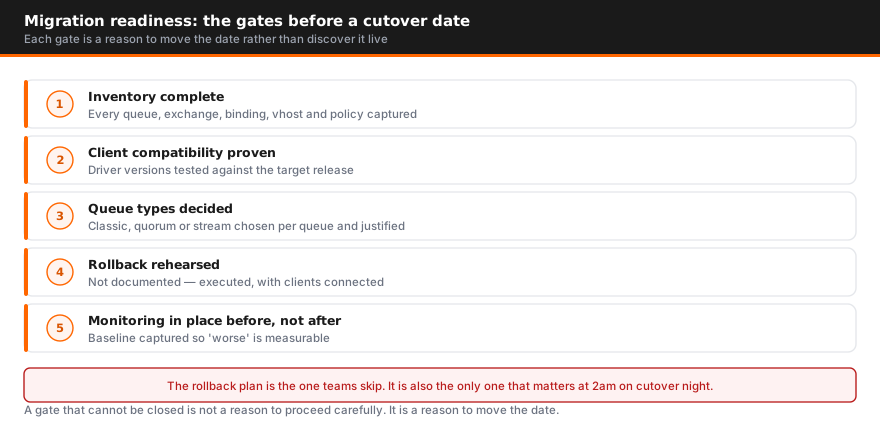
„Przywrócimy z kopii zapasowej” to nie jest plan wycofania dla działającego systemu komunikacyjnego — nie mówi, ile potrwa odtwarzanie, które komunikaty przepadną w tej luce ani jak w tym czasie zachowają się konsumenci. Prawdziwy plan wycofania definiuje dla każdego kroku migracji konkretny warunek, który oznacza przerwanie, oraz konkretną czynność odwracającą ten krok.
W praktyce sprawdza się wzorzec równoległego uruchomienia obecnego i docelowego środowiska zamiast migracji w miejscu. Nowy klaster stawia się obok starego, aplikacje konsumujące przenosi falami, a stary klaster pozostaje aktywny i przyjmuje ruch, dopóki przeniesione fale nie okażą się stabilne — często przez cały cykl ruchu szczytowego. Jeśli w którejś fali pojawi się problem, tę grupę konsumentów kieruje się z powrotem na stary klaster, nie ruszając niczego, co już zostało pomyślnie przeniesione. To działa tylko wtedy, gdy ścieżka wycofania została zaprojektowana od początku; bardzo trudno dobudować ją w połowie przełączenia.
Jeśli czynności wycofania dla danego kroku nie da się opisać jednym zdaniem, ten krok nie jest gotowy do wykonania.
Jeśli aktualizacja jest zarazem momentem przejścia na wspieraną kompilację, strona o komercyjnych licencjach RabbitMQ wyjaśnia, co obejmuje subskrypcja komercyjna i jak jest wyceniana.
Jak zweryfikować obciążenie i pojemność przed przełączeniem?
Testy obciążeniowe przed migracją trzeba budować na podstawie rzeczywistego ruchu, a nie syntetycznego benchmarku. Historyczne dane o głębokości kolejek i tempie komunikatów warto pobrać z tego, co już Państwo mają — Prometheus, Grafana, Dynatrace albo API zarządzania samego brokera — aby jeszcze przed zaprojektowaniem testu zbudować realistyczny profil szczytowej przepustowości, wzorców skoków ruchu i rozkładu rozmiarów komunikatów.
Warto przetestować dwie rzeczy, które zespoły często pomijają. Po pierwsze, testować przy rzeczywistym szczycie, a nie przy średnim obciążeniu — platforma płatnicza, z którą pracowaliśmy, określała zakres podejścia do replikacji, które musiało utrzymać mniej więcej 2000 komunikatów na sekundę w sposób ciągły, a rzetelna odpowiedź na pytanie, czy federacja to wytrzyma przy ograniczeniach sieciowych, wymagała prawdziwych testów obciążeniowych, a nie szacunków. Po drugie, testować odrabianie zaległości, a nie tylko przepustowość w stanie ustalonym. Klaster, który dobrze radzi sobie ze zwykłym ruchem, może mieć kłopoty, gdy musi jednocześnie przetwarzać zaległości i bieżący ruch — a to dokładnie scenariusz, w którym stawia Państwa nieudane przełączenie albo powrót po przełączeniu awaryjnym DR (failback).
Jeśli architektura docelowa zmienia typ kolejek, dodaje przeskok replikacji albo przenosi się na inną infrastrukturę bazową, zapas pojemności, który istniał w starym systemie, nie przenosi się automatycznie. Trzeba go zweryfikować przed datą uruchomienia, a nie w jej trakcie.
Które zależności od pluginów i bibliotek klienckich są najczęściej pomijane?
Poza podstawową inwentaryzacją kilka problemów z zależnościami pojawia się nieproporcjonalnie często, gdy zespoły są już w połowie migracji:
- Rozjazd wersji pluginów federation i Shovel. Te pluginy są dostarczane niezależnie od rdzenia brokera i trzeba je ponownie zweryfikować z wersją docelową — nie należy zakładać, że zgodność przechodzi automatycznie.
- Zgodność z Erlang/OTP powiązana z licencjami. Społecznościowy RabbitMQ z bieżącej stabilnej serii z czasem przestaje otrzymywać poprawki dla starszych środowisk uruchomieniowych Erlanga, a przejście na nowszą wersję główną Erlanga bywa, w zależności od serii RabbitMQ, uzależnione od licencji komercyjnej. Wychodzi to podczas planowania migracji znacznie częściej, niż zespoły się spodziewają, i potrafi zamienić prostą techniczną aktualizację w rozmowę z działem zakupów z przypiętym terminem.
- Domyślne ustawienia połączeń i limitów czasu po stronie klienta dostrojone do starego środowiska. Ustawienia heartbeatów i limitów czasu TCP dostrojone do lokalnej sieci o niskich opóźnieniach powodują fałszywe rozłączenia, gdy migracja przenosi ruch między strefami dostępności albo przez bramę NAT — tę zmianę warto wychwycić przed przełączeniem, a nie debugować później jako tajemniczy incydent.
- Aplikacje wciąż korzystające ze starych bibliotek klienckich lub środowisk uruchomieniowych. Często mają zachowawcze ustawienia domyślne — na przykład ustawienia pamięci JVM znacznie poniżej tego, co faktycznie ma do dyspozycji kontener — które po cichu ograniczają przepustowość i wychodzą na jaw dopiero wtedy, gdy podczas testów migracyjnych próbuje się osiągnąć konkretny cel wydajnościowy.
Ile trwa ocena gotowości i co otrzymują Państwo na końcu?
Harmonogram zależy od zakresu. Aktualizacja wersji pojedynczego klastra z niewielką liczbą aplikacji konsumujących to zwykle tydzień pracy. Wdrożenie wieloregionowe z federacją, niestandardowymi pluginami i dziesiątkami aplikacji konsumujących wymaga więcej czasu na rzetelną inwentaryzację, ocenę ryzyka i testy obciążeniowe — zwykle dwóch do trzech tygodni.
W obu przypadkach powinni Państwo otrzymać:
- Pełną inwentaryzację topologii, pluginów i bibliotek klienckich — jedno źródło prawdy, na którym opiera się plan migracji
- Rejestr ryzyk opisujący konkretne warunki awarii i ich wpływ na dalsze systemy, a nie ogólnikową listę według ważności
- Plan wycofania ze zdefiniowanym wyzwalaczem i czynnością odwracającą dla każdego kroku migracji
- Wyniki testów obciążeniowych konfiguracji docelowej, w tym scenariuszy odrabiania zaległości
- Rekomendację go/no-go z problemami blokującymi uszeregowanymi według priorytetu przed datą przełączenia
- Kryteria weryfikacji po migracji i krótką rundę optymalizacji, gdy klaster docelowy obsługuje już rzeczywisty ruch
Koszt takiego zlecenia warto zestawić z całkowitym kosztem posiadania w razie jego pominięcia — nieplanowane wycofanie pod obciążeniem produkcyjnym niemal zawsze kosztuje więcej niż sama ocena. Jeśli planują Państwo aktualizację wersji, przeniesienie na inną platformę lub zmianę architektury i chcą przejść przez ustrukturyzowaną bramkę gotowości, zanim zobowiążą się do daty przełączenia, nasz zespół RabbitMQ przeprowadza takie oceny równolegle z samymi migracjami. Porozmawiajmy o zakresie oceny dopasowanym do Państwa harmonogramu.
Ta lista kontrolna to drugi z siedmiu kroków przewodnika po migracji RabbitMQ, który porządkuje kolejno decyzję, inwentaryzację, mapowanie semantyki, budowę środowiska docelowego, przełączenie i weryfikację.
FAQ
Czym jest ocena gotowości do migracji RabbitMQ?
To jednorazowy przegląd przeprowadzany przed aktualizacją do nowej wersji głównej, przeniesieniem na inną platformę lub zmianą architektury. Obejmuje inwentaryzację obecnej topologii i zależności, wskazuje, co się zepsuje, jeśli migracja pójdzie źle, daje przetestowany plan wycofania i potwierdza, że środowisko docelowe udźwignie rzeczywiste obciążenie produkcyjne — a kończy się rekomendacją go/no-go.
Czym ocena gotowości do migracji różni się od ogólnego health checku RabbitMQ?
Health check to okresowa migawka kondycji operacyjnej — wymiarowania klastra, podstawowego poziomu bezpieczeństwa, dryfu konfiguracji — wykonywana niezależnie od planowanych zmian. Ocena gotowości do migracji dotyczy jednego konkretnego przełączenia, ma sztywny termin i daje rezultaty, których health check nie daje: plan wycofania, rejestr ryzyk przełączenia i testy obciążeniowe stanu docelowego, a nie tylko obecnego.
Co powinna obejmować inwentaryzacja stanu obecnego?
Każdą kolejkę, exchange i powiązanie (binding) wraz z informacją, czy ta topologia jest zdefiniowana w automatyzacji, czy istnieje wyłącznie jako ręczna, nieudokumentowana konfiguracja; każdy używany plugin, w tym federation, Shovel oraz wszelkie pluginy niestandardowe lub pisane we własnym zakresie; a także wersję biblioteki klienckiej i środowiska uruchomieniowego w każdej aplikacji, która publikuje lub konsumuje komunikaty — nie tylko wersję brokera.
Co tak naprawdę powinien zawierać plan wycofania?
Zdefiniowany wyzwalacz — konkretną metrykę lub warunek awarii, który oznacza przerwanie migracji — oraz opis odwracalności każdego kroku, a nie ogólnikowe „przywrócimy z kopii zapasowej”. W praktyce zwykle oznacza to równoległe uruchomienie starego i nowego środowiska oraz przenoszenie grup konsumentów falami, tak aby każdą falę można było skierować z powrotem bez ruszania tych, które już przeszły pomyślnie.
Czy testy obciążeniowe są potrzebne, jeśli nie zmieniamy sprzętu?
Tak. Aktualizacja wersji lub zmiana topologii (na przykład przejście z klasycznych kolejek mirrorowanych na kolejki kworum albo dodanie ścieżki replikacji na potrzeby disaster recovery) zmienia zachowanie brokera pod obciążeniem nawet na identycznym sprzęcie. Warto testować przy rzeczywistej szczytowej przepustowości i w scenariuszach odrabiania zaległości, a nie tylko przy ruchu w stanie ustalonym.
Ile trwa ocena gotowości do migracji RabbitMQ?
Zwykle od jednego do trzech tygodni, w zależności od liczby klastrów i złożoności topologii. Aktualizację pojedynczego klastra z kilkoma aplikacjami konsumującymi można ocenić w około tydzień; wdrożenie wieloregionowe z federacją, niestandardowymi pluginami i dziesiątkami aplikacji konsumujących wymaga więcej czasu na rzetelną inwentaryzację i testy obciążeniowe.
Co zwykle sprawia, że taka ocena staje się potrzebna?
Aktualizacja do nowej wersji głównej (zwłaszcza zmieniająca domyślny typ kolejek lub zgodność z Erlangiem), przeniesienie na inną platformę, na przykład na Kubernetes lub do nowego centrum danych, zmiana architektury, taka jak dodanie replikacji na potrzeby disaster recovery, albo zmiana licencyjna wymuszająca przeskok wersji w określonym terminie.

Autor
Talk to an engineer
Need a hand with RabbitMQ?
Senior engineers who run it in production. Get a quote or a free consultation, no sales pitch.
Poradniki, porównania i analizy


