
On this page
Uma avaliação de prontidão para migração do RabbitMQ é um portão pontual pelo qual você passa antes de um upgrade major, de uma mudança de plataforma ou de uma mudança de arquitetura, e não um health check contínuo. Ela confirma que a sua topologia e as suas dependências estão totalmente inventariadas, que você sabe o que quebra se uma etapa falhar, que existe um rollback testado e que o ambiente de destino consegue absorver a carga real de produção.
A maioria das equipes que se queimam em uma migração de RabbitMQ não tinha um cluster quebrado antes. Elas tinham um ambiente estável, um plano razoável e uma data de go-live, e descobriram no meio do cutover que a topologia de uma fila só existia na cabeça de um engenheiro, ou que um consumidor downstream ainda usava uma biblioteca cliente de três versões major atrás, ou que o plano de rollback era “restaurar do backup” sem nenhuma ideia de quanto tempo isso levaria de fato sob carga.
É isso que uma avaliação estruturada de prontidão antes da migração existe para detectar, antes de a janela de manutenção começar, e não durante ela.
O que é uma avaliação de prontidão para migração do RabbitMQ?
É uma revisão de escopo fechado, ligada a uma única mudança planejada: um upgrade de versão, uma mudança para uma nova infraestrutura (Kubernetes, um novo data center, uma nova região de nuvem) ou uma mudança de arquitetura, como adicionar replicação federada para recuperação de desastres. Não é uma assinatura e não é uma ferramenta de monitoramento.
O resultado é um roadmap de migração e um relatório de prontidão com uma recomendação clara: seguir, seguir depois de correções específicas ou ainda não, cobrindo todas as cargas de trabalho que a migração toca, e não só o broker. É uma entrega diferente de um health check geral, e vale a pena ser preciso sobre a diferença antes de definir o escopo de uma.
Qual é a diferença entre uma avaliação de prontidão para migração e um health check geral do RabbitMQ?
As duas se sobrepõem no método (ambas examinam a configuração do cluster, a topologia das filas e a situação das versões), mas respondem a perguntas diferentes. Um health check de RabbitMQ pergunta: “esta implantação está saudável agora, e o que deveríamos corrigir de modo geral?”. Ele é feito periodicamente, independentemente de qualquer mudança planejada, e as suas conclusões (classic mirrored queues, usuários com permissões demais, heartbeat mal configurado) valem esteja você migrando algo ou não.
Uma avaliação de prontidão para migração faz uma pergunta mais estreita e de maior risco: “conseguimos executar este cutover específico, nesta data, sem indisponibilidade nem perda de dados; e, se não, o que precisa mudar primeiro?”. Esse enquadramento muda as entregas. Uma avaliação de prontidão produz um plano de rollback com o escopo exato das etapas da migração, um registro de riscos com o que quebra e em que condição, e testes de carga executados contra a configuração de destino, e não só um retrato da saúde atual. Se você não está planejando um cutover específico, o que você quer é o health check. Se há um upgrade ou uma mudança de plataforma no calendário, você quer esta avaliação.
O que um inventário antes da migração realmente precisa registrar?
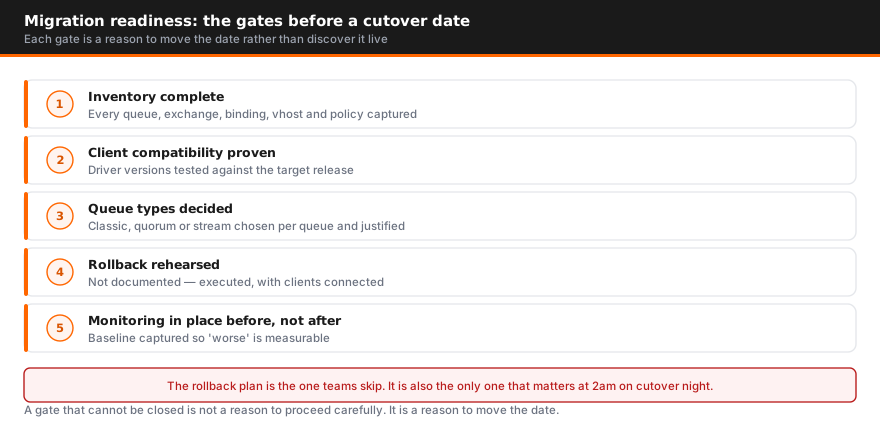
O inventário é a parte cujo escopo as equipes mais subestimam, de forma consistente, porque a maior parte dele fica fora da configuração do próprio broker. Quatro coisas precisam ser registradas antes que você possa planejar uma migração com alguma segurança:
- A topologia de filas, exchanges e bindings, e se ela está definida em automação. Trabalhamos recentemente com uma empresa de processamento de pagamentos cuja instalação do cluster era totalmente automatizada, mas cujas filas, exchanges e links de federation eram criados manualmente e não existiam em lugar nenhum no código. É uma lacuna comum, e significa que a topologia não pode ser reconstruída com confiança em um novo cluster sem que alguém a reconstitua manualmente a partir do sistema em execução.
- Dependências de plugins. Federation, shovel e quaisquer plugins personalizados ou de fornecedores precisam ser verificados um a um contra a versão de destino do RabbitMQ: um plugin compatível com a sua versão atual não é automaticamente compatível com aquela para a qual você está migrando.
- Versões da biblioteca cliente e do runtime em cada aplicação consumidora. Não a versão do broker, e sim a do cliente. Aplicações com bibliotecas cliente antigas ou runtimes desatualizados muitas vezes carregam configurações de conexão, threading ou memória mal ajustadas que só aparecem como problema quando os padrões de tráfego ou o comportamento do broker mudam durante uma migração.
- Compatibilidade de tipos de fila e de versões. As classic mirrored queues são território descontinuado nas versões major mais novas do RabbitMQ, e o suporte às versões do Erlang/OTP está atrelado à sua versão do RabbitMQ: a edição community da 3.13.x, por exemplo, não suporta o runtime Erlang 27, o que força uma conversa sobre licenciamento para qualquer equipe que queira se manter atualizada sem um upgrade completo.
Nada disso é exótico. Só é tedioso o bastante para que equipes com prazo apertado pulem essa etapa e depois a redescubram ao vivo, durante a migração.
Como avaliar o risco antes de uma migração do RabbitMQ: o que realmente quebra?
Avaliar o risco de uma migração significa percorrer condições de falha específicas, e não produzir uma lista genérica ordenada por severidade. A versão útil desse exercício responde: para cada etapa da migração, o que quebra se ela falhar, e como essa falha aparece mais adiante?
Um exemplo concreto, de um projeto de replicação para recuperação de desastres cujo escopo definimos com um cliente de processamento de pagamentos: a abordagem proposta usava federated exchanges para replicar mensagens para um site secundário. Federated exchanges replicam mensagens, e não o estado do broker; então, se o lado de DR cai, as mensagens replicadas se acumulam localmente em vez de se perderem, mas um exercício de DR de verdade pode significar recuperar um backlog na casa das centenas de milhares de mensagens quando o link se reconecta. Esse tráfego de recuperação cai direto no cluster de produção e precisa ser levado em conta, ou vira um incidente por si só.
É esse o formato de uma avaliação de risco de verdade: garantias de ordenação das mensagens, premissas de idempotência do lado do consumidor, se uma reconexão depois de uma indisponibilidade dispara um backlog grande o bastante para afetar o throughput de produção e se as aplicações cliente realmente tratam a reentrega corretamente, em vez de simplesmente presumir um comportamento exactly-once que nunca lhes foi garantido. Cada um desses pontos é específico da sua arquitetura e das suas aplicações: um checklist padrão não vai revelá-los, mas percorrer a migração etapa por etapa vai.
O que um plano de rollback precisa incluir?
“Restaurar do backup” não é um plano de rollback para um sistema de mensageria em produção: isso não diz quanto tempo a recuperação leva, quais mensagens se perdem no intervalo nem como os consumidores downstream se comportam enquanto isso acontece. Um plano de rollback de verdade define, para cada etapa da migração, a condição de gatilho específica que significa abortar e a ação de reversão específica daquela etapa.
Na prática, o padrão que funciona é rodar o ambiente atual e o de destino em paralelo, em vez de migrar no lugar. Suba o novo cluster ao lado do antigo, mova as aplicações consumidoras em ondas e mantenha o cluster antigo ativo e recebendo tráfego até que as ondas migradas provem que estão estáveis, muitas vezes ao longo de um ciclo inteiro de pico de tráfego. Se uma onda apresentar um problema, você roteia aquele grupo de consumidores de volta para o cluster antigo sem mexer em nada que já migrou com sucesso. Isso só funciona se o caminho de rollback tiver sido projetado desde o início; é muito difícil adaptá-lo depois que você já está no meio do cutover.
Se você não consegue descrever em uma frase a ação de rollback de uma determinada etapa, essa etapa não está pronta para ser executada.
Se o upgrade também for o momento de passar para uma build com suporte, a página de licenciamento comercial do RabbitMQ explica o que uma assinatura comercial inclui e como ela é precificada.
Como validar a carga e a capacidade antes do cutover?
O teste de carga antes de uma migração precisa ser construído a partir do seu tráfego real, e não de um benchmark sintético. Extraia os dados históricos de profundidade das filas e de taxa de mensagens de onde você já os tiver (Prometheus, Grafana, Dynatrace ou a própria API de gerenciamento do broker) para montar um perfil realista do pico de throughput, dos padrões de rajada e da distribuição de tamanho das mensagens antes de desenhar o teste.
Há duas coisas que vale a pena testar e que as equipes muitas vezes pulam. Primeiro, teste no seu pico real, e não na carga média: uma plataforma de pagamentos com a qual trabalhamos estava definindo uma abordagem de replicação que precisava sustentar cerca de 2.000 mensagens por segundo de forma contínua, e a resposta honesta sobre se a federation aguentaria isso com as restrições de rede exigiu um teste de carga real, e não uma estimativa. Segundo, teste a recuperação de backlog, e não só o throughput em regime estável. Um cluster que lida bem com o tráfego normal ainda pode sofrer quando precisa processar ao mesmo tempo um backlog de recuperação e o tráfego ao vivo, que é exatamente o cenário em que um cutover que falhou ou um failback de DR coloca você.
Se a sua arquitetura de destino muda o tipo de fila, acrescenta um salto de replicação ou passa para outra infraestrutura por baixo, a folga de capacidade que existia no sistema antigo não se transfere automaticamente. Valide-a antes da data de go-live, e não durante.
Quais dependências de plugins e de bibliotecas cliente são esquecidas com mais frequência?
Além do inventário básico, alguns problemas de dependência aparecem com frequência desproporcional quando as equipes já estão no meio da migração:
- Desalinhamento de versões dos plugins de federation e shovel. Esses plugins são distribuídos independentemente do broker principal e precisam ser verificados de novo contra a versão de destino; não presuma que a compatibilidade se mantém.
- Compatibilidade do Erlang/OTP atrelada ao licenciamento. O RabbitMQ community na série stable atual deixa de receber patches para runtimes Erlang mais antigos com o tempo, e passar para uma versão major mais nova do Erlang às vezes depende de uma licença comercial, conforme a sua série do RabbitMQ. Isso aparece no planejamento da migração com muito mais frequência do que as equipes esperam, e pode transformar um upgrade técnico simples em uma negociação de compras com prazo.
- Padrões de conexão e de timeout do lado do cliente ajustados para o ambiente antigo. Configurações de heartbeat e de timeout TCP ajustadas para uma rede on-premises de baixa latência causam desconexões falso-positivas quando uma migração passa o tráfego por várias availability zones ou por um NAT gateway, uma mudança que vale detectar antes do cutover, em vez de depurá-la depois como um incidente misterioso.
- Aplicações ainda rodando bibliotecas cliente ou runtimes antigos. Elas muitas vezes carregam padrões conservadores (por exemplo, configurações de memória da JVM dimensionadas muito abaixo do que um contêiner realmente tem disponível) que limitam o throughput sem alarde e só ficam visíveis quando você tenta atingir uma meta de desempenho específica nos testes da migração.
Quanto tempo leva uma avaliação de prontidão, e o que você recebe no final?
O escopo define o prazo. O upgrade de versão de um único cluster com poucas aplicações consumidoras costuma ser um projeto de uma semana. Uma implantação multirregião com federation, plugins personalizados e dezenas de aplicações consumidoras leva mais tempo para ser inventariada, ter os riscos avaliados e ser testada sob carga da forma certa, geralmente de duas a três semanas.
De um jeito ou de outro, você deve sair com:
- Um inventário completo da topologia, dos plugins e das bibliotecas cliente: a fonte da verdade sobre a qual o plano de migração é construído
- Um registro de riscos que descreve condições de falha específicas e o seu impacto mais adiante, e não uma lista genérica de severidades
- Um plano de rollback com um gatilho definido e uma ação de reversão para cada etapa da migração
- Resultados dos testes de carga contra a configuração de destino, incluindo cenários de recuperação de backlog
- Uma recomendação de go/no-go, com os problemas bloqueantes priorizados antes da data de cutover
- Critérios de validação pós-migração e uma rodada curta de otimização assim que o cluster de destino estiver recebendo tráfego real
Compare o custo desse projeto com o custo total de pular essa etapa: um rollback não planejado sob carga de produção quase sempre sai mais caro do que a própria avaliação. Se você está planejando um upgrade de versão, uma mudança de plataforma ou uma mudança de arquitetura e quer um portão de prontidão estruturado antes de se comprometer com uma data de cutover, a nossa equipe de RabbitMQ faz essas avaliações junto com as próprias migrações. Fale conosco para definir o escopo de uma de acordo com o seu cronograma.
O checklist é a etapa dois de sete do guia de migração do RabbitMQ, que encadeia a decisão, o inventário, o mapeamento semântico, a build de destino, o cutover e a validação.
Perguntas frequentes
O que é uma avaliação de prontidão para migração do RabbitMQ?
Uma revisão pontual feita antes de um upgrade de versão major, de uma mudança de plataforma ou de uma mudança de arquitetura. Ela inventaria a topologia e as dependências atuais, identifica o que quebra se a migração der errado, produz um plano de rollback testado e valida que o ambiente de destino aguenta a carga real de produção, terminando com uma recomendação de go/no-go.
Qual é a diferença entre uma avaliação de prontidão para migração e um health check geral do RabbitMQ?
Um health check é um retrato periódico da saúde operacional (dimensionamento do cluster, baseline de segurança, desvios de configuração), feito independentemente de qualquer mudança planejada. Uma avaliação de prontidão para migração tem como escopo um cutover específico, tem um prazo rígido e produz artefatos que um health check não produz: um plano de rollback, um registro de riscos do cutover e testes de carga contra o estado de destino, e não só o atual.
O que o inventário do estado atual precisa cobrir?
Cada fila, exchange e binding, e se essa topologia está definida em automação ou existe apenas como configuração manual e não documentada; cada plugin em uso, inclusive federation, shovel e quaisquer plugins personalizados ou desenvolvidos internamente; e a versão da biblioteca cliente e do runtime em cada aplicação que publica ou consome, e não só a versão do broker.
O que um plano de rollback realmente precisa incluir?
Um gatilho definido (a métrica ou a condição de falha específica que significa abortar) e uma declaração de reversibilidade para cada etapa, e não um genérico “restaurar do backup”. Na prática, isso geralmente significa rodar o ambiente antigo e o novo em paralelo e migrar os grupos de consumidores em ondas, para que qualquer onda possa ser roteada de volta sem mexer nas que já deram certo.
Ainda precisamos de teste de carga se não vamos trocar o hardware?
Sim. Um upgrade de versão ou uma mudança de topologia (por exemplo, passar de classic mirrored queues para filas de quórum (quorum queues), ou adicionar um caminho de replicação para recuperação de desastres) muda o comportamento do broker sob carga mesmo em hardware idêntico. Teste contra o seu pico real de throughput e contra cenários de recuperação de backlog, e não só contra o tráfego em regime estável.
Quanto tempo leva uma avaliação de prontidão para migração do RabbitMQ?
Normalmente de uma a três semanas, dependendo do número de clusters e da complexidade da topologia. O upgrade de um único cluster com poucas aplicações consumidoras pode ter o escopo fechado em cerca de uma semana; uma implantação multirregião com federation, plugins personalizados e dezenas de aplicações consumidoras leva mais tempo para ser inventariada e testada sob carga da forma certa.
O que costuma gerar a necessidade de uma avaliação dessas?
Um upgrade de versão major (principalmente um que mude os padrões de tipo de fila ou a compatibilidade com o Erlang), uma mudança de plataforma, como ir para o Kubernetes ou para um novo data center, uma mudança de arquitetura, como adicionar replicação para recuperação de desastres, ou uma mudança de licenciamento que force um salto de versão com prazo.

Autor
Talk to an engineer
Need a hand with RabbitMQ?
Senior engineers who run it in production. Get a quote or a free consultation, no sales pitch.
Guias, comparativos e pesquisas


