
On this page
Uma avaliação de preparação para a migração de RabbitMQ é um ponto de controlo pontual que se executa antes de uma atualização major, de uma mudança de plataforma ou de uma alteração de arquitetura — e não um health check contínuo. Confirma que a topologia e as dependências estão totalmente inventariadas, que sabe o que falha se um passo correr mal, que tem um rollback testado e que o ambiente de destino consegue absorver a carga real de produção.
A maioria das equipas que se queimam numa migração de RabbitMQ não tinha um cluster avariado antes. Tinha um ambiente estável, um plano razoável e uma data de entrada em produção — e descobriu a meio da transição que a topologia de uma fila só existia na cabeça de um engenheiro, ou que um consumidor a jusante ainda usava uma biblioteca cliente com três versões major de atraso, ou que o plano de rollback era «restaurar a partir do backup», sem qualquer ideia de quanto tempo isso demoraria de facto sob carga.
É isto que uma avaliação estruturada de preparação pré-migração foi pensada para detetar, antes de começar a janela de manutenção e não durante.
O que é uma avaliação de preparação para a migração de RabbitMQ?
É uma revisão de âmbito fechado associada a uma alteração planeada específica: uma atualização de versão, uma mudança para nova infraestrutura (Kubernetes, um novo centro de dados, uma nova região cloud) ou uma alteração de arquitetura, como acrescentar replicação federada para recuperação de desastres. Não é uma subscrição nem uma ferramenta de monitorização.
O resultado é um roteiro de migração e um relatório de preparação com uma recomendação clara: avançar, avançar depois de correções específicas, ou ainda não — abrangendo todas as cargas de trabalho que a migração toca, e não apenas o broker. É um entregável diferente de um health check geral, e vale a pena ser preciso quanto a essa diferença antes de definir o âmbito.
Em que difere uma avaliação de preparação para a migração de um health check geral de RabbitMQ?
Coincidem no método — ambos examinam a configuração do cluster, a topologia das filas e o estado das versões — mas respondem a perguntas diferentes. Um health check de RabbitMQ pergunta: «esta implementação está saudável neste momento e o que devemos corrigir em geral?» É feito periodicamente, independentemente de qualquer alteração planeada, e as suas conclusões — classic mirrored queues, utilizadores com permissões a mais, heartbeats mal configurados — aplicam-se quer esteja a migrar alguma coisa, quer não.
Uma avaliação de preparação para a migração faz uma pergunta mais restrita e com mais em jogo: «conseguimos executar esta transição concreta, nesta data, sem indisponibilidade nem perda de dados — e, se não, o que tem de mudar primeiro?» Este enquadramento muda os entregáveis. Uma avaliação de preparação produz um plano de rollback circunscrito aos passos exatos da migração, um registo de riscos com o que falha e em que condições, e testes de carga executados sobre a configuração de destino — e não apenas uma fotografia da saúde atual. Se não está a planear uma transição concreta, o que quer é o health check. Se tem uma atualização ou uma mudança de plataforma no calendário, é isto que quer.
O que deve, na prática, captar um inventário pré-migração?
O inventário é a parte cujo âmbito as equipas mais subestimam, porque a maior parte dele vive fora da configuração do próprio broker. Há quatro coisas a captar antes de poder planear uma migração com alguma confiança:
- Topologia de filas, exchanges e bindings — e se está definida em automação. Trabalhámos recentemente com uma empresa de processamento de pagamentos cuja instalação do cluster estava totalmente automatizada, mas cujas filas, exchanges e ligações de Federation tinham sido criadas manualmente e não existiam em lado nenhum no código. É uma lacuna comum, e significa que a topologia não pode ser reconstruída de forma fiável num novo cluster sem que alguém a reconstitua manualmente a partir do sistema em execução.
- Dependências de plugins. Federation, Shovel e quaisquer plugins personalizados ou de terceiros têm de ser verificados um a um face à versão de destino do RabbitMQ — um plugin compatível com a sua versão atual não é automaticamente compatível com aquela para a qual está a migrar.
- Versões das bibliotecas cliente e dos runtimes em cada aplicação consumidora. Não a versão do broker — a do cliente. As aplicações com bibliotecas cliente antigas ou runtimes desatualizados trazem muitas vezes definições de ligação, threading ou memória mal afinadas, que só se revelam um problema quando os padrões de tráfego ou o comportamento do broker mudam durante uma migração.
- Compatibilidade dos tipos de fila e das versões. As classic mirrored queues são território descontinuado nas versões major mais recentes do RabbitMQ, e o suporte de versões do Erlang/OTP está ligado à sua versão do RabbitMQ — a edição community da 3.13.x, por exemplo, não suporta o runtime Erlang 27, o que obriga a uma conversa sobre licenciamento para qualquer equipa que queira manter-se atualizada sem uma atualização completa.
Nada disto é exótico. É apenas suficientemente fastidioso para que as equipas com prazos apertados o saltem — e depois o redescubram em direto durante a migração.
Como avaliar o risco antes de uma migração de RabbitMQ — o que falha realmente?
Avaliar o risco de uma migração significa analisar condições de falha concretas, e não produzir uma lista genérica ordenada por severidade. A versão útil deste exercício responde a isto: para cada passo da migração, o que falha se esse passo correr mal, e como se manifesta essa falha a jusante?
Um exemplo concreto de um projeto de replicação para recuperação de desastres que delimitámos com um cliente de processamento de pagamentos: a abordagem proposta usava exchanges federadas para replicar mensagens para um site secundário. As exchanges federadas replicam mensagens, e não o estado do broker — por isso, se o lado de DR cair, as mensagens replicadas acumulam-se localmente em vez de se perderem, mas um verdadeiro exercício de DR pode significar recuperar um backlog de centenas de milhares de mensagens quando a ligação for restabelecida. Esse tráfego de recuperação cai diretamente no cluster de produção e tem de ser contabilizado, ou torna-se ele próprio um incidente.
É esta a forma de uma avaliação de riscos a sério: garantias de ordenação das mensagens, pressupostos de idempotência do lado do consumidor, se uma reconexão após uma indisponibilidade desencadeia um backlog grande o suficiente para afetar o débito de produção e se as aplicações cliente tratam corretamente a reentrega em vez de presumirem um comportamento exactly-once que nunca lhes foi garantido. Cada um destes pontos é específico da sua arquitetura e das suas aplicações — uma checklist modelo não os vai revelar, mas analisar a migração passo a passo vai.
O que deve incluir um plano de rollback?
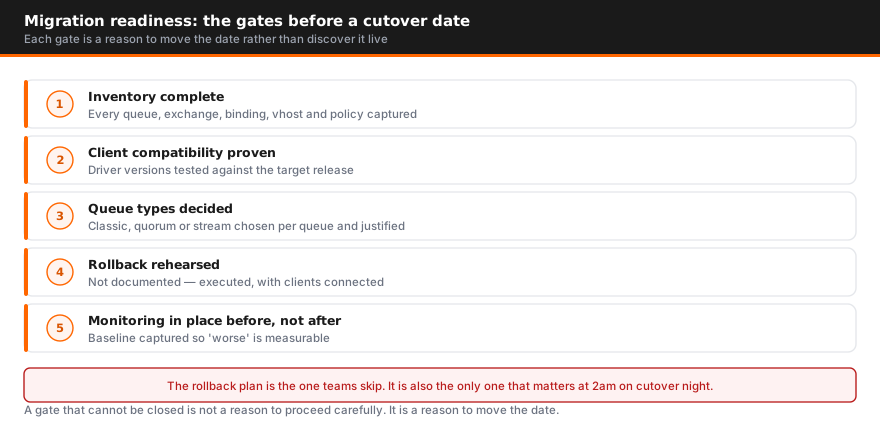
«Restaurar a partir do backup» não é um plano de rollback para um sistema de mensagens em produção — não diz quanto tempo demora a recuperação, que mensagens se perdem pelo meio nem como se comportam os consumidores a jusante enquanto isso acontece. Um plano de rollback a sério define, para cada passo da migração, a condição de gatilho concreta que determina o abortar e a ação de reversão concreta para esse passo.
Na prática, o padrão que funciona é executar os ambientes atual e de destino em paralelo, em vez de migrar no próprio local. Levante o novo cluster ao lado do antigo, passe as aplicações consumidoras por vagas e mantenha o cluster antigo ativo e a receber tráfego até as vagas migradas provarem ser estáveis — muitas vezes ao longo de um ciclo completo de tráfego de pico. Se uma vaga revelar um problema, reencaminha esse grupo de consumidores de volta para o cluster antigo sem mexer em nada do que já migrou com sucesso. Isto só funciona se o caminho de rollback tiver sido previsto desde o início; é muito difícil acrescentá-lo a meio de uma transição.
Se não consegue descrever numa frase a ação de rollback de um determinado passo, esse passo não está pronto para ser executado.
Se a atualização for também o momento em que passa para uma build com suporte, a página de licenciamento comercial do RabbitMQ explica o que inclui uma subscrição comercial e como é definido o seu preço.
Como validar a carga e a capacidade antes da transição?
Os testes de carga antes de uma migração têm de ser construídos a partir do seu tráfego real, e não de um benchmark sintético. Recolha dados históricos de profundidade das filas e de taxa de mensagens daquilo que já tem — Prometheus, Grafana, Dynatrace ou a API de gestão do próprio broker — para construir um perfil realista do débito de pico, dos padrões de picos súbitos e da distribuição de tamanhos das mensagens antes de desenhar o teste.
Há duas coisas que vale a pena testar e que as equipas costumam saltar. Primeiro, teste no seu pico real, e não na carga média — uma plataforma de pagamentos com que trabalhámos estava a delimitar uma abordagem de replicação que tinha de sustentar cerca de 2.000 mensagens por segundo de forma contínua, e a resposta honesta sobre se a Federation aguentaria isso com as restrições de rede exigiu testes de carga reais, e não uma estimativa. Segundo, teste a recuperação de um backlog, e não apenas o débito em regime estável. Um cluster que lida bem com o tráfego normal pode ainda assim ter dificuldades quando tem de processar ao mesmo tempo um backlog de recuperação e o tráfego em direto — que é exatamente o cenário em que uma transição falhada ou um failback de DR o coloca.
Se a arquitetura de destino muda o tipo de fila, acrescenta um salto de replicação ou passa para uma infraestrutura subjacente diferente, a margem de capacidade que existia no sistema antigo não passa automaticamente para o novo. Valide-a antes da data de entrada em produção, e não durante.
Que dependências de plugins e de bibliotecas cliente são esquecidas com mais frequência?
Para além do inventário de base, há alguns problemas de dependências que surgem com uma frequência desproporcionada quando as equipas já estão a meio da migração:
- Desfasamento de versões dos plugins Federation e Shovel. Estes plugins são distribuídos independentemente do broker principal e têm de ser novamente verificados face à versão de destino — não presuma que a compatibilidade se mantém.
- Compatibilidade do Erlang/OTP ligada ao licenciamento. O RabbitMQ community da série estável atual deixa, com o tempo, de receber patches para runtimes Erlang mais antigos, e a passagem para uma versão major mais recente do Erlang fica por vezes dependente de uma licença comercial, consoante a sua série do RabbitMQ. Isto surge no planeamento das migrações muito mais vezes do que as equipas esperam, e pode transformar uma atualização técnica simples numa conversa de procurement com prazo.
- Predefinições de ligação e de timeout do lado do cliente afinadas para o ambiente antigo. Definições de heartbeat e de timeout TCP afinadas para redes on-premises de baixa latência provocam desconexões falsas quando uma migração passa o tráfego entre zonas de disponibilidade ou através de um gateway NAT — uma alteração que vale a pena detetar antes da transição, em vez de a depurar depois como um incidente misterioso.
- Aplicações que ainda usam bibliotecas cliente ou runtimes antigos. Trazem muitas vezes predefinições conservadoras — por exemplo, definições de memória da JVM muito abaixo do que o contentor tem de facto disponível — que limitam discretamente o débito e só se tornam visíveis quando se tenta atingir um objetivo de desempenho concreto durante os testes da migração.
Quanto tempo demora uma avaliação de preparação e o que se obtém no final?
O âmbito determina o prazo. A atualização de versão de um único cluster com poucas aplicações consumidoras é normalmente um projeto de uma semana. Uma implementação multirregião com Federation, plugins personalizados e dezenas de aplicações consumidoras demora mais a inventariar, a avaliar quanto ao risco e a testar devidamente sob carga — normalmente duas a três semanas.
Em qualquer dos casos, deve sair com:
- Um inventário completo da topologia, dos plugins e das bibliotecas cliente — a fonte de verdade a partir da qual se constrói o plano de migração
- Um registo de riscos que descreve condições de falha concretas e o seu impacto a jusante, e não uma lista genérica de severidades
- Um plano de rollback com um gatilho definido e uma ação de reversão para cada passo da migração
- Resultados dos testes de carga sobre a configuração de destino, incluindo cenários de recuperação de backlog
- Uma recomendação de avançar ou não avançar (go/no-go), com os problemas bloqueantes priorizados antes da data de transição
- Critérios de validação pós-migração e uma breve ronda de otimização assim que o cluster de destino estiver a transportar tráfego real
Compare o custo deste projeto com o custo total de propriedade de o dispensar — um rollback não planeado sob carga de produção é quase sempre mais caro do que a própria avaliação. Se está a planear uma atualização de versão, uma mudança de plataforma ou uma alteração de arquitetura e quer um ponto de controlo estruturado antes de se comprometer com uma data de transição, a nossa equipa de RabbitMQ realiza estas avaliações a par das próprias migrações. Fale connosco para definir o âmbito de uma em função do seu calendário.
A checklist é o segundo de sete passos do guia de migração de RabbitMQ, que encadeia a decisão, o inventário, o mapeamento semântico, a build de destino, a transição e a validação.
Perguntas frequentes
O que é uma avaliação de preparação para a migração de RabbitMQ?
Uma revisão pontual realizada antes de uma atualização de versão major, de uma mudança de plataforma ou de uma alteração de arquitetura. Faz o inventário da topologia e das dependências atuais, identifica o que falha se a migração correr mal, produz um plano de rollback testado e valida que o ambiente de destino aguenta a carga real de produção — e termina com uma recomendação de avançar ou não avançar (go/no-go).
Em que difere uma avaliação de preparação para a migração de um health check geral de RabbitMQ?
Um health check é uma fotografia periódica da saúde operacional — dimensionamento do cluster, base de segurança, deriva de configuração — feita independentemente de qualquer alteração planeada. Uma avaliação de preparação para a migração está circunscrita a uma transição específica, tem um prazo rígido e produz resultados que um health check não produz: um plano de rollback, um registo de riscos da transição e testes de carga sobre o estado de destino, e não apenas sobre o atual.
O que deve abranger o inventário do estado atual?
Todas as filas, exchanges e bindings, e se essa topologia está definida em automação ou existe apenas como configuração manual e não documentada; todos os plugins em uso, incluindo Federation, Shovel e quaisquer plugins personalizados ou desenvolvidos internamente; e a versão da biblioteca cliente e do runtime em cada aplicação que publica ou consome, e não apenas a versão do broker.
O que deve incluir, na prática, um plano de rollback?
Um gatilho definido — a métrica ou condição de falha concreta que determina o abortar — e uma declaração de reversibilidade para cada passo, e não um genérico «restaurar a partir do backup». Na prática, isto costuma significar executar os ambientes antigo e novo em paralelo e migrar os grupos de consumidores por vagas, para que qualquer vaga possa ser reencaminhada de volta sem mexer nas que já correram bem.
Continuamos a precisar de testes de carga se não mudarmos de hardware?
Sim. Uma atualização de versão ou uma alteração de topologia (por exemplo, passar de classic mirrored queues para filas de quórum (quorum queues), ou acrescentar um caminho de replicação para recuperação de desastres) altera o comportamento do broker sob carga, mesmo em hardware idêntico. Teste com o seu débito de pico real e com cenários de recuperação de backlog, e não apenas com tráfego em regime estável.
Quanto tempo demora uma avaliação de preparação para a migração de RabbitMQ?
Normalmente entre uma e três semanas, consoante o número de clusters e a complexidade da topologia. A atualização de um único cluster com um punhado de aplicações consumidoras pode ser delimitada em cerca de uma semana; uma implementação multirregião com Federation, plugins personalizados e dezenas de aplicações consumidoras demora mais a inventariar e a testar devidamente sob carga.
O que costuma tornar uma destas avaliações necessária?
Uma atualização de versão major (sobretudo se alterar os tipos de fila predefinidos ou a compatibilidade com o Erlang), uma mudança de plataforma, por exemplo para Kubernetes ou para um novo centro de dados, uma alteração de arquitetura como acrescentar replicação para recuperação de desastres, ou uma alteração de licenciamento que obrigue a um salto de versão com prazo.

Autor
Talk to an engineer
Need a hand with RabbitMQ?
Senior engineers who run it in production. Get a quote or a free consultation, no sales pitch.
Guias, comparações e estudos


