Auf dieser Seite
Als Erstes sollten Sie wissen, was es nicht gibt: Ein Managed RabbitMQ von Microsoft selbst gibt es auf Azure nicht.
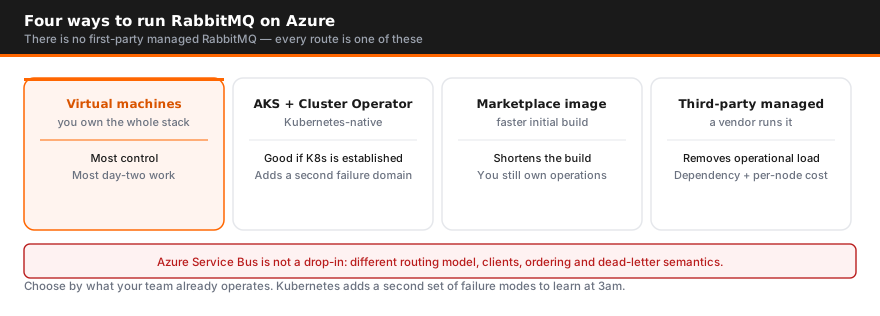
Das native Messaging von Azure besteht aus Service Bus, Event Hubs und Storage Queues. Keiner dieser Dienste ist RabbitMQ, und keiner spricht AMQP 0-9-1 so, wie es RabbitMQ-Clients erwarten. „RabbitMQ auf Azure“ bedeutet daher immer eine von vier Optionen – und die Wahl zwischen ihnen ist eigentlich eine Entscheidung darüber, wo die betriebliche Grenze verlaufen soll.
Die vier Wege
- 1. Virtuelle Maschinen. Sie stellen die VMs bereit, installieren Erlang und RabbitMQ und verantworten Clustering, Storage, Patching und Upgrades. Die meiste Kontrolle und die meiste Arbeit. Für die meisten Teams ohne etablierte Kubernetes-Praxis ist das die risikoärmste Option – die Fehlerbilder sind die von RabbitMQ selbst, und die sind gut verstanden.
- 2. AKS mit dem RabbitMQ Cluster Operator. Der Operator übernimmt sehr viel: Cluster-Bildung, Rolling Updates und Reconciliation. Er passt zu Organisationen, die Kubernetes bereits ordentlich betreiben. Er bedeutet aber auch, dass ein RabbitMQ-Incident jetzt ein Kubernetes-Incident sein kann – Verhalten der Storage Class, Pod Eviction, Node Draining. Es kommt also ein zweites System hinzu, dessen Fehlerbilder Sie ebenfalls kennen müssen.
- 3. Marketplace-Images. Sie verkürzen den initialen Aufbau. An der Verantwortung für den Day-2-Betrieb ändern sie nichts – die liegt weiter bei Ihnen. Prüfen Sie, welche Version das Image ausliefert und wie das Patching vorgesehen ist, bevor Sie es wie ein Managed-Produkt behandeln.
- 4. Managed-Service-Anbieter. Mehrere Anbieter betreiben RabbitMQ für Sie innerhalb von Azure. Das nimmt tatsächlich Betriebslast ab – um den Preis einer Abhängigkeit und einer Abrechnung pro Node, die mit dem Cluster wächst. Lesen Sie, was das SLA tatsächlich zusagt: Reaktion, nicht Lösung.
VMs oder AKS: Nach dem Team entscheiden, nicht nach Trends
Entscheidend ist nicht die technische Eleganz, sondern wer um 3 Uhr nachts wach sein wird.
- AKS ist richtig, wenn Sie Kubernetes bereits in Produktion betreiben, Ihr Team StatefulSets, Persistent Volume Claims und Pod Disruption Budgets versteht und Sie den Cluster Operator ordentlich betreiben können. Dann wird RabbitMQ zu einer weiteren Workload auf einer Plattform, die Sie bereits kennen.
- VMs sind richtig, wenn Kubernetes neu wäre oder zwar existiert, aber niemand wirklich dafür verantwortlich ist. Quorum Queues verzeihen es nicht, wenn ihnen der Storage wegbricht, und ein durch Kubernetes vermitteltes Storage-Problem ist unter Zeitdruck viel schwerer zu diagnostizieren als eine Disk an einer VM.
Den umfassenderen Vergleich finden Sie in RabbitMQ auf EKS vs. AKS vs. GKE, die Mechanik des Deployments in RabbitMQ auf Kubernetes und OpenShift.
Was auf Azure tatsächlich ausfällt
- Storage-Latenz. Die häufigste Ursache unerklärlicher RabbitMQ-Probleme in jeder Cloud. Quorum Queues schreiben auf der Mehrheit ihrer Member auf die Disk – schwankende Disk-Latenz wird so zu langsameren Publishern und im Extremfall zu Leader Elections. Wählen Sie den Storage nach konstanter Latenz statt nach dem Spitzendurchsatz, und messen Sie sie vor dem Go-live statt während eines Incidents.
- Platzierung in Availability Zones. Drei Nodes, die alle in einer Zone gelandet sind, bringen Ihnen die Kosten eines Clusters und die Ausfallsicherheit einer einzelnen Maschine. Verteilen Sie die Member bewusst über Zonen und prüfen Sie die Platzierung nach jeder Skalierung erneut – genau so etwas verschlechtert sich unbemerkt.
- Health Probes des Load Balancers. Probes, die auf den falschen Port zeigen oder kürzere Timeouts haben als der Neustart eines Nodes, werfen Nodes mitten in der Recovery hinaus und machen aus einem Rolling Upgrade einen Ausfall. Prüfen Sie etwas, das die Betriebsbereitschaft tatsächlich widerspiegelt.
- Netzwerkpartitionen. Traffic zwischen Zonen ist weder kostenlos noch unbegrenzt zuverlässig. Legen Sie Ihre Strategie für den Umgang mit Partitionen bewusst fest – ausführlicher behandelt in Hochverfügbarkeit und Cluster-Dimensionierung.
| Was auf Azure ausfällt | Warum | Was zu tun ist |
|---|---|---|
| Storage-Latenz | Quorum Queues schreiben auf der Mehrheit ihrer Member auf die Disk | Nach konstanter Latenz auswählen und vor dem Go-live messen |
| Alle Member in einer Zone | Kosten eines Clusters, Ausfallsicherheit einer einzelnen Maschine | Über Zonen verteilen und nach jeder Skalierung erneut prüfen |
| Timeouts der Health Probes | Probes werfen Nodes mitten im Neustart hinaus | Betriebsbereitschaft prüfen, mit einem Timeout länger als ein Node-Neustart |
| Partitionen zwischen Zonen | Traffic zwischen Zonen ist weder kostenlos noch perfekt | Umgang mit Partitionen bewusst festlegen, nicht per Standardwert |
Service Bus ist kein Drop-in-Ersatz
Das muss klar gesagt werden, weil es in den meisten Architekturreviews auf Azure vorgeschlagen wird: Der Wechsel von RabbitMQ zu Azure Service Bus ist eine Neuentwicklung der Anwendung, keine Migration.
Ein anderes Routing-Modell – keine Exchanges und Bindings, wie RabbitMQ sie kennt. Andere Client-Bibliotheken. Eine andere Semantik bei Reihenfolge, Dead-Lettering und Delivery Count. Jeder Publisher und jeder Consumer muss geändert und neu getestet werden, und alles, was auf RabbitMQ-spezifisches Routing setzt, muss neu entworfen werden.
Das kann trotzdem die richtige Entscheidung sein. Ein Weg, in diesem Quartal den Betrieb eines Brokers zu umgehen, ist es nicht. Den Vergleich der Semantik finden Sie in RabbitMQ vs. Azure Service Bus.
Wenn Sie RabbitMQ auf Azure ordentlich entwerfen, deployen und unterstützen lassen wollen – einschließlich der oben beschriebenen Zonenaufteilung und Storage-Auswahl –, sehen Sie sich an, wie AceMQ RabbitMQ unterstützt, oder nehmen Sie Kontakt auf.
Wenn Sie eigentlich die Semantik von RabbitMQ ohne die Betriebslast wollen, betreiben die Managed Services für RabbitMQ von AceMQ die Broker in Ihrer Azure-Subscription oder auf unserer gehosteten Plattform – die Migration zu Service Bus muss dann gar nicht erst stattfinden.
Die vier Wege, RabbitMQ für sich betreiben zu lassen – gehostete Plattform, Betrieb in Ihrer eigenen Subscription, Hosting durch einen Spezialisten oder Eigenbetrieb mit Support –, stellt Managed-RabbitMQ-Optionen im Vergleich gegenüber.
FAQ
Bietet Azure einen Managed Service für RabbitMQ an?
Nein. Das native Messaging von Azure besteht aus Service Bus, Event Hubs und Storage Queues. RabbitMQ auf Azure zu betreiben heißt, es selbst zu betreiben oder einen Managed Service eines Drittanbieters einzukaufen, der in Azure bereitgestellt wird.
Welche Optionen gibt es tatsächlich?
Virtuelle Maschinen, AKS mit dem RabbitMQ Cluster Operator, Marketplace-Images oder ein Managed-Service-Anbieter, der es innerhalb von Azure betreibt.
VMs oder AKS?
Entscheiden Sie danach, was Ihr Team bereits betreibt. AKS, wenn Kubernetes wirklich etabliert ist; ansonsten VMs, denn Kubernetes bringt eine zweite Reihe von Fehlerbildern mit, die gelernt werden müssen.
Was fällt speziell auf Azure am häufigsten aus?
Storage-Latenz, die die Schreibvorgänge von Quorum Queues stört, eine Platzierung in Availability Zones, bei der alle Member in einer Zone landen, und Health Probes des Load Balancers, die Nodes in der Recovery hinauswerfen.
Sollten wir stattdessen Azure Service Bus verwenden?
Nur wenn die Semantik wirklich passt. Es ist eine Neuentwicklung der Anwendung – anderes Routing-Modell, andere Clients, anderes Verhalten bei Reihenfolge und Dead-Lettering –, kein Lift-and-Shift.
Kann AceMQ das für uns betreiben?
Ja – Design, Deployment und 24/7-Support für RabbitMQ auf Azure, auf VMs oder AKS, einschließlich Zonenaufteilung, Storage-Auswahl und Upgrade-Pfaden.
Auf AWS lautet dieselbe Entscheidung Amazon MQ oder selbst gehostetes RabbitMQ: Amazon MQ oder selbst gehostetes RabbitMQ mit Support? vergleicht die monatlichen Kosten in drei Größen, die Limits und den Upgrade-Pfad von 3.13 auf 4.
Autor
Mit einem Engineer sprechen
Brauchen Sie Unterstützung bei RabbitMQ?
Senior Engineers, die es selbst in Produktion betreiben. Fordern Sie ein Angebot oder ein kostenloses Erstgespräch an – ganz ohne Verkaufsgespräch.
Leitfäden, Vergleiche und Studien
Mehr zum Thema RabbitMQ
Leitfäden
16- Leitfaden zum RabbitMQ-Performance-Tuning
- Der Leitfaden zu RabbitMQ Streams
- Der RabbitMQ-Zuverlässigkeitsleitfaden: zehn Fehlermuster und ihre Lösungen
- Der Leitfaden zu RabbitMQ Disaster Recovery
- Der Leitfaden für RabbitMQ-Clustering und -Sizing
- Der Leitfaden zu RabbitMQ auf Kubernetes
10 weitere anzeigenWeniger anzeigen
- Der RabbitMQ-Migrationsleitfaden, 2026
- Leitfaden zu RabbitMQ-Sicherheit und -Härtung
- Leitfaden zu RabbitMQ Monitoring und Alerting
- RabbitMQ für KI-Agenten: Patterns, Setup und Fallstricke
- Celery und RabbitMQ für LLM-Task-Queues
- Agent-to-Agent-Messaging über AMQP und RabbitMQ
- RabbitMQ-Erlang-Kompatibilität: Matrix zu Version, Erlang und Patch-Verantwortlichem
- RabbitMQ 3.x auf 4.x: Upgrade-Runbook
- RabbitMQ-Schulung: Lehrplan mit Workshop-Modulen, Voraussetzungen und Labs
- Die RabbitMQ-Support-Wissensdatenbank von AceMQ: Inhalte und Nutzung
Vergleiche
9- Community RabbitMQ, Tanzu RabbitMQ oder Drittanbieter-Support?
- Die besten RabbitMQ-Support-Anbieter im Vergleich (2026)
- RabbitMQ vs. Amazon SQS im Vergleich
- RabbitMQ vs. Redis im Vergleich
- RabbitMQ-Anbieter im Vergleich: Amazon MQ, CloudAMQP, Stackhero, Northflank, Tanzu und AceMQ
- Support-Optionen für Message Broker im Vergleich